
 Asistente de guiones▸
 Apps AI
 Noticias AI
FantasyPortrait: animación facial emocional multi-personaje a partir de una única imagen estática
小编 ·

FantasyPortrait: animación facial emocional multi-personaje a partir de una única imagen estática
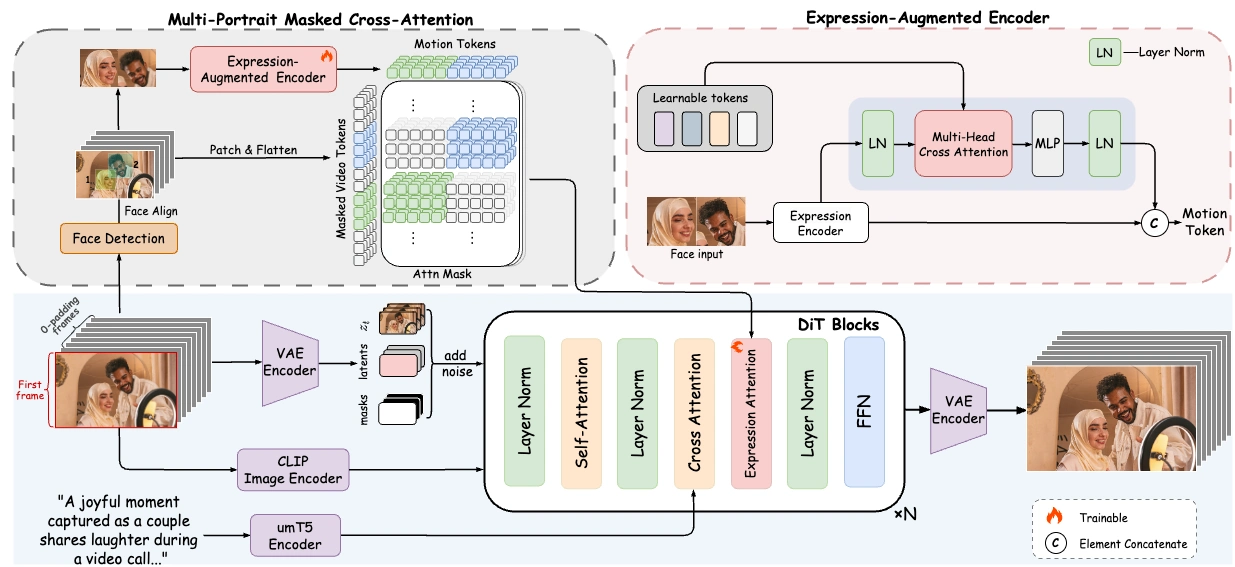
FantasyPortrait es un marco desarrollado conjuntamente por el equipo de AutoNavi (Amap) de Alibaba y la Universidad de Correos y Telecomunicaciones de Pekín, capaz de generar animaciones faciales emocionales con múltiples personajes a partir de una única imagen estática. Extrae expresiones complejas mediante características implícitas, sustituyendo los priors geométricos tradicionales, mejora la capacidad de transferencia entre identidades y utiliza un mecanismo de atención cruzada con máscaras para evitar interferencias entre las características de distintos personajes. Además, admite la adaptación de personajes en múltiples estilos, la generación de animaciones de animales sin entrenamiento previo (zero-shot) y la animación guiada por audio con bajos recursos, siendo aplicable en campos como humanos digitales, ídolos virtuales y NPC de videojuegos. El código es de código abierto en GitHub.
Funcionalidades principales
✅ Aprendizaje implícito mejorado de expresiones: extrae expresiones complejas, como movimientos labiales y expresiones emocionales, mediante características implícitas, sustituyendo los priors geométricos explícitos tradicionales, mejorando la capacidad de transferencia entre identidades.
✅ Mecanismo de atención cruzada con máscaras: crea áreas independientes de control de expresiones para cada personaje, evitando interferencias entre características y logrando una animación coordinada de "un personaje, un canal".
✅ Escalabilidad multimodal: admite control mediante texto y audio; por ejemplo, utiliza Whisper para codificar audio y generar animación de labios, requiriendo solo una pequeña cantidad de datos para ajustarse a múltiples idiomas.
✅ Conjunto de datos y benchmark de evaluación: se han construido el conjunto de datos Multi-Expr (más de 30 000 vídeos de alta calidad con múltiples personajes) y el benchmark ExprBench, promoviendo la estandarización del sector.
En cuanto al diseño del método:
✅ Estrategia de entrenamiento en dos fases: primero codifica las características de expresión mediante UNet y, a continuación, decodifica la secuencia de animación mediante un transformador de difusión.
✅ Módulo de control multi-personaje: aísla las señales de conducción de distintos personajes mediante máscaras de características, manteniendo la coherencia temporal.
Conjunto de datos y benchmark de evaluación:
✅ Conjunto de datos Multi-Expr: contiene más de 500 000 fotogramas de datos de expresiones con múltiples vistas; es el primer conjunto de datos de animación multi-personaje.
✅ Benchmark de evaluación ExprBench: utilizado para entrenar y evaluar animaciones de retratos multi-personaje.
Los resultados experimentales muestran que:
✅ Tarea de re-actuación cruzada: en comparación con métodos como StyleHEAT y PIRender, la métrica FID mejora un 41,7 %.
✅ Escenario de generación de animación multi-personaje: la tasa de preferencia del usuario alcanza el 83,5 %, generando con precisión expresiones sutiles como micro-temblores en los ojos y movimientos asimétricos en las comisuras de la boca.
Los escenarios de aplicación incluyen:
✅ Animación multi-personaje: admite el uso de varios vídeos de una sola persona o un único vídeo de varias personas para controlar múltiples personajes, generando expresiones detalladas y animaciones de retrato realistas.
✅ Estilos de personajes diversos: puede generar animaciones dinámicas, expresivas, naturales y realistas en diversos estilos.
✅ Animación de animales: aunque no se ha entrenado explícitamente con conjuntos de datos de animales, tiene una gran capacidad de generalización en tareas de animación animal.
✅ Animación de retratos guiada por audio: mediante la codificación de audio y una red basada en Transformer, mapea las características de audio a representaciones potenciales de conducción, logrando animación de retratos guiada por audio, con una buena alineación audio-vídeo incluso con un número reducido de muestras de entrenamiento.
Respuestas a preguntas clave:
¿Cuáles son los avances técnicos?
Respuesta: En primer lugar, un control implícito de expresión mejorado, que aprende características de expresión de grano fino mediante representaciones faciales implícitas, mejorando la capacidad de modelado de movimientos bucales y expresiones emocionales; en segundo lugar, la atención cruzada con máscaras multi-personaje, un mecanismo innovador de atención cruzada con máscaras que permite el control independiente y la generación coordinada de múltiples personajes, resolviendo el problema de la interferencia de características entre personajes.
¿Cuáles son las características funcionales?
Respuesta: Incluyen la conducción sincronizada de múltiples personajes, que admite el uso de uno o varios vídeos de una sola persona, o un vídeo de varias personas, para controlar de forma sincronizada a múltiples personajes; la adaptación de personajes en múltiples estilos, capaz de generar vídeos dinámicos, fluidos, vivos, naturales y con un estilo coherente para personajes de distintos estilos artísticos; la animación de animales sin entrenamiento previo (zero-shot), con una capacidad de generación sobresaliente sin entrenamiento específico; y la animación guiada por audio con bajos recursos, ampliable como marco guiado por audio, que utiliza Whisper para codificar el audio y mapea las características de audio al espacio potencial de conducción mediante una red Transformer ligera.
¿Cuál es su valor de aplicación?
Respuesta: En la producción audiovisual, permite a animadores independientes generar fácilmente interpretaciones de escenas corales; en el sector de los videojuegos, permite a los NPC mostrar micro-expresiones únicas; en el直播 virtual (livestreaming virtual), permite que las interacciones entre múltiples personajes sean más vivas y naturales.
Información de código abierto:
Repositorio de GitHub: https://github.com/Fantasy-AMAP/fantasy-portrait
Sitio web oficial del proyecto: https://fantasy-amap.github.io/fantasy-portrait/









