
 Asistente de guiones▸
 Apps AI
 Noticias AI
MuseSteamer: el modelo de generación de vídeo con IA desarrollado por Baidu
小编 ·

MuseSteamer: el modelo de generación de vídeo con IA desarrollado por Baidu
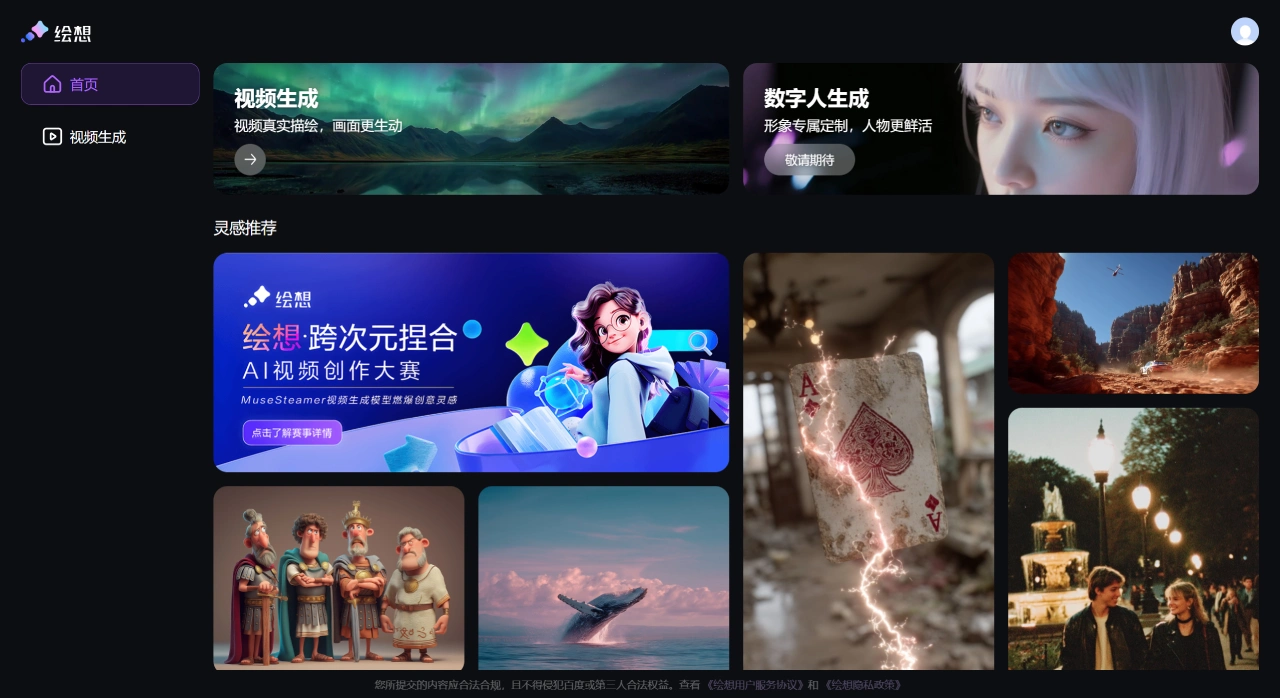
MuseSteamer es el modelo de generación de vídeo lanzado por Baidu el 2 de julio de 2025. Es capaz de generar simultáneamente imágenes, efectos de sonido y diálogos, siendo el primer modelo en lograr la generación integrada de audio y vídeo en chino, cambiando el modelo tradicional de aiGC de vídeo donde primero se genera la imagen y luego se realiza la locución. Baidu también lanzó simultáneamente la plataforma de creación de vídeo con IA "Huixiang".
Características:
Generación integrada de audio y vídeo: el primer modelo de vídeo del mundo en lograr la generación integrada de audio y vídeo en chino, capaz de lograr la creación coordinada de imágenes, efectos de sonido y voces de diálogo, rompiendo el proceso fragmentado tradicional de vídeo AIGC de "imagen primero, locución después".
Entrada multimodal: admite entradas de texto en chino, imágenes de referencia, entre otras.
Generación de vídeo: puede generar vídeos dinámicos de hasta 10 segundos de duración, con excelente calidad de imagen, control flexible de escenas, acciones y movimientos de cámara, logrando una integración de audio y vídeo. Por ejemplo, en los vídeos de artes marciales de época generados, los movimientos y expresiones de los personajes son naturales y los movimientos de cámara son profesionales.
Generación integrada: puede generar simultáneamente imágenes, efectos de sonido y diálogos, con una coincidencia natural entre el sonido y la imagen, mejorando la integridad y la expresión artística del vídeo.
Comprensión semántica en chino: comprende con precisión la semántica del chino, asegurando la alineación semántica entre las instrucciones de texto y los elementos visuales mediante la optimización del sistema de datos.
Lenguaje de descripción de vídeo: adopta un lenguaje de descripción estructurada de vídeo refinado, que cubre detalles de la imagen, trayectorias de movimiento del sujeto, atributos de estilo y lenguaje de cámara, garantizando el cumplimiento de los detalles de la imagen por parte del modelo.
Avances técnicos:
Limpieza de datos multimodales en chino a nivel de cientos de millones: limpieza profunda de grandes cantidades de datos multimodales en chino, garantizando la alta calidad de los datos de entrenamiento.
Lenguaje de descripción estructurada de vídeo refinado: mejora la capacidad del modelo para comprender y generar contenido de vídeo.
Aprendizaje por refuerzo multiobjetivo: optimiza las rutas para garantizar la amplitud de movimiento del vídeo mientras se mantiene una salida estable y consistente del contenido principal.
Matriz de productos y público objetivo:
Versión Lite: 720p, velocidad de generación rápida (30 segundos), precio económico, adecuada para usuarios que buscan una buena relación calidad-precio.
Versión Turbo: 720p, especializada en la generación de vídeos de personajes y animación, con buena consistencia de movimiento, gran amplitud de movimiento y expresiones naturales, adecuada para la mayoría de los creadores; ya está disponible en la plataforma Huixiang con una beta pública gratuita por tiempo limitado.
Versión Pro: 1080p, calidad de imagen y movimientos de cámara de nivel cinematográfico, con gran expresividad, adecuada para creadores profesionales y productoras audiovisuales.
Versión con audio: admite la generación integrada de efectos de sonido y diálogos en todas las resoluciones, adecuada para usuarios con altos requisitos de sonido directo e imagen.
Escenarios de aplicación:
Creación de vídeo: ayuda a los creadores a superar los bloqueos creativos y generar rápidamente vídeos de alta calidad.
Producción publicitaria: proporciona soluciones eficientes para la producción de vídeos publicitarios, aumentando su atractivo.
Educación y formación: genera vídeos educativos y animaciones para explicar conceptos complejos de forma intuitiva.
Entretenimiento personal: los usuarios pueden subir imágenes para generar vídeos personalizados y compartir sus historias personales.









