
 Asistente de guiones▸
 Apps AI
 Noticias AI
XVerse: herramienta de código abierto de ByteDance para síntesis de imágenes con múltiples sujetos
小编 ·

XVerse: herramienta de código abierto de ByteDance para síntesis de imágenes con múltiples sujetos
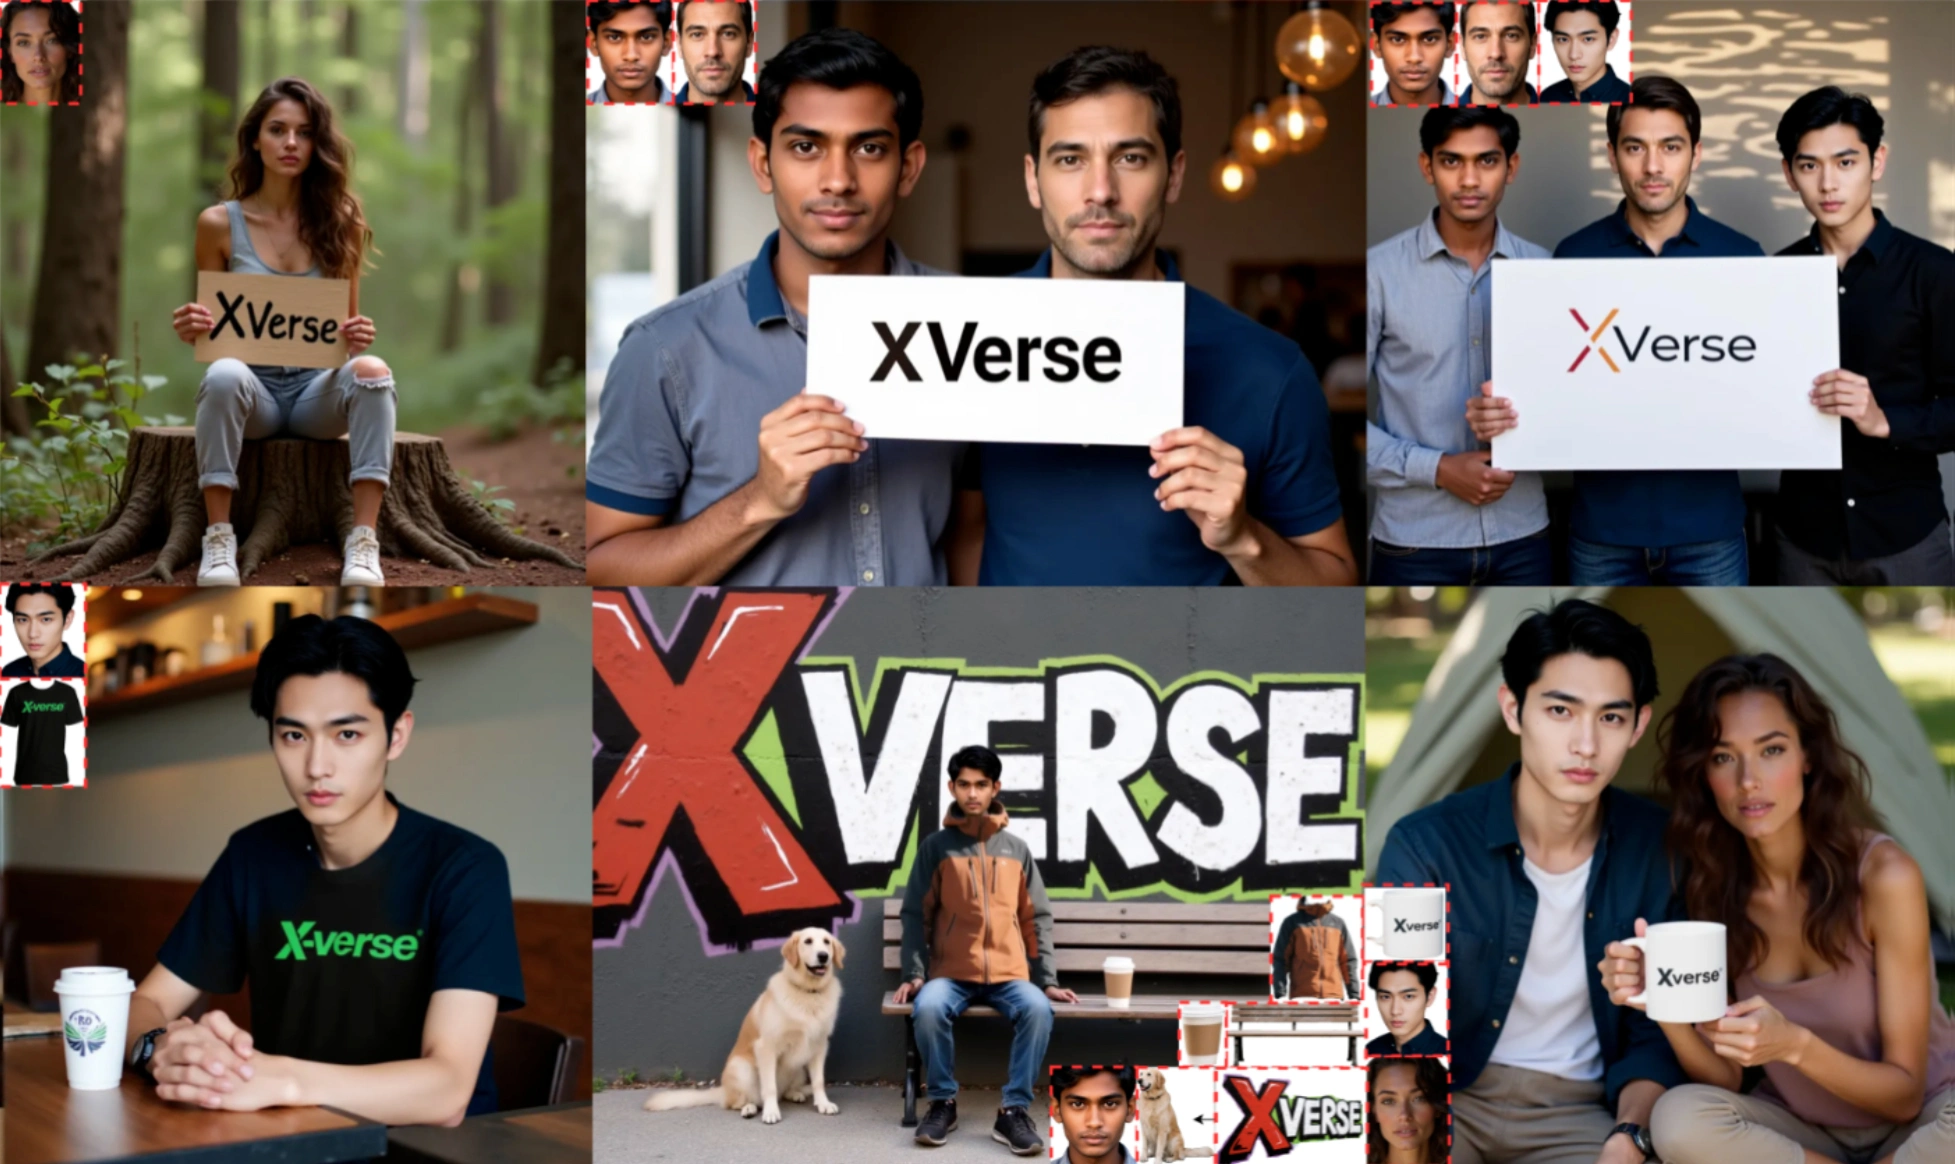
XVerse es una herramienta de síntesis de imágenes con múltiples sujetos lanzada por ByteDance, que permite generar imágenes con múltiples sujetos con alta precisión. Gracias a que los usuarios pueden controlar de forma independiente y precisa varios sujetos, mejora enormemente la capacidad de generación en escenas complejas.
Funciones principales
Control de múltiples sujetos: XVerse convierte las imágenes de referencia en desplazamientos modulados por flujo de texto, controlando con precisión las características de identidad de cada sujeto y ajustando de forma independiente atributos semánticos (pose, estilo, iluminación, etc.). Esto resuelve los problemas habituales de confusión de identidades y entrelazado de atributos de los modelos tradicionales en escenas con múltiples sujetos, logrando una síntesis de imágenes con múltiples sujetos de alta fidelidad y editable.
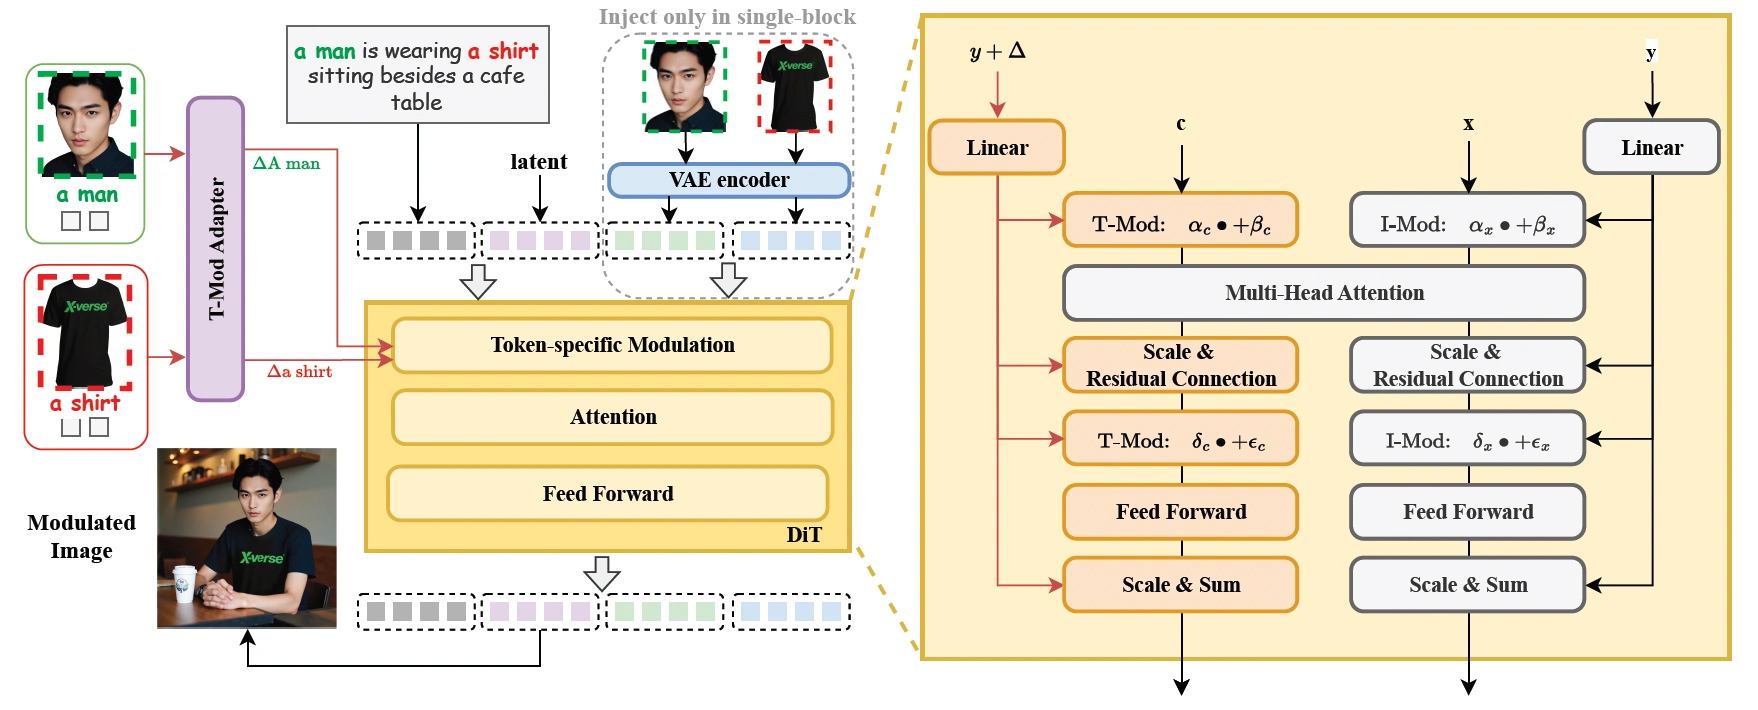
Modulación mejorada por flujo de texto: mediante la combinación de las características de la imagen de referencia con las características del prompt de texto para generar desplazamientos, y su inyección en las incrustaciones de tokens de texto específicos, XVerse logra un control preciso sobre cada sujeto, manteniendo al mismo tiempo la estructura global de la imagen generada y permitiendo ajustes finos de los detalles.
Características de imagen codificadas por VAE: XVerse introduce características de imagen codificadas por VAE como entrada auxiliar, inyectadas en un único bloque de los DiTs. Esto ayuda a captar y reproducir la información de detalle de la imagen, evitando los artefactos y la pérdida de calidad que podría provocar la inyección directa de características de imagen.
Técnicas de regularización: se adopta una pérdida de preservación de regiones para forzar al modelo a mantener la coherencia en las regiones no moduladas, diferenciando y preservando las características de cada sujeto. Mediante la pérdida de atención texto-imagen, se alinean los mapas de atención cruzada entre el modelo modulado y la rama T2I de referencia, garantizando la coherencia y editabilidad de las interacciones semánticas durante el proceso de modulación.
Principios técnicos de XVerse
Mecanismo de modulación por flujo de texto: XVerse convierte la imagen de referencia en desplazamientos de modulación por flujo de texto específicos por token, que se añaden a las incrustaciones de texto del modelo, logrando así un control preciso sobre un sujeto concreto sin interferir en las variables latentes ni en las características de la imagen.
Módulo de características de imagen codificadas por VAE: para mejorar la capacidad de preservación de detalles en la imagen generada, XVerse incorpora un módulo de características de imagen codificadas por VAE. Este módulo actúa como auxiliar, ayudando al modelo a retener más información de detalle durante la generación, reduciendo artefactos y distorsiones.
Técnicas de regularización: a partir de la inyección de modulación con preservación aleatoria de un lado, se fuerza al modelo a mantener la coherencia en las regiones no moduladas. Se regularizan las características específicas de cada sujeto como estrategia de aumento de datos para conjuntos de datos con múltiples sujetos, mejorando la capacidad del modelo para diferenciar y preservar las características de los sujetos en escenas con múltiples sujetos. Mediante el cálculo de la pérdida L2 entre los mapas de atención cruzada texto-imagen del modelo modulado y de la rama T2I de referencia, se garantiza que el modelo modulado mantenga patrones de atención coherentes con la rama T2I, preservando la coherencia y editabilidad de las interacciones semánticas.
Escenarios de aplicación
Creación de contenido digital: XVerse ayuda a los creadores a controlar con precisión varios sujetos, y se puede utilizar para dibujar cómics, crear ilustraciones de historias, construir escenas virtuales complejas, etc., haciendo que las obras sean más vívidas, ricas e imaginativas.
Sector publicitario: XVerse permite controlar con precisión los atributos de cada sujeto, garantizando la alta fidelidad y coherencia de las imágenes publicitarias, haciendo que los anuncios sean más llamativos y mejorando el efecto de difusión.
Ámbito artístico: ofrece a los artistas una nueva herramienta creativa que supera las limitaciones de la creación tradicional, permitiendo crear obras de arte únicas y expresivas.
Cómo utilizar XVerse
Los usuarios deben crear un entorno conda con Python 3.10.16, instalar las dependencias y descargar los checkpoints y el modelo de reconocimiento facial correspondientes. La interfaz de usuario es amigable y ofrece abundantes opciones de configuración de entrada, incluida la función "Detección y segmentación", que puede analizar las imágenes cargadas, recortar automáticamente las caras y generar descripciones. Además, ofrece una demo interactiva en Gradio, donde los usuarios pueden cargar imágenes, introducir descripciones y generar imágenes en tiempo real, optimizando los resultados ajustando los parámetros.
Dirección del proyecto
Sitio web oficial del proyecto:https://bytedance.github.io/XVerse/
Repositorio en GitHub:https://github.com/bytedance/XVerse
Carga de modelos en HuggingFace:https://huggingface.co/ByteDance/XVerse
Artículo técnico en arXiv:https://arxiv.org/pdf/2506.21416









