
 Asistente de guiones▸
 Apps AI
 Noticias AI
Alibaba Ovis-U1: un modelo que une comprensión multimodal, generación y edición de imágenes
小编 ·

Alibaba Ovis-U1: un modelo que une comprensión multimodal, generación y edición de imágenes
El 29 de junio de 2025, el equipo de ai internacional de Alibaba presentó Ovis-U1, un modelo multimodal de gran tamaño que constituye la versión más reciente de la serie Ovis. Desarrollado sobre la arquitectura original, cuenta con un tamaño de parámetros de 300 millones.
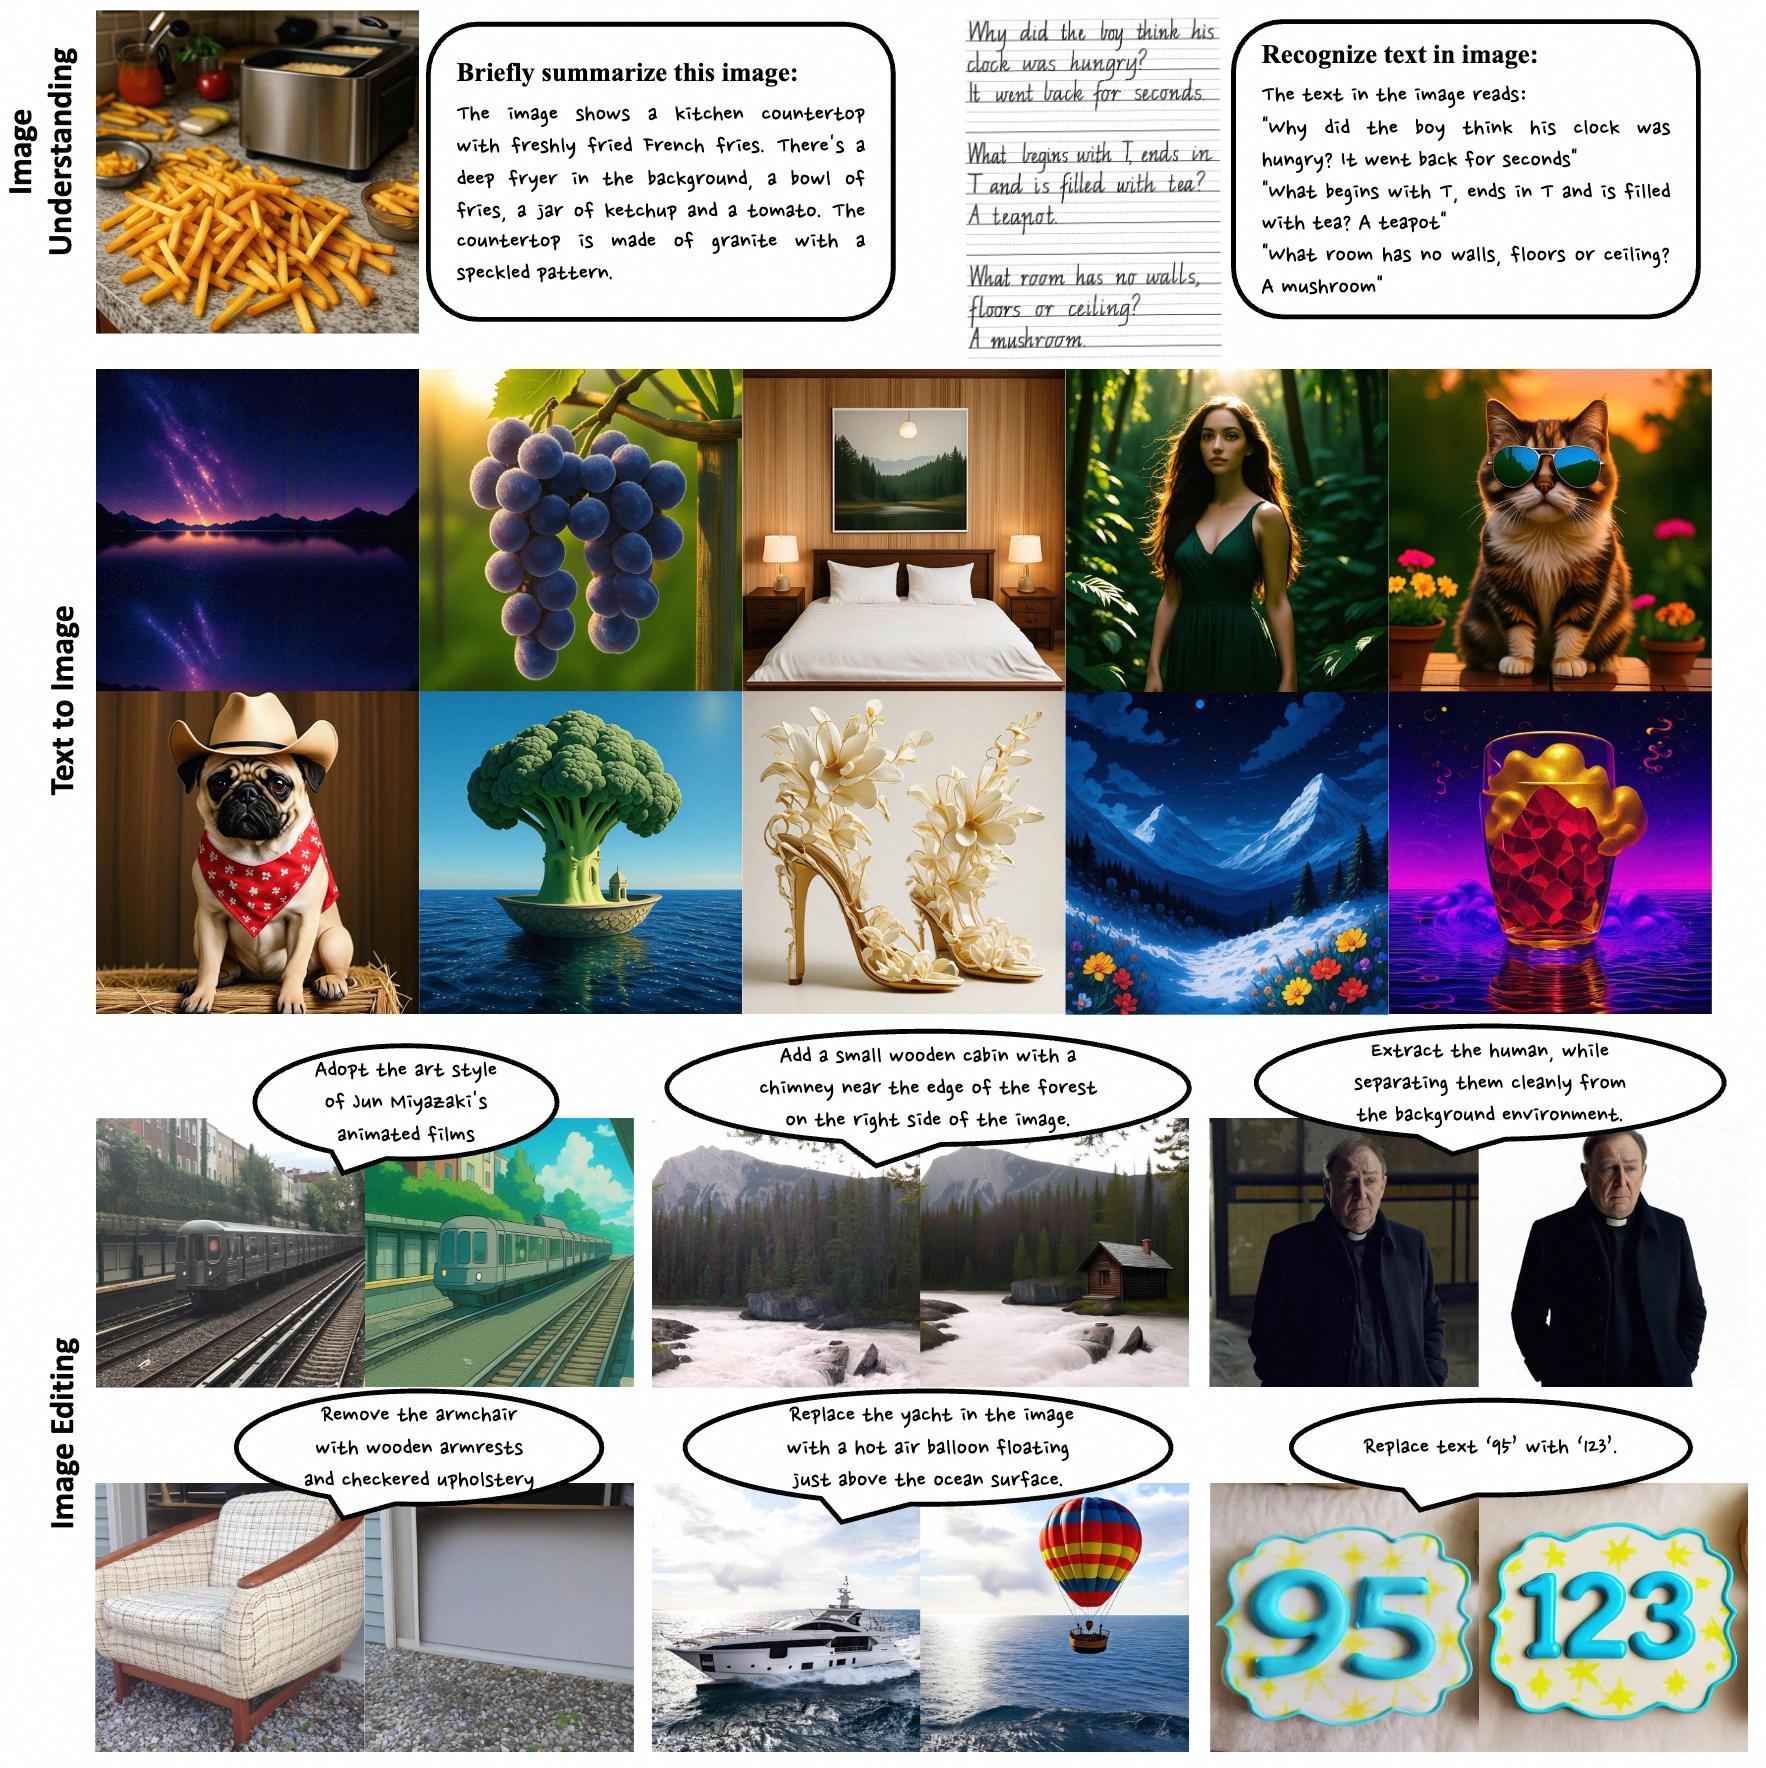
El modelo integra funciones de comprensión multimodal, generación y edición de imágenes. Sus componentes principales incluyen un tokenizador visual, una tabla de incrustaciones visuales y un modelo de lenguaje de gran tamaño. Mediante la optimización de la correspondencia entre las incrustaciones visuales y textuales, resuelve algunas de las limitaciones de los modelos multimodales tradicionales, logrando un mejor rendimiento en escenarios complejos. Admite entradas de texto e imagen, con resultados destacados en tareas como razonamiento matemático y reconocimiento de objetos. Puede identificar con precisión objetos o texto manuscrito en imágenes, así como generar o modificar imágenes siguiendo instrucciones.
Capacidades principales
Comprensión multimodal: capaz de analizar escenas visuales complejas y contenido textual, responder preguntas relacionadas con imágenes y completar tareas como respuesta visual a preguntas (VQA) y generación de descripciones de imágenes.
Generación de texto a imagen: genera imágenes de alta calidad a partir de descripciones textuales, adaptándose a diversos estilos y necesidades de escenas complejas.
Edición de imágenes: permite añadir, ajustar, reemplazar o eliminar elementos de la imagen mediante instrucciones textuales, además de admitir conversión de estilos.
Arquitectura técnica
Decodificador visual: adopta una arquitectura Transformer basada en difusión (MMDiT), que transforma las incrustaciones textuales en imágenes de alta calidad.
Refinador bidireccional de tokens: refuerza la interacción entre las incrustaciones textuales y visuales, mejorando los efectos de síntesis y edición de imágenes.
Codificador visual: ajustado fino a partir de modelos preentrenados (como Aimv2-large-patch14-448), adaptándose a tareas multimodales.
Adaptador: conecta el codificador visual con el modelo de lenguaje de gran tamaño multimodal (MLLM), alineando ambos tipos de datos de incrustación.
Modelo de lenguaje de gran tamaño multimodal: actúa como módulo central, procesa información textual y visual y admite el procesamiento multitarea.
Método de entrenamiento
Ovis-U1 entrena de forma sincronizada las tareas de comprensión multimodal, generación y edición de imágenes, compartiendo conocimiento para mejorar la capacidad de generalización. El entrenamiento se divide en seis etapas para optimizar progresivamente el rendimiento de cada tarea.
Composición de los datos
Datos de comprensión multimodal: procedentes de conjuntos de datos públicos como COYO, Wukong, Laion, así como de datos de desarrollo interno.
Datos de generación de imágenes: basados en los conjuntos de datos Laion5B y JourneyDB, junto con descripciones detalladas generadas por modelos preentrenados.
Datos de edición de imágenes: abarcan datos de tareas como generación guiada por imagen de referencia y control a nivel de píxel.
Optimización del rendimiento
En la edición de imágenes, se ajustan los coeficientes de guía de texto e imagen (CFG) para controlar con precisión la ejecución de las instrucciones. Se aplican pruebas de referencia como OpenCompass y GenEval para evaluar de forma integral las capacidades del modelo.
Escenarios de aplicación
Creación de contenidos: ayuda a artistas y editores de vídeo en la concepción creativa.
Publicidad y marketing: genera imágenes y carteles publicitarios a partir de descripciones de productos y público objetivo.
Desarrollo de videojuegos: genera escenas, personajes y objetos de juego.
Diseño arquitectónico: produce conceptos arquitectónicos y propuestas de distribución interior.
Investigación científica: visualiza fenómenos científicos complejos y escenarios experimentales.
Siguiendo la tradición de código abierto de la serie Ovis, el código del modelo, los pesos y los datos de entrenamiento se han publicado bajo la licencia Apache2.0 en Hugging Face y GitHub, lo que permite a los desarrolladores reproducir e implementar rápidamente.
Direcciones del proyecto
Repositorio en GitHub:https://github.com/AIDC-AI/Ovis-U1
Biblioteca de modelos en HuggingFace:https://huggingface.co/AIDC-AI/Ovis-U1-3B
Artículo técnico:https://github.com/AIDC-AI/Ovis-U1/blob/main/docs/Ovis_U1_Report.pdf
Prueba en línea:https://huggingface.co/spaces/AIDC-AI/Ovis-U1-3B









