
 Asistente de guiones▸
 Apps AI
 Noticias AI
DreamActor-H1: genera vídeos de personas presentando productos, ideal para clips promocionales
小编 ·

DreamActor-H1: genera vídeos de personas presentando productos, ideal para clips promocionales
DreamActor-H1 es un framework de generación de vídeo lanzado por ByteDance en junio de 2025. Se basa en la tecnología de transformadores de difusión (DiT) y está orientado principalmente al sector del comercio electrónico y al marketing digital, donde se puede utilizar para generar vídeos promocionales de productos.
Este framework es capaz de generar vídeos de demostración de alta calidad con personas y productos a partir del emparejamiento de imágenes de cuerpos humanos y productos. Ha sido entrenado con augmentaciones multiclase sobre un conjunto de datos mixto a gran escala, y supera a los métodos existentes en la preservación de la identidad tanto de las personas como de los productos, así como en la generación de movimientos de demostración coherentes con las leyes de la física, lo que lo hace ideal para publicidad personalizada de comercio electrónico y medios interactivos. Se apoya en plantillas de mallas corporales 3D y en cajas delimitadoras de productos para ofrecer una guía precisa del movimiento, combinando una guía de apariencia codificada mediante VAE, semántica a nivel de categoría codificada con texto estructurado, así como mecanismos de atención de referencia y atención al objeto, resolviendo los problemas de los frameworks actuales en la preservación de identidad y la comprensión de relaciones espaciales.
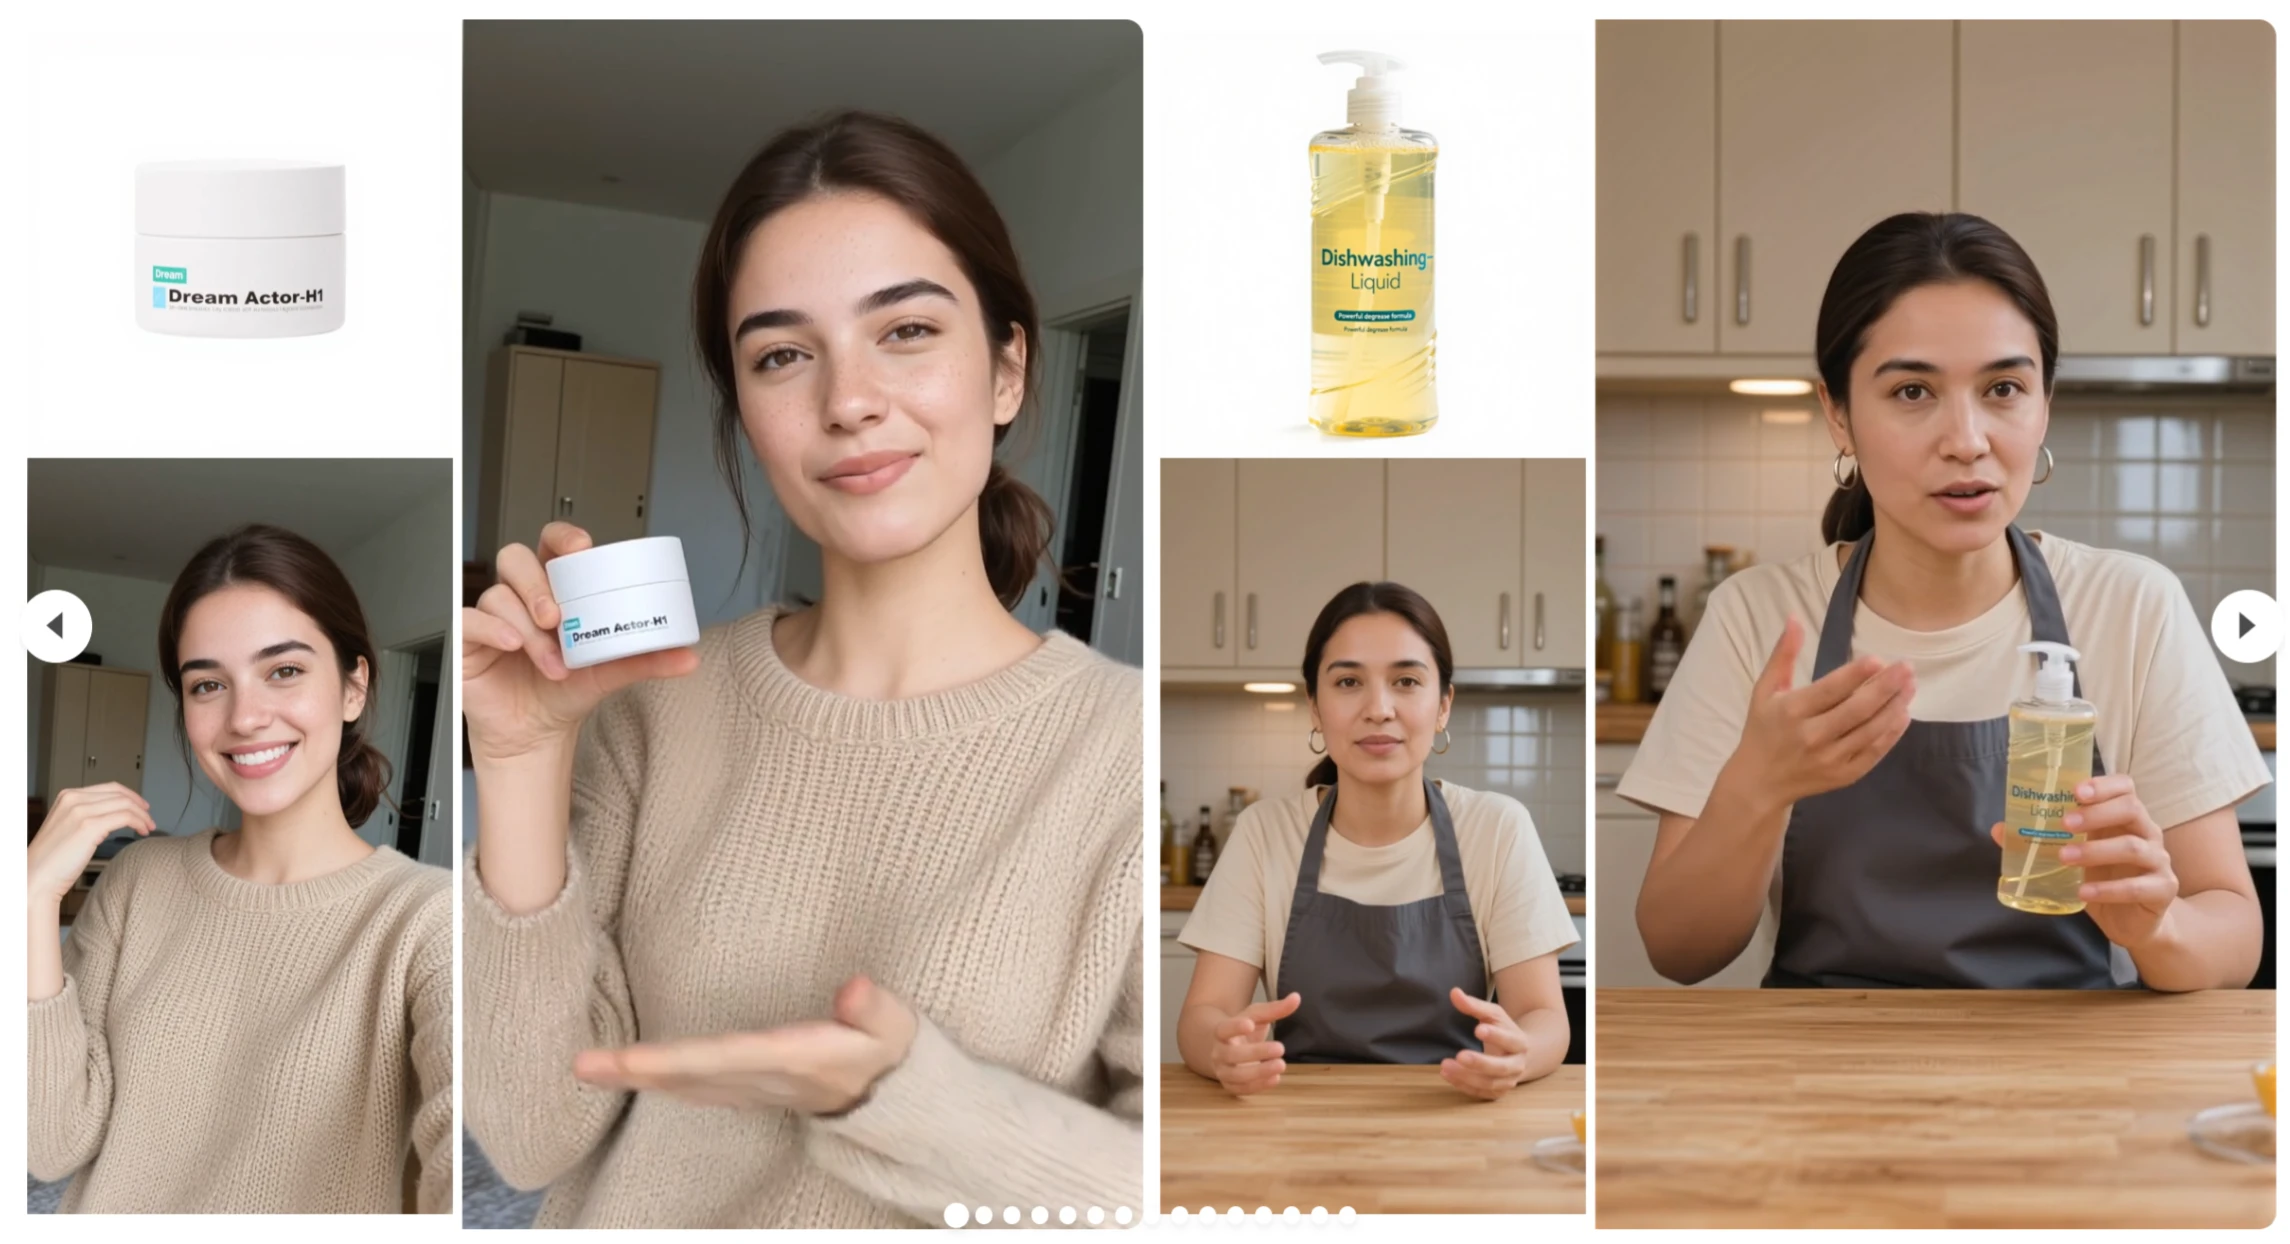
Ventajas principales de DreamActor-H1:
Alineación dinámica persona-objeto: es capaz de hacer coincidir automáticamente los gestos con la posición del producto. Por ejemplo, al demostrar "coger un cosmético", el punto de contacto entre los dedos y el bote se ajusta de forma natural, sin que se produzcan penetraciones ni desplazamientos. Además, admite guiar el movimiento con una combinación de plantillas de malla corporal 3D y cajas delimitadoras del producto, garantizando que los movimientos respeten las leyes físicas, como la gravedad o el ángulo de agarre.
Fidelidad de detalles en múltiples dimensiones: en lo que respecta a la consistencia de la identidad de la persona, es capaz de preservar rasgos como el peinado o el tono de piel; en cuanto al producto, permite reproducirlo con gran exactitud, representando con precisión detalles como la textura del material o los logotipos.
Coherencia tridimensional mejorada semánticamente: combinada con descripciones de texto a nivel de categoría, como "girar para mostrar una barra de labios", consigue que las imágenes en pequeñas rotaciones sean más fluidas, evitando temblores o deformaciones del producto.
Principios técnicos:
Fase de procesamiento de datos: el modelo visión-lenguaje (VLM) interpreta las instrucciones de texto, por ejemplo "sostener y girar un teléfono". A continuación, genera el esqueleto de la persona mediante estimación de pose y, en combinación con la caja delimitadora del producto, construye la relación espacial para extraer las características de movimiento.
Diseño de la arquitectura del modelo: la atención全局负责控制整体画面的时序连贯性;参考注意力会注入人物或商品参考图的特征;物体注意力专门处理商品的潜在特征,保证细节不丢失。三重注意力机制的扩散变换器(DiT)基于70亿参数的基础模型Seaweed - 7B,通过掩码交叉注意力来融合人与物的信息。
Optimización de la inferencia: realiza una búsqueda dinámica en una biblioteca predefinida de plantillas de movimiento y ajusta la escala de la caja del objeto, por ejemplo, se puede ampliar la caja de un producto de pequeño tamaño.
Escenarios de aplicación de DreamActor-H1:
Livestreaming de comercio electrónico: permite generar automáticamente vídeos de demostración de presentadores virtuales sosteniendo productos, reduciendo así los costes del streaming y mejorando su eficiencia.
Publicidad y marketing: posibilita la producción a bajo coste de animaciones de uso del producto desde múltiples ángulos, como por ejemplo mostrar un modelo de zapato girando, para atraer la atención del consumidor.
Limitaciones de DreamActor-H1:
Restricciones de producto: actualmente solo admite objetos de tamaño pequeño o mediano; no es capaz de procesar grandes electrodomésticos, entre otros.
Dependencia de plantillas de movimiento: requiere definir previamente las acciones, como "recoger un objeto de la mesa", y depende de la coincidencia con la pose inicial de la persona.
Defectos dinámicos: durante movimientos rápidos, la textura del producto puede presentar parpadeos.
Flujo para generar vídeos promocionales con DreamActor-H1:
Preparación del material: prepara una imagen de la persona y otra del producto. Se recomienda elegir para la persona una foto de medio cuerpo de frente, con una resolución superior a 800 * 800, para garantizar que las características de la persona se vean nítidas en el vídeo generado. La imagen del producto debe mostrar con claridad los diversos detalles, como la marca o las texturas.
Introducción de la instrucción de texto: en función de las necesidades del vídeo promocional, introduce una descripción de texto a nivel de categoría, por ejemplo "sostener y girar un teléfono" o "mostrar los detalles de una barra de labios", para proporcionar a la generación de vídeo acciones y requisitos de exhibición concretos.
Generación del vídeo: introduce los materiales preparados y las instrucciones de texto en el sistema DreamActor-H1, el cual los procesará basándose en una arquitectura colaborativa multifase y un mecanismo de atención mixto. En la fase de procesamiento de datos, el modelo visión-lenguaje (VLM) interpreta la instrucción de texto, y el módulo de extracción de características de movimiento genera el esqueleto de la persona mediante estimación de pose y, en combinación con la caja delimitadora del producto, construye la relación espacial; dentro de la arquitectura del modelo, la atención global, la atención de referencia y la atención al objeto trabajan de forma conjunta, dando como resultado final un vídeo de demostración de interacción persona-producto con alta fidelidad.
Las direcciones del proyecto son las siguientes:
Página del proyecto:https://submit2025-dream.github.io/DreamActor-H1/
Artículo técnico:https://arxiv.org/abs/2506.10568









