
 Asistente de guiones▸
 Apps AI
 Noticias AI
TableRAG: un framework de generación aumentada por recuperación diseñado para la comprensión de tablas
小编 ·

TableRAG: un framework de generación aumentada por recuperación diseñado para la comprensión de tablas
TableRAG es un marco diseñado para resolver los problemas de pérdida de información estructural y falta de perspectiva global en preguntas y respuestas sobre documentos heterogéneos. Combina la ejecución de SQL y la recuperación de texto, lo que permite comprender de forma unificada los datos tabulares y realizar operaciones complejas. Este marco incluye la construcción de una base de datos offline y un proceso de razonamiento iterativo online de cuatro pasos. En el nuevo benchmark HeteQA y en otros benchmarks públicos, TableRAG muestra un rendimiento excelente, superando a los métodos RAG y programáticos existentes, y se convierte en una solución avanzada para el razonamiento complejo sobre documentos heterogéneos.
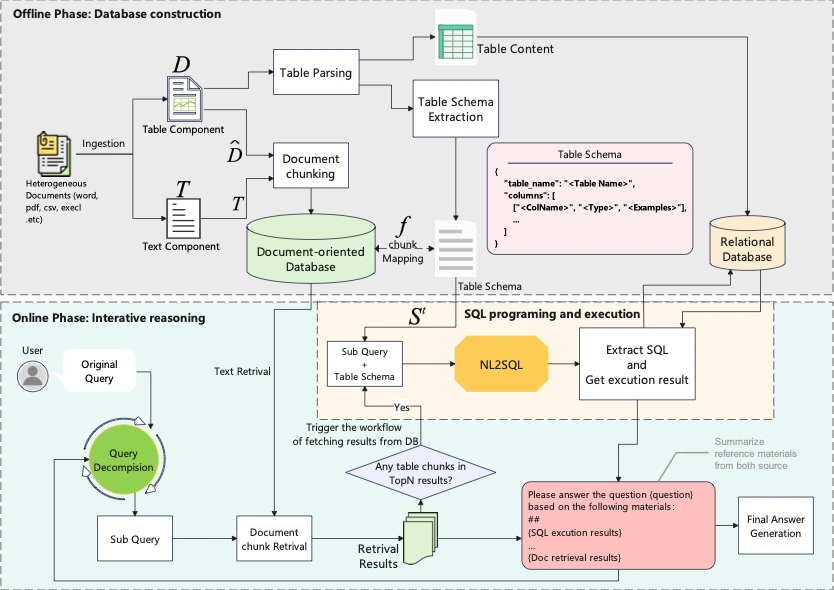
Principio central
Expansión y recuperación de consultas: TableRAG localiza la información clave en las tablas mediante la expansión de consultas, la recuperación de esquemas y la recuperación de celdas. Genera consultas independientes para los valores de esquema y de celda, evitando la información redundante que produciría una única consulta.
Recuperación de esquemas: el modelo de lenguaje ai puede identificar las columnas clave y sus tipos de datos a partir de los nombres de las columnas, sin necesidad de codificar toda la columna. Por ejemplo, para la pregunta "¿Cuál es el precio medio de las carteras?", el modelo de lenguaje generará consultas sobre nombres de columnas como "producto" y "precio".
Recuperación de celdas: a partir de las consultas generadas por el modelo de lenguaje, recupera los nombres de columna y las celdas relacionados con la pregunta. Por ejemplo, recupera los valores de las celdas relacionados con "carteras".
Truncamiento sensible a la frecuencia: introduce un presupuesto de codificación de celdas B; si el número de valores distintos supera B, solo se codifican los B valores más frecuentes.
Módulos principales de TableRAG
online_inference/main.py: el código central de inferencia de TableRAG, contiene la clase TableRAG e implementa la lógica principal de la inferencia online.
offline_data_ingestion_and_query_interface/src/interface.py: utiliza el marco Flask para proporcionar una interfaz de consultas SQL.
online_inference/tools/sql_tool.py: contiene las funciones de herramientas para la generación y ejecución de SQL, con soporte para un mecanismo de reintentos.
offline_data_ingestion_and_query_interface/src/sql_alchemy_helper.py: proporciona clases auxiliares para operaciones de bases de datos con SQLAlchemy, con soporte para inserción y consulta de datos.
offline_data_ingestion_and_query_interface/src/service.py: maneja la lógica central de las solicitudes a TableRAG, incluyendo la obtención de sentencias SQL desde el LLM y su ejecución.
online_inference/chat_utils.py: contiene funciones de utilidad para obtener los resultados generados por el LLM, con soporte para diferentes backends de API.
offline_data_ingestion_and_query_interface/src/data_persistent.py: funciones de utilidad para limpiar los nombres de columnas de un DataFrame.
offline_data_ingestion_and_query_interface/src/handle_requests.py: invoca la interfaz de inferencia del modelo grande, incluye captura de excepciones y un mecanismo de reintentos con retroceso exponencial.
online_inference/tools/retriever.py: implementa la recuperación semántica y la recuperación híbrida de documentos, incluyendo el recall y el re-ranking.
Ventajas
Codificación de datos eficiente: mediante la recuperación de esquemas y la recuperación de celdas, TableRAG reduce la longitud de entrada del modelo de lenguaje, haciéndola independiente del tamaño de la tabla, lo que mejora la eficiencia de codificación y reduce el coste computacional.
Reducción de la pérdida de información: al proporcionar únicamente al modelo de lenguaje los esquemas y celdas recuperados, se evita la pérdida de información clave que se produciría al procesar la tabla completa.
Mejora de la capacidad de razonamiento: TableRAG mejora la capacidad de razonamiento tabular del modelo de lenguaje al proporcionarle la información clave.
Escenarios de aplicación de TableRAG
Análisis de datos y generación de informes: adecuado para escenarios que necesitan procesar datos tabulares a gran escala, como análisis de datos, generación de informes y procesamiento de estados financieros.
Preguntas y respuestas entre tablas: capaz de manejar tareas como verificación de hechos basadas en tablas, preguntas y respuestas de un solo salto y de varios saltos sobre tablas.
Validación experimental
Los investigadores desarrollaron un benchmark a escala de millones de tokens basado en los conjuntos de datos Arcade y BIRD-SQL para evaluar el rendimiento de TableRAG en tareas de comprensión de tablas a gran escala. Los resultados experimentales muestran que TableRAG supera a los métodos existentes en calidad de recuperación y rendimiento en la comprensión de tablas a gran escala.
Enlace del proyecto
Github: https://github.com/yxh-y/TableRAG









