
 Asistente de guiones▸
 Apps AI
 Noticias AI
Nanonets-OCR-s: un modelo que convierte tablas en imágenes a Markdown
小编 ·

Nanonets-OCR-s: un modelo que convierte tablas en imágenes a Markdown
¿Qué es Nanonets-OCR-s?
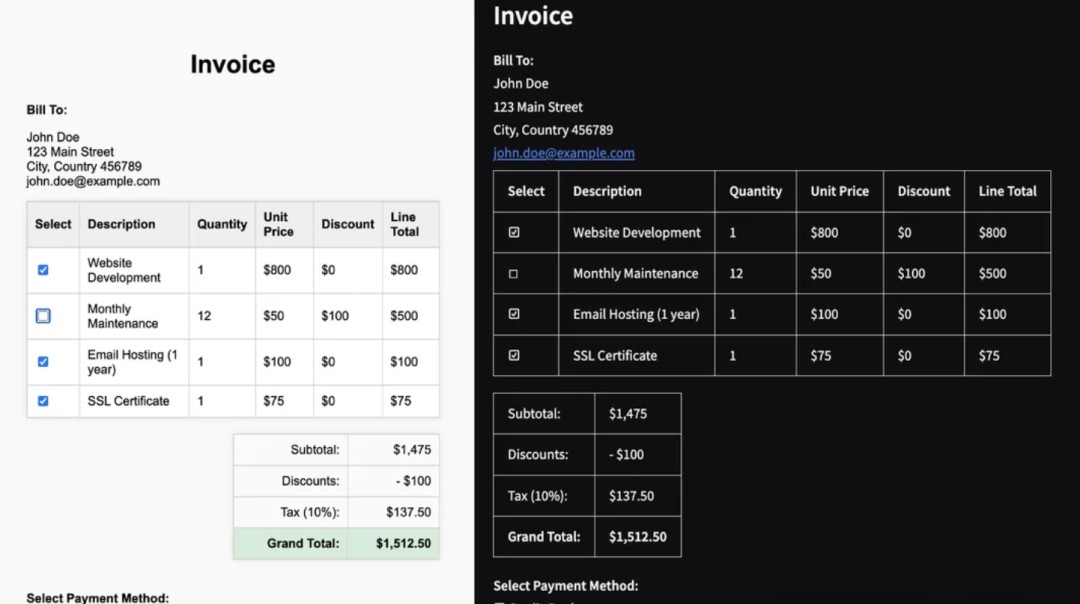
Nanonets-OCR-s puede convertir tablas en imágenes a formato Markdown, y además reconoce la sintaxis LaTeX. También puede localizar imágenes y convertirlas en etiquetas <img>. Las firmas se convierten en etiquetas <signature>, y símbolos como casillas de verificación se representan mediante emoticonos. También puede manejar tablas con celdas combinadas y generarlas en formato HTML. Este modelo tiene un tamaño de 3.75B y está basado en el ajuste fino de Qwen2.5-VL-3B-Instruct, por lo que ofrece un excelente soporte para chino.
Características destacadas
Conversión de tablas: puede extraer con precisión tablas complejas y convertirlas a formatos Markdown y HTML claros.
Reconocimiento de fórmulas: convierte con precisión las fórmulas matemáticas del documento a sintaxis LaTeX, manejando sin esfuerzo tanto fórmulas en línea como fórmulas independientes.
Procesamiento de imágenes: identifica automáticamente las imágenes del documento y las describe mediante etiquetas <img>, lo que facilita su procesamiento posterior.
Extracción de firmas y marcas de agua: puede detectar firmas y marcas de agua en el documento y marcarlas con las etiquetas <signature> y <watermark> respectivamente.
Manejo de casillas de verificación: convierte las casillas de verificación y botones de radio del documento en símbolos Unicode estándar, lo que facilita su lectura y edición.
Modos de uso
A través de la biblioteca de Python:
Instale las bibliotecas necesarias (como transformers, etc.).
Cargue el modelo preentrenado, luego procese la imagen y extraiga el contenido.
A través de la interfaz del servidor:
Inicie el servidor, envíe solicitudes a través de Python y los clientes relacionados, y obtenga los resultados de la conversión.
A través de una herramienta simplificada:
Utilice herramientas como docext para iniciar la aplicación con un solo clic y simplificar el proceso de operación.
Casos de uso
Investigación académica: convierte rápidamente fórmulas, gráficos y tablas de artículos a formato Markdown editable, lo que facilita la organización y la investigación posterior.
Trabajo de oficina empresarial: procesa documentos como contratos e informes, extrayendo información clave y manteniendo la coherencia del formato para mejorar la eficiencia del trabajo.
Ámbito legal: identifica y aísla elementos importantes como firmas y marcas de agua, garantizando la integridad y precisión de los documentos.
Ventajas
Potente en funcionalidades: reconoce múltiples elementos del documento para satisfacer las necesidades de diferentes escenarios.
Inteligente y eficiente: mediante el reconocimiento inteligente y el marcado semántico, el contenido generado es más fácil de procesar.
Ligero y práctico: tiene un tamaño de modelo moderado, optimizado sobre tecnología existente y compatible con chino.
Dirección del proyecto
https://huggingface.co/nanonets/Nanonets-OCR-s









