
 Asistente de guiones▸
 Apps AI
 Noticias AI
VRAG-RL: un framework RAG basado en percepción visual del equipo Tongyi de Alibaba
小编 ·

VRAG-RL: un framework RAG basado en percepción visual del equipo Tongyi de Alibaba
¿Qué es VRAG-RL?
VRAG-RL es un modelo basado en un marco RAG de percepción visual recientemente presentado por el equipo Tongyi de Alibaba. Este modelo logra una mejora del 30% en el rendimiento sobre Qwen2.5-VL-3B y del 20% sobre Qwen2.5-VL-7B.
VRAG-RL, entrenado mediante aprendizaje por refuerzo, dota al modelo de capacidades de razonamiento y pensamiento en múltiples turnos, mejorando progresivamente la comprensión y la precisión de las respuestas del modelo de visión-lenguaje (VLM). Define un espacio de acciones de percepción visual que permite al modelo centrarse de forma gruesa a fina en las zonas densas en información, extrayendo con precisión la información visual clave, y mejorando la capacidad del VLM en la recuperación, el razonamiento y la comprensión de la información visual.
Además, VRAG-RL cuenta con capacidades de recuperación multimodal y razonamiento iterativo, refinando progresivamente la comprensión de la información visual mediante interacción en múltiples turnos, generando finalmente respuestas precisas y completas. Es aplicable a diversas tareas visuales, como comprensión de imágenes, análisis de gráficos y解析 de diseños complejos.
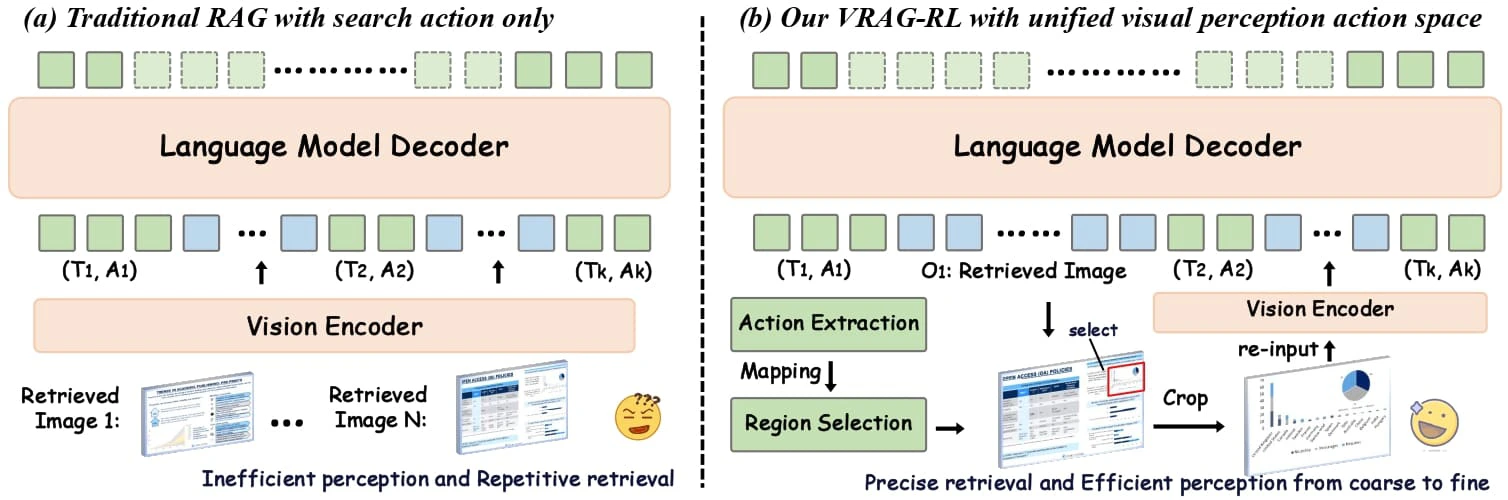
Limitaciones de los métodos RAG tradicionales
Capacidad insuficiente de procesamiento de información visual: incapaz de analizar eficazmente la información de las imágenes, carece de capacidad de comprensión y razonamiento sobre los datos visuales.
El flujo fijo limita el razonamiento dinámico: suele adoptar un flujo fijo de recuperación-generación, lo que dificulta el ajuste dinámico de la ruta de razonamiento en tareas complejas, limitando la capacidad del modelo para explotar la información visual.
Eficiencia de recuperación y profundidad de razonamiento insuficientes: al abordar tareas visuales complejas, a menudo no logra localizar de forma eficiente la información clave, lo que provoca que los resultados generados no sean lo suficientemente precisos.
Innovaciones principales de VRAG-RL
Espacio de acciones de percepción visual: introduce múltiples acciones de percepción visual, como selección de regiones, recorte y zoom, permitiendo al modelo centrarse progresivamente de granularidad gruesa a fina en las zonas densas en información, extrayendo con precisión la información visual clave. Este enfoque de percepción de grueso a fino no solo mejora la capacidad del modelo para comprender la información visual, sino que también incrementa significativamente la eficiencia de recuperación.
Marco de aprendizaje por refuerzo: optimiza las capacidades de razonamiento y recuperación del modelo mediante aprendizaje por refuerzo (RL). El modelo interactúa en múltiples turnos con el motor de búsqueda, muestrea de forma autónoma trayectorias de razonamiento de uno o varios turnos y se optimiza continuamente a partir de las muestras.
Mecanismo de recompensa integral: se diseña una función de recompensa integral que incluye recompensa por eficiencia de recuperación, recompensa por consistencia de patrón y recompensa basada en el modelo sobre los resultados. Este mecanismo de recompensa se centra en el resultado final y optimiza el proceso de recuperación, permitiendo al modelo obtener la información relevante de forma más eficaz.
Estrategia de muestreo multi-experto: combina la capacidad de razonamiento de modelos a gran escala con la capacidad de anotación precisa de modelos expertos, permitiendo al modelo aprender estrategias de percepción visual más efectivas.
Entrenamiento con interacción multi-turno: basado en una estrategia de entrenamiento con interacción en múltiples turnos, el modelo optimiza progresivamente el proceso de razonamiento en su interacción continua con el entorno externo, mejorando la estabilidad y consistencia del razonamiento.
Ventajas técnicas de VRAG-RL
Mejora del rendimiento: los resultados experimentales muestran que VRAG-RL logra un rendimiento significativamente superior al de los métodos existentes en múltiples conjuntos de datos de referencia de visión-lenguaje. Los tipos de tareas abarcan desde razonamiento de un solo salto hasta razonamiento multi-salto, desde comprensión de texto puro hasta reconocimiento de gráficos y análisis de diseños complejos, cubriendo múltiples escenarios visualmente ricos.
Soporte de interacción multi-turno: capaz de centrarse progresivamente en las zonas densas en información durante la fase de razonamiento, logrando una adquisición de información de grueso a fino.
Entrenamiento eficiente: introduce el algoritmo GRPO líder en la industria, simulando escenarios de aplicación del mundo real mediante el despliegue local de un motor de búsqueda, logrando coste cero en las llamadas al motor de búsqueda y un entrenamiento del modelo más eficiente.
Escenarios de aplicación de VRAG-RL
Análisis de gráficos complejos: extracción de datos clave de informes financieros y gráficos científicos.
Análisis de maquetas de diseño: comprensión y razonamiento sobre el diseño y los elementos de las maquetas de diseño.
Recuperación de documentos: recuperación eficiente de información en bases de conocimiento documentales que contienen imágenes y tablas.
Preguntas y respuestas multimodales: combinación de texto e imágenes para razonamiento multi-salto y respuesta a preguntas complejas.
Enlaces del proyecto
Repositorio de GitHub:https://github.com/Alibaba-NLP/VRAG
Biblioteca de modelos en HuggingFace:https://huggingface.co/collections/autumncc/vrag-rl
Artículo técnico en arXiv:https://arxiv.org/pdf/2505.22019









