
 Asistente de guiones▸
 Apps AI
 Noticias AI
Alibaba lanza QwenLong-L1-32B: un LLM para razonamiento de contexto largo
小编 ·

Alibaba lanza QwenLong-L1-32B: un LLM para razonamiento de contexto largo
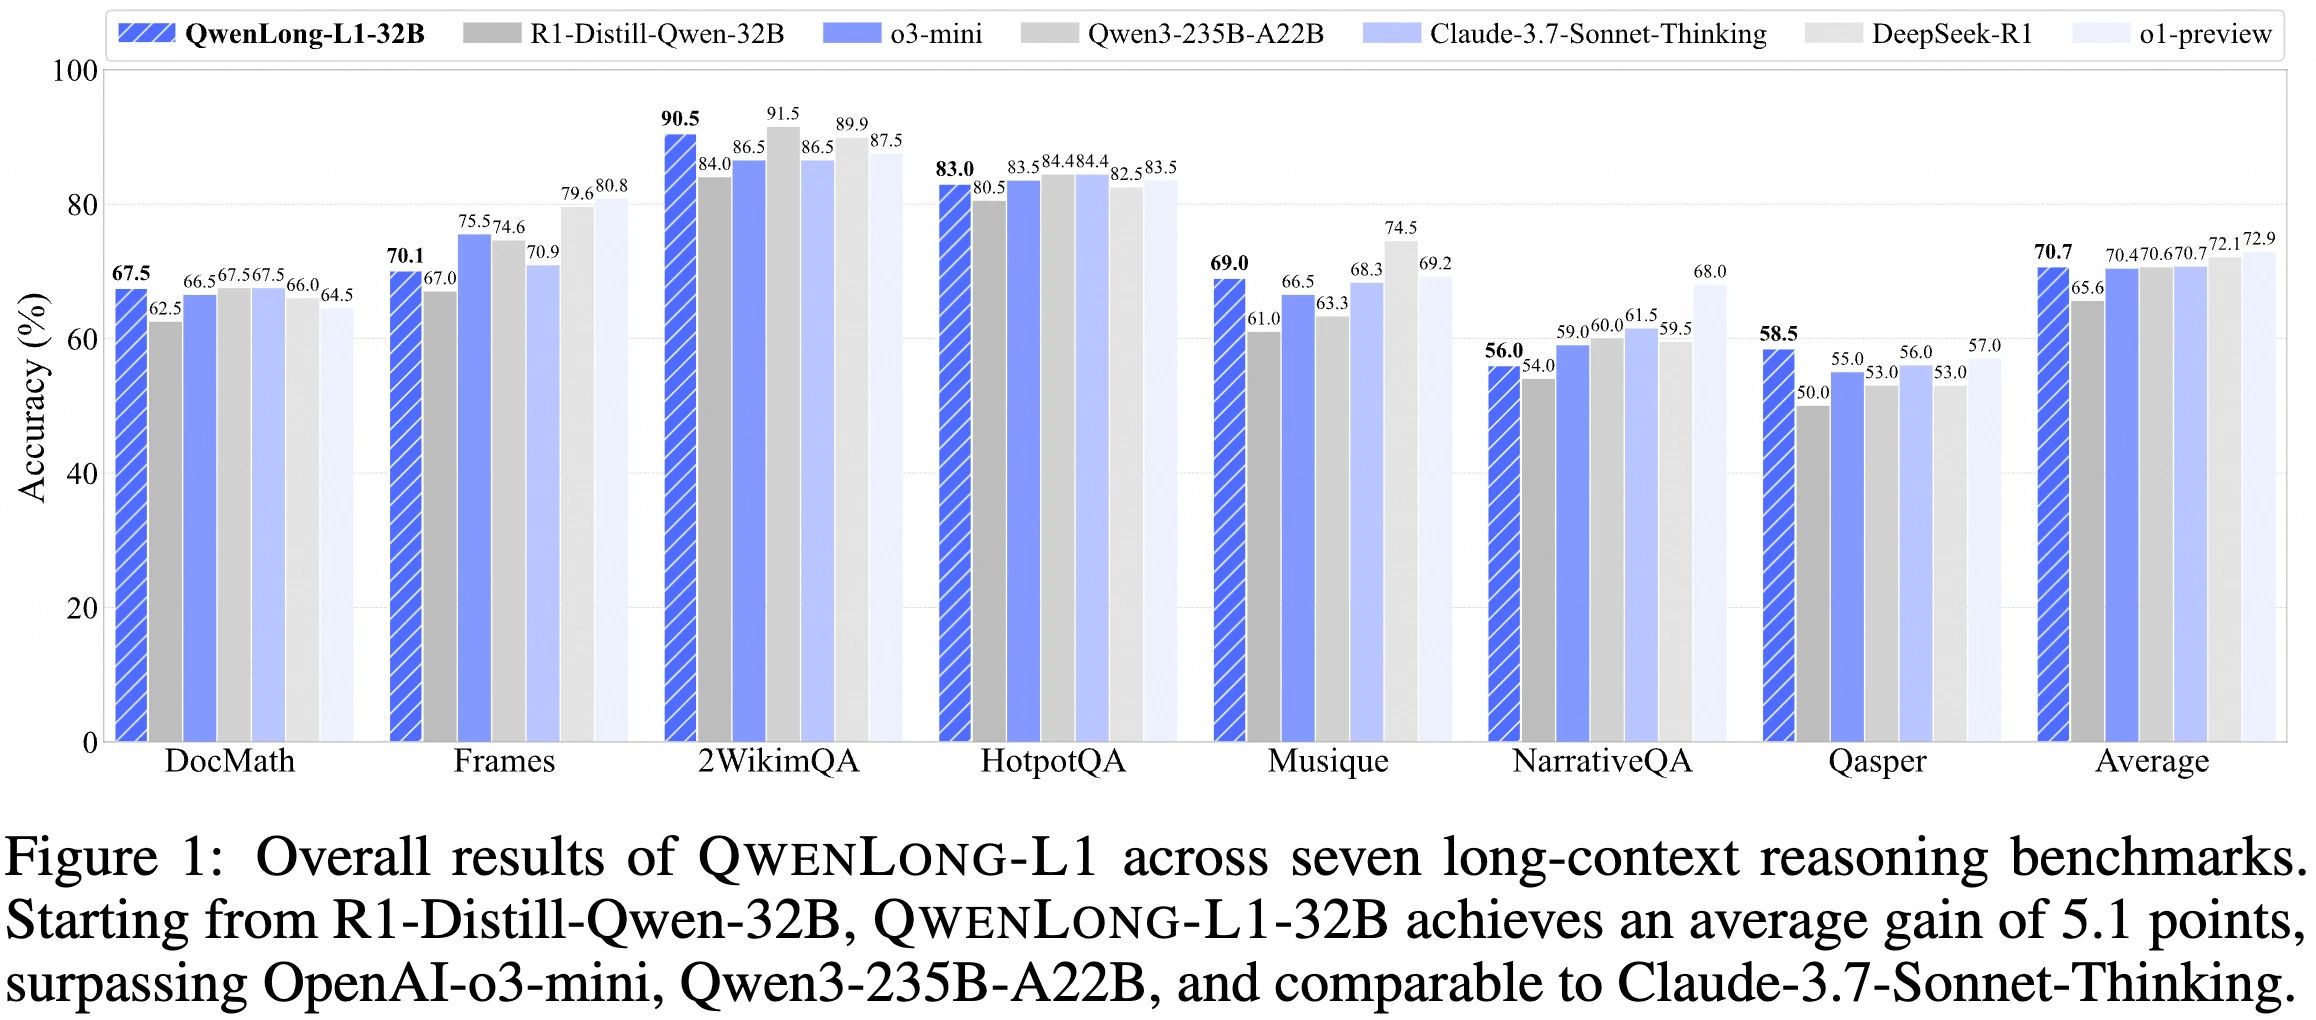
El 26 de mayo de 2025, el equipo de Alibaba presentó QwenLong-L1-32B, el primer modelo de razonamiento de gran tamaño con contexto largo entrenado mediante aprendizaje por refuerzo, junto con el conjunto de datos DocQA-RL-1.6K (que contiene 1600 preguntas de respuesta sobre documentos en matemáticas, lógica y razonamiento multi-hop). Su marco aborda los desafíos de baja eficiencia de entrenamiento e inestabilidad en el proceso de optimización del aprendizaje por refuerzo para razonamiento con contexto largo, mediante el ajuste fino supervisado de calentamiento, el aprendizaje por refuerzo guiado por currículum y un mecanismo de muestreo de revisión sensible a la dificultad. En 7 puntos de referencia de DocQA de contexto largo, su rendimiento supera al de Openai-o3-mini y Qwen3-235B-A22B, y es comparable al de Claude-3.7-Sonnet-Thinking.
Marco del modelo
Idea central: adaptar modelos de razonamiento de gran escala (LRMs) de contexto corto a escenarios de contexto largo mediante aprendizaje por refuerzo (RL).
Componentes principales:
Fase de ajuste fino supervisado (SFT) de calentamiento: establece una política inicial robusta.
Técnica de aprendizaje por refuerzo por fases basada en currículum: estabiliza la evolución de la política.
Estrategia de muestreo de revisión sensible a la dificultad: fomenta la exploración de la política.
Datos de entrenamiento
Se utilizó un conjunto de datos de entrenamiento de aprendizaje por refuerzo específico llamado DocQA-RL-1.6K, que contiene 1600 preguntas de respuesta sobre documentos en los ámbitos de matemáticas, lógica y razonamiento multi-hop.
Rendimiento
En siete puntos de referencia de respuesta a preguntas sobre documentos con contexto largo, QwenLong-L1-32B superó a LRMs de primer nivel como OpenAI-o3-mini y Qwen3-235B-A22B, alcanzando un nivel similar al de Claude-3.7-Sonnet-Thinking, mostrando un rendimiento líder entre los LRMs más avanzados actuales.
Diseño experimental
Se construyó un conjunto de datos de entrenamiento de RL específico, DocQA-RL-1.6K, que contiene 1600 preguntas de respuesta sobre documentos en los ámbitos de matemáticas, lógica y razonamiento multi-hop.
La parte de razonamiento matemático utilizó 600 preguntas del conjunto de datos DocMath, con el 75% para entrenamiento y el 25% para evaluación.
La parte de razonamiento lógico se sintetizó mediante DeepSeek-R1 con 600 preguntas de opción múltiple, abarcando documentos reales de los ámbitos legal, financiero, de seguros y de producción.
La parte de razonamiento multi-hop tomó 200 ejemplos de MultiHopRAG y 200 de Musique, enfatizando el razonamiento entre documentos.
Se realizó la evaluación en siete puntos de referencia de DocQA de contexto largo, incluyendo 2WikiMultihopQA, HotpotQA, Musique, NarrativeQA, Qasper, Frames y DocMath.
Resultados y análisis
QwenLong-L1-32B mostró un rendimiento excelente en los siete puntos de referencia de DocQA de contexto largo, superando a modelos LRM de primer nivel como OpenAI-o3-mini y Qwen3-235B-A22B, con un rendimiento similar al de Claude-3.7-Sonnet-Thinking.
En el punto de referencia de razonamiento matemático DocMath, la coincidencia exacta y la precisión evaluada por LLM de QwenLong-L1-32B alcanzó el 85,3%.
En el punto de referencia de razonamiento multi-hop HotpotQA, el modelo alcanzó un rendimiento del 87,6%, superando significativamente a los modelos existentes.
Enlaces del proyecto
Github:https://github.com/Tongyi-Zhiwen/QwenLong-L1
Huggingface:https://huggingface.co/Tongyi-Zhiwen/QwenLong-L1-32B
Modelscope:https://www.modelscope.cn/models/iic/QwenLong-L1-32B









