
 Asistente de guiones▸
 Apps AI
 Noticias AI
ParseStudio: una biblioteca de Python para simplificar el análisis de PDF
小编 ·

ParseStudio: una biblioteca de Python para simplificar el análisis de PDF
¿Qué es ParseStudio?
Al trabajar con documentos PDF, extraer texto, tablas e imágenes suele ser una tarea tediosa, y el uso diferente de cada biblioteca hace que el código sea repetitivo y difícil de mantener. ParseStudio, una biblioteca de Python, ofrece un enfoque simplificado al integrar múltiples analizadores en una interfaz unificada, permitiendo a los usuarios analizar documentos PDF con solo unas pocas líneas de código. Esta biblioteca combina tres motores: Docling, PyMuPDF y Llama Parse, lo que permite manejar con flexibilidad la extracción de texto, tablas e imágenes. Las características principales de ParseStudio son: diseño modular, capacidad para extraer simultáneamente varios tipos de contenido, diseño de API conciso, conversión automática de tablas a formato Markdown, inclusión de metadatos al extraer imágenes, y soporte para el procesamiento por lotes de múltiples archivos PDF. Para los desarrolladores con ciertos conocimientos de Python, ParseStudio es una herramienta práctica.
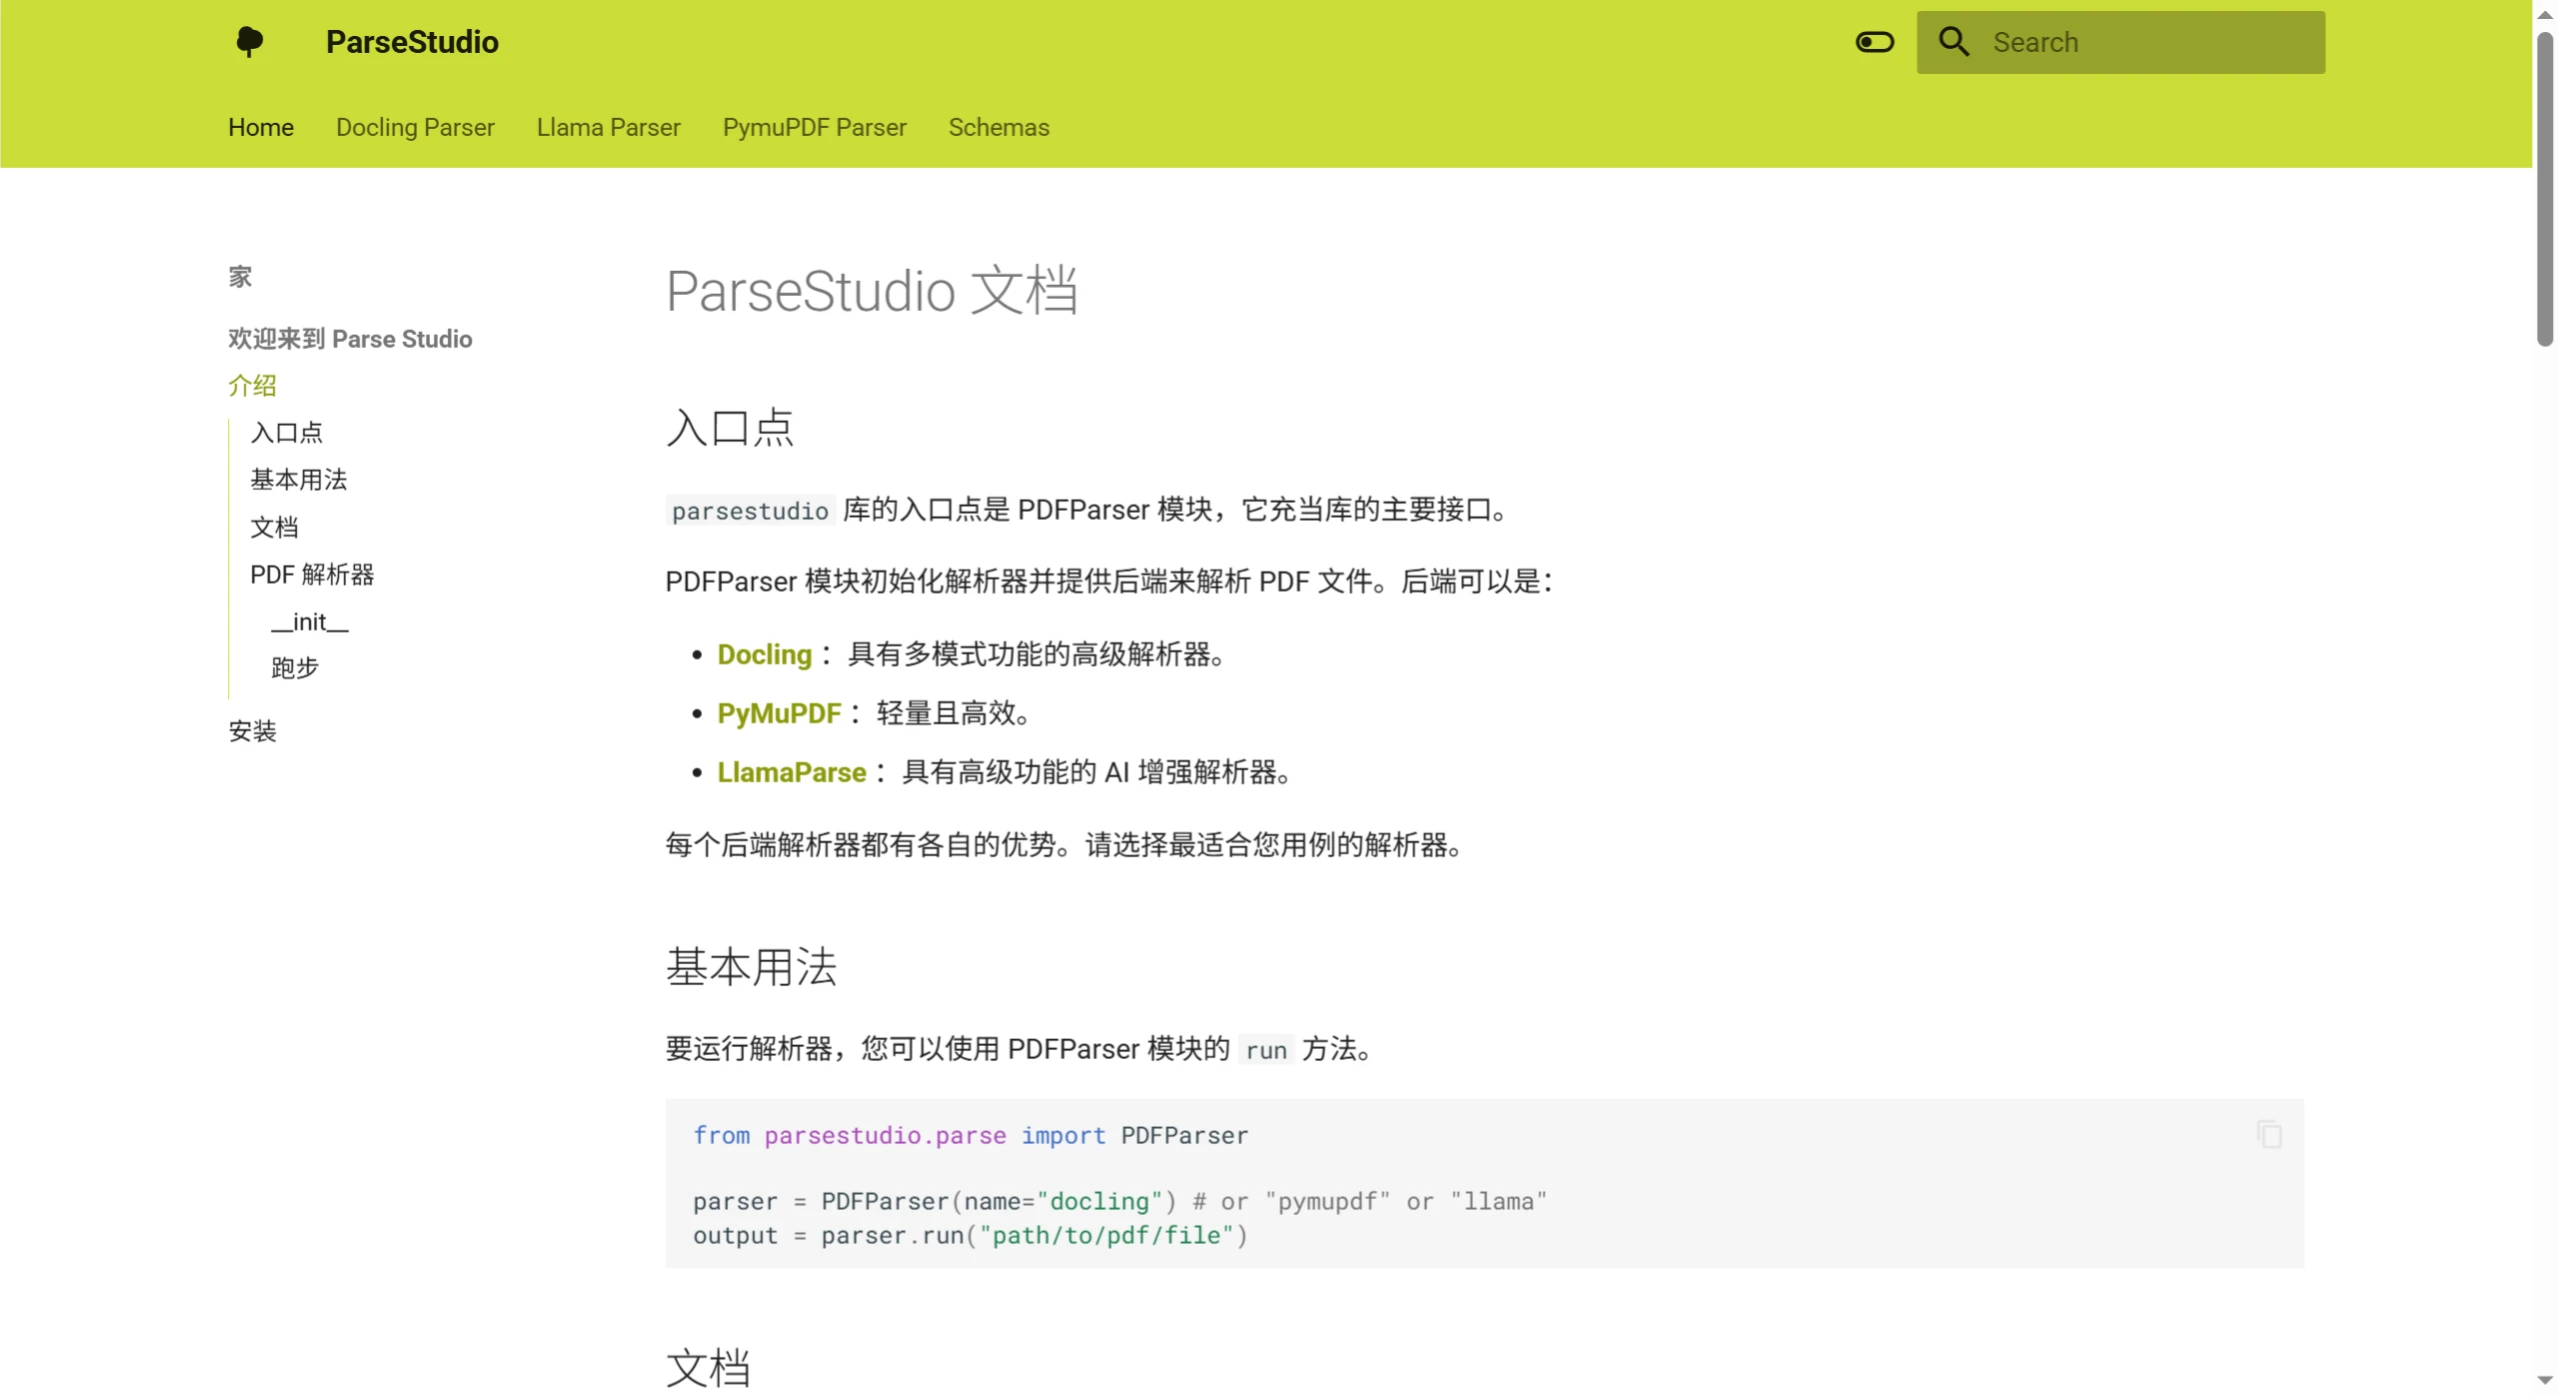
Características principales de ParseStudio
Diseño modular: permite elegir entre varios backends de análisis, como Docling, PyMuPDF y Llama Parse, para satisfacer diferentes necesidades.
Análisis multimodal: extrae sin problemas texto, tablas e imágenes.
Sintaxis unificada: simplifica la interacción con diferentes backends al proporcionar una interfaz común.
Extensibilidad: permite ajustar fácilmente el comportamiento del análisis mediante parámetros adicionales.
Amigable para el usuario: abstrae las complejidades específicas de cada backend, lo que permite a los usuarios centrarse en la extracción de contenido.
Cómo instalar ParseStudio
Instalación mediante pip:
pip install parsestudio
Instalación desde el código fuente:
git clone https://github.com/chatclimate-ai/ParseStudio.git
cd ParseStudio
pip install .
Inicio rápido con ParseStudio
Importar e inicializar el analizador:
from parsestudio.parse import PDFParser
# Inicializar con el backend de análisis deseado
parser = PDFParser(parser="docling")  # Opciones: "docling", "pymupdf", "llama"
Analizar un archivo PDF:
outputs = parser.run(["path/to/file.pdf"], modalities=["text", "tables", "images"])
# Acceder al contenido de texto
print(outputs[0].text)
# Acceder a las tablas
for table in outputs[0].tables:
print(table.markdown)
# Acceder a las imágenes
for image in outputs[0].images:
image.image.show()
metadata = image.metadata
print(metadata)
Analizadores compatibles
Docling: adecuado para el análisis detallado del diseño de documentos complejos, compatible con OCR y extracción precisa de tablas.
PyMuPDF: ligero y eficiente, ideal para un procesamiento rápido.
LlamaParse: extracción basada en la nube y mejorada con IA, adecuada para escenarios que requieren funciones avanzadas.
Github:https://github.com/chatclimate-ai/ParseStudio









