
 Asistente de guiones▸
 Apps AI
 Noticias AI
HRAvatar: método para generar avatares 3D de alta calidad a partir de vídeo monocular
小编 ·

HRAvatar: método para generar avatares 3D de alta calidad a partir de vídeo monocular
En el contexto del rápido desarrollo de campos como los humanos digitales, los presentadores virtuales y la AR/VR, la generación eficiente de avatares en 3D realistas, animables y con capacidad de reiluminación se ha convertido en una necesidad clave. Sin embargo, la generación de avatares animables altamente realistas a partir de vídeos monoculares sigue enfrentando numerosos desafíos, y los métodos existentes basados en Gaussianas 3D (3DGS) presentan ciertas limitaciones en la calidad de reconstrucción, como una flexibilidad insuficiente en la deformación geométrica, un seguimiento inexacto de las expresiones y la incapacidad de lograr una reiluminación realista.
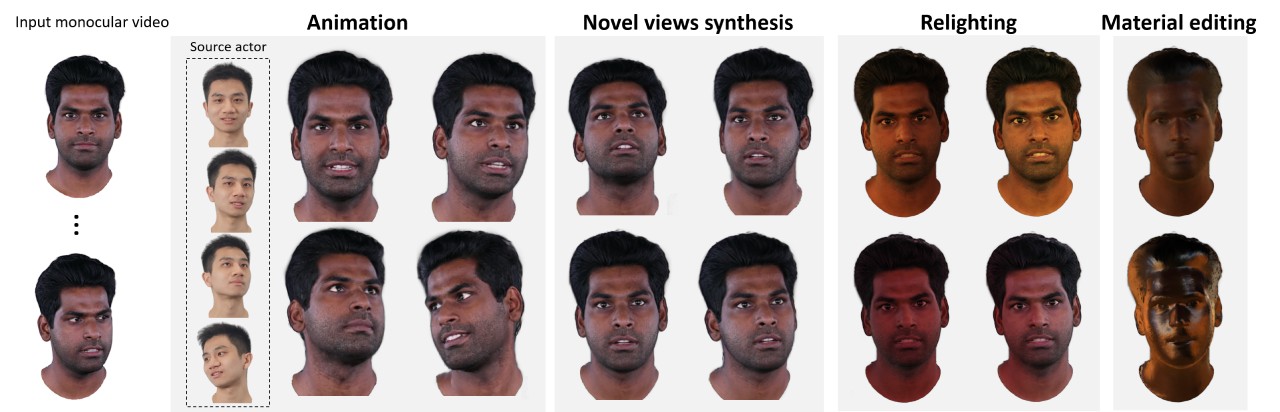
El equipo de la Universidad de Tsinghua, en colaboración con IDEA, ha desarrollado HRAvatar, una nueva tecnología que utiliza vídeos monoculares para crear avatares 3D de alta calidad y con capacidad de reiluminación. Aprovecha bases de deformación aprendibles y skinning lineal para lograr una deformación geométrica personalizada, y cuenta con un codificador de expresiones preciso que reduce el error de seguimiento y mejora la calidad de la reconstrucción. HRAvatar destaca por su rendimiento en tiempo real y su representación de detalles, y ha sido aceptado en la conferencia CVPR 2025. Los experimentos demuestran que supera a las tecnologías existentes en múltiples métricas de evaluación, con un rendimiento en tiempo real de aproximadamente 155 FPS, y también admite la reiluminación en nuevos entornos de iluminación.
Tecnologías centrales de HRAvatar
Tecnología de bases de deformación aprendibles y skinning lineal: mediante el aprendizaje adaptativo de las bases de deformación y los pesos de skinning de mezcla de cada punto, se logra una deformación flexible de los puntos gaussianos desde una pose estándar hacia diversas expresiones y poses, resolviendo el problema de que los modelos paramétricos genéricos难以 capturar con precisión los cambios de expresión个性化.
Codificador de expresiones preciso: se introduce un codificador de expresiones de extremo a extremo, optimizado conjuntamente con la reconstrucción del avatar 3D, que utiliza la pérdida de reconstrucción gaussiana para supervisión, reduciendo el error de seguimiento y mejorando la calidad de la reconstrucción.
Modelado de apariencia y sombreado físico: la apariencia del avatar se descompone en propiedades del material como albedo, rugosidad y reflexión de Fresnel; se introduce un pseudo-prior de albedo para desacoplar mejor la información del material; se utiliza un modelo físico BRDF simplificado para el sombreado, y se aplica la aproximación SplitSum para precalcular el mapa de iluminación, logrando una renderización en tiempo real de alta calidad y con capacidad de reiluminación.
Ventajas técnicas de HRAvatar
Alta calidad de reconstrucción: supera a los métodos existentes en todas las métricas de evaluación, especialmente en LPIPS, donde los avatares reconstruidos presentan detalles más ricos.
Excelente rendimiento en tiempo real: la velocidad de renderización alcanza aproximadamente 155 FPS, cumpliendo con los requisitos de tiempo real.
Los avatares reconstruidos por HRAvatar no solo pueden ser animados, sino que también admiten reiluminación bajo nuevos mapas de luz ambiental o edición sencilla de materiales, siendo aplicables en campos como el cine, los videojuegos, las reuniones inmersivas y la AR/VR.
Enlaces relacionados con el proyecto
Dirección del artículo:https://arxiv.org/pdf/2503.08224
Página del proyecto:https://eastbeanzhang.github.io/HRAvatar/
Código开源:https://github.com/Pixel-Talk/HRAvatar









