
 Asistente de guiones▸
 Apps AI
 Noticias AI
KEEP: restaura rostros en vídeos de baja resolución a alta definición
小编 ·

KEEP: restaura rostros en vídeos de baja resolución a alta definición
¿Qué es KEEP?
KEEP es una herramienta desarrollada por un equipo de investigación de la Universidad Tecnológica de Nanyang capaz de restaurar rostros en vídeos de baja resolución a alta definición, haciendo que las características faciales sean más visibles. Esta tecnología tiene amplias aplicaciones en campos como la videovigilancia y la producción audiovisual, ya que mejora eficazmente la calidad de las imágenes faciales y proporciona material más nítido para el análisis y procesamiento posterior.
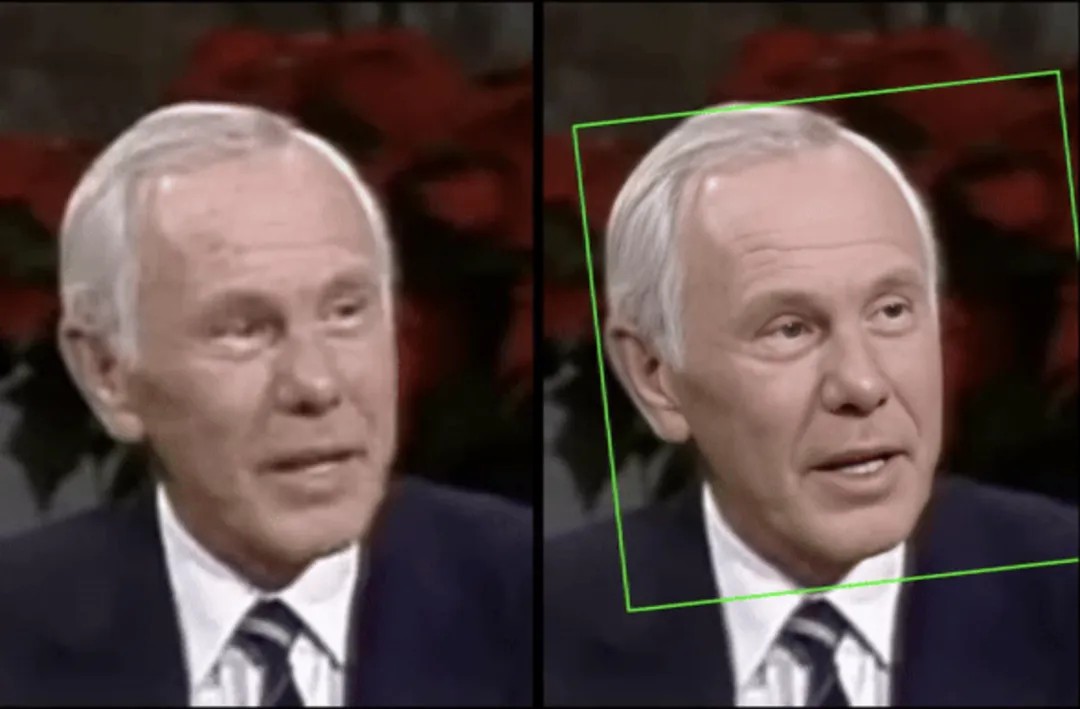
Tecnología principal de KEEP
Principio del filtro de Kalman: mediante el seguimiento de las características faciales en la secuencia de vídeo, se utiliza el filtro de Kalman para predecir las características faciales en el siguiente fotograma, logrando así una mayor superresolución del rostro.
Propagación de características y ajuste dinámico: se obtiene información de fotogramas restaurados previamente para guiar el proceso de restauración del fotograma actual, reduciendo las diferencias entre fotogramas consecutivos.
Procesamiento multiescala: combina información de múltiples escalas para mejorar la representación de detalles y la calidad general de la imagen facial.
Atención entre fotogramas (CFA): mejora aún más la correlación entre diferentes fotogramas, ayudando a mantener una mejor coherencia temporal y representación de detalles durante la reproducción del vídeo.
Arquitectura del modelo KEEP
Codificador y decodificador: se construye un modelo basado en la red generativa antagónica cuántica variacional (VQGAN) para generar imágenes superresueltas de alta calidad.
Red de filtro de Kalman: combina el estado de observación del fotograma actual con el estado predicho del fotograma anterior para formar una estimación más precisa del estado actual.
Capa de atención entre fotogramas (CFA): mejora los detalles del fotograma actual mediante la coincidencia y fusión de características similares del fotograma anterior.
Ventajas de KEEP
Consistencia temporal: capaz de mantener la coherencia de los rostros en el vídeo, evitando la inconsistencia temporal causada por el procesamiento independiente de cada fotograma.
Reconstrucción de detalles: puede restaurar eficazmente los detalles faciales, como ojos, nariz y boca, incluso en vídeos gravemente degradados.
Robustez: destaca en rostros no frontales y vídeos gravemente degradados, estimando de forma estable la información previa del rostro.
Escenarios de aplicación de KEEP
Restauración de películas antiguas: mejora la nitidez de los rostros en películas antiguas y recupera los detalles.
Mejora de la videovigilancia: en el campo de la seguridad, aumenta la resolución de los rostros en vídeos de vigilancia.
Vídeos en redes sociales: mejora la nitidez de los rostros en vídeos de baja calidad subidos por los usuarios.
Sistemas de videoconferencia: mejora la calidad de la imagen facial durante la comunicación remota.
Experiencias de realidad virtual (VR): optimiza el renderizado de los rostros de los personajes.
Enlace del proyecto
https://github.com/jnjaby/KEEP









