
 Asistente de guiones▸
 Apps AI
 Noticias AI
AniSora: modelo abierto de generación de vídeo de animación de Bilibili
小编 ·

AniSora: modelo abierto de generación de vídeo de animación de Bilibili
¿Qué es AniSora?
AniSora es un sistema de generación de IA para vídeos animados de código abierto lanzado por Bilibili el 12 de mayo de 2025. Es capaz de generar con facilidad vídeos de anime en una gran variedad de estilos, como fragmentos de series animadas, animaciones originales chinas, adaptaciones de manga, contenido de VTuber, PVs animados y vídeos de "guichu". Este sistema destaca en mantener la coherencia de la apariencia de los personajes y la fluidez de las acciones, y puede considerarse el modelo más avanzado de generación de vídeo animado disponible actualmente.
Funciones de AniSora
Generación de imagen a vídeo: genera vídeos animados coherentes a partir de una única imagen, ideal para expandir escenas estáticas en escenas dinámicas.
Interpolación de fotogramas: admite interpolación de fotogramas clave, generando fotogramas intermedios para lograr transiciones suaves, reduciendo el trabajo de dibujo manual en la producción de animación.
Guía por imagen local: permite a los usuarios especificar áreas concretas para la generación de animación.
Control espacio-temporal: combina capacidades de control temporal y espacial, admitiendo guía mediante primer fotograma, último fotograma, múltiples fotogramas, etc., para lograr una creación animada precisa.
Características del modelo AniSora
Optimización específica: en comparación con los vídeos naturales, los vídeos animados son más expresivos y abstractos en estilo, y los modelos generativos tradicionales a menudo tienen dificultades para reproducir con precisión las expresiones de los personajes, el ritmo de las acciones y el lenguaje visual exagerado. AniSora se ha optimizado específicamente para estas características, con el objetivo de mejorar la eficiencia de generación de vídeo sin sacrificar la expresión creativa.
Soporte de estilos diversos: capaz de generar con un solo clic fragmentos de vídeo en múltiples estilos, incluyendo series animadas, animación original china, adaptaciones de manga, contenido de VTuber, PVs animados e incluso creaciones de tipo "guichu".
Creación de baja barrera: para particulares o estudios con necesidades reales de producción, AniSora es una herramienta creativa muy atractiva.
Módulos principales de AniSora
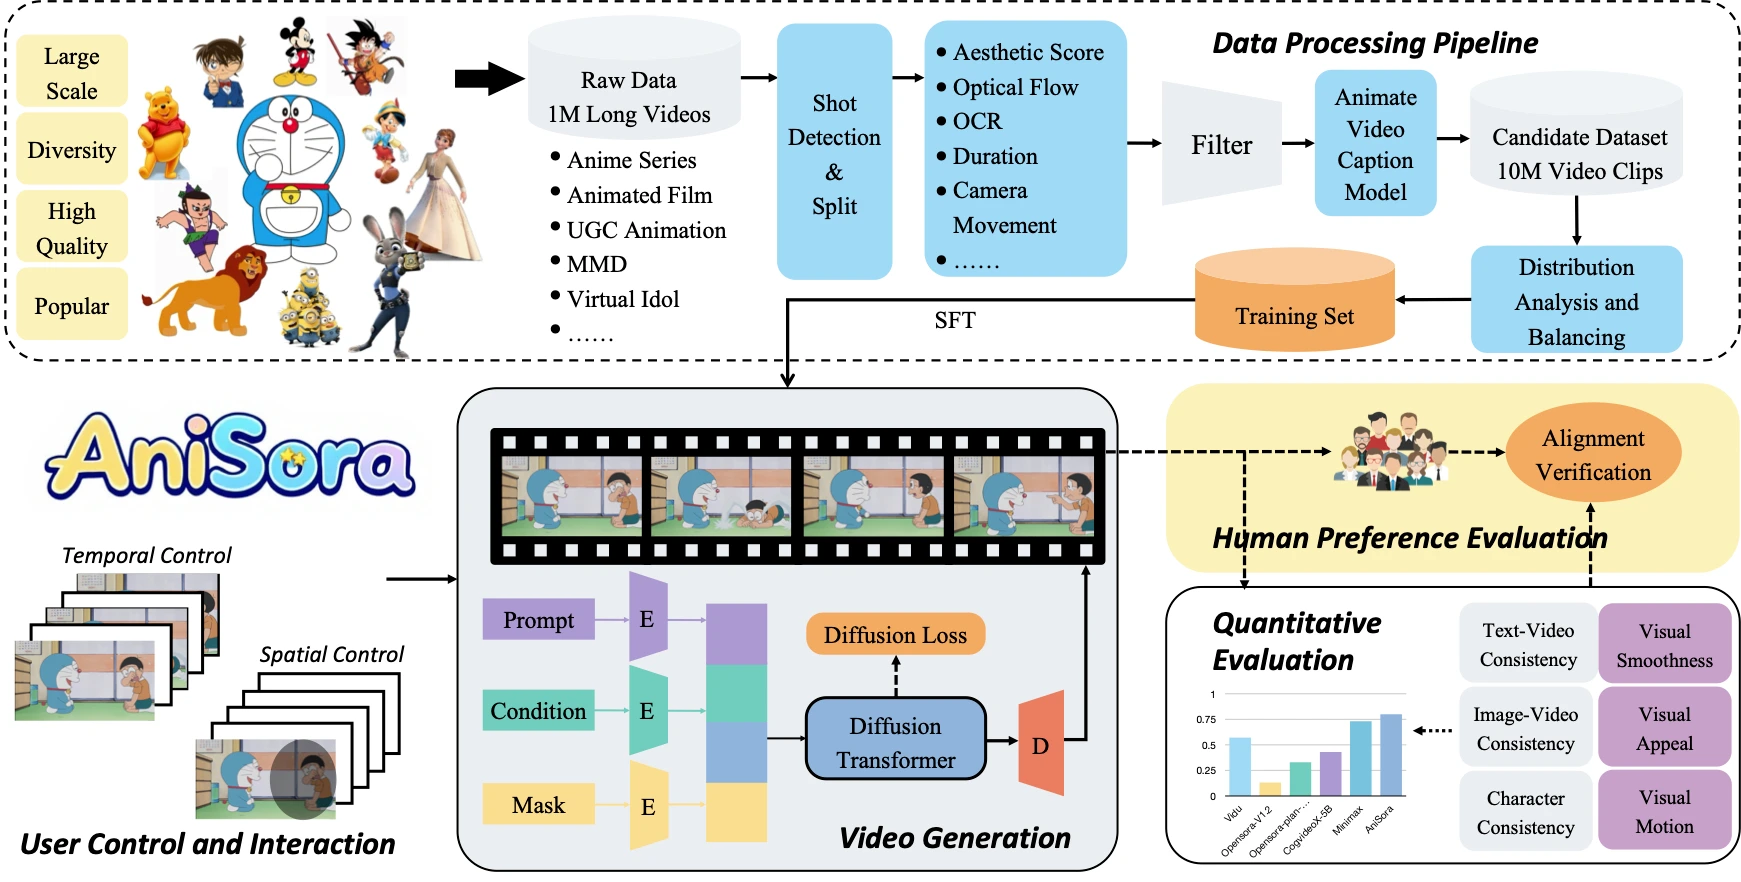
Pipeline de procesamiento de datos: preprocesó más de 10 millones de pares de datos texto-vídeo de alta calidad, proporcionando una base sólida para el entrenamiento.
Modelo de generación controlable: introduce un módulo de máscara espacio-temporal que admite funciones como vídeo a partir de imagen, interpolación de fotogramas clave y guía por imagen local, adaptándose a diversas necesidades creativas.
Sistema de evaluación: construyó un conjunto de datos de evaluación con 948 fragmentos animados diversos, combinando revisión humana doble ciego y el sistema de puntuación VBench, para puntuar dimensiones como la consistencia de los personajes y la coherencia de las acciones.
Principios técnicos de AniSora
Modelo de difusión (Diffusion Model): basado en la arquitectura de modelo de difusión, elimina ruido de forma progresiva para generar contenido de vídeo de alta calidad.
Módulo de máscara espacio-temporal (Spatiotemporal Mask Module): permite al modelo controlar regiones espaciales y temporales específicas durante el proceso de generación, por ejemplo, máscaras que indican qué fotogramas o qué áreas deben animarse, logrando guía local e interpolación de fotogramas clave.
Autoencoder Variacional Causal 3D (3D Causal VAE): se utiliza para codificar y decodificar las características espacio-temporales del vídeo, comprimiendo el vídeo a un espacio latente de baja dimensionalidad, reduciendo la complejidad computacional y conservando la información espacio-temporal clave.
Arquitectura Transformer: combinando la potente capacidad de modelado del Transformer y basándose en mecanismos de atención, captura las complejas dependencias espacio-temporales del vídeo, permitiendo al modelo procesar datos de secuencias largas y generar contenidos de vídeo más coherentes.
Ajuste fino supervisado (Supervised Fine-Tuning): sobre la base del preentrenamiento, se realiza un ajuste fino supervisado con grandes cantidades de datos de vídeo animado, empleando múltiples estrategias (como estrategias de entrenamiento de débil a fuerte, aprendizaje multitarea, etc.) para mejorar la capacidad de generalización y la calidad de generación del modelo.
Pipeline de procesamiento de datos: basado en técnicas como detección de escenas, análisis de flujo óptico y puntuación estética, filtra datos de entrenamiento de alta calidad a partir de grandes volúmenes de vídeos animados en bruto, garantizando la calidad y diversidad de los datos de entrenamiento.
Direcciones de código abierto
https://github.com/bilibili/Index-anisora/tree/main
https://huggingface.co/IndexTeam/Index-anisora
https://www.modelscope.cn/organization/bilibili-index









