
 Asistente de guiones▸
 Apps AI
 Noticias AI
Simple Subtitling: herramienta de generación automática de subtítulos para vídeo
小编 ·

Simple Subtitling: herramienta de generación automática de subtítulos para vídeo
¿Qué es Simple Subtitling?
Simple Subtitling es una herramienta de ia que genera automáticamente subtítulos para obras audiovisuales. Utiliza la tecnología WhisperX para convertir archivos de audio en archivos de subtítulos (SRT) con marcas de tiempo e identificadores de hablante. Luego, asigna los identificadores de hablante mediante la extracción e agrupación de embeddings de hablante, y puede asignar nombres exactos a los hablantes cuando se proporcionan ejemplos de audio. En concreto, primero convierte el audio en texto con marcas de tiempo; después extrae las características de cada hablante, las agrupa mediante clustering jerárquico aglomerativo (AHC) y, por último, asigna identificadores a los hablantes. Si el usuario proporciona muestras de voz de los actores, la herramienta también puede asignar nombres a los hablantes. Esta herramienta está diseñada para simplificar la generación de subtítulos y hacer que las obras audiovisuales sean más fáciles de ver.
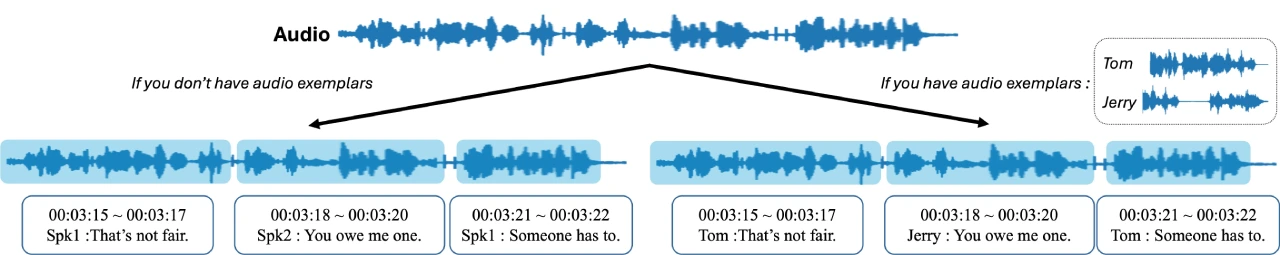
Características y funcionalidades de Simple Subtitling
Reconocimiento de voz y generación de marcas de tiempo: utiliza la tecnología WhisperX para reconocer con precisión el contenido de audio palabra por palabra y frase por frase, y generar texto de voz con marcas de tiempo.
Reconocimiento de hablantes: asigna identificadores de hablante extrayendo embeddings de hablante a nivel de oración y aplicando clustering jerárquico aglomerativo (AHC) para agruparlos.
Soporte multilingüe: admite entradas de audio en varios idiomas y puede generar los subtítulos correspondientes.
Configuración personalizada: los usuarios pueden especificar el directorio de muestras de audio para asignar nombres exactos a los hablantes.
Reconocimiento de voz y agrupación de alta precisión: logra un reconocimiento de voz y una agrupación de alta precisión, convirtiendo con precisión la voz en texto y clasificando las voces de diferentes hablantes, lo que mejora la exactitud y la legibilidad de los subtítulos.
Instalación y使用方法 de Simple Subtitling
Pasos de instalación
Crea y activa un entorno de conda llamado simplesub, especificando la versión 3.11 de Python.
En ese entorno, instala los paquetes de Python necesarios para el proyecto mediante el comando pip install -r requirements.txt.
También es necesario instalar ffmpeg; puedes consultar la documentación correspondiente para conocer el método de instalación específico.
Modo de uso
Uso básico
Ejecuta python main.py --input_file [INPUT_FILE_PATH] --output_file [OUTPUT_SRT_PATH], por ejemplo python main.py --input_file data/friends.wav --output_file result/friends.srt, lo que generará un archivo de subtítulos a partir del archivo de audio de entrada.
Uso de ejemplos de audio para especificar los nombres de los hablantes
Primero, organiza el directorio --exemplar_dir siguiendo una estructura específica: cada subcarpeta representa a un hablante y contiene muestras de audio de ese hablante.
A continuación, ejecuta python main.py --input_file [INPUT_FILE_PATH] --output_file [OUTPUT_SRT_PATH] --exemplar_dir [PATH_OF_EXEMPLARS], por ejemplo python main.py --input_file data/friends.wav --output_file result/friends_exemplars.srt --exemplars exemplars.
Descripción de los parámetros
input_file: ruta del archivo de audio de entrada.
output_file: ruta del archivo de subtítulos de salida (en formato SRT).
whisper_model_type: tipo de modelo Whisper; por defecto es 'medium'; puedes consultar la documentación correspondiente para ver los tipos disponibles.
language: código de idioma (dos letras; por ejemplo, 'en' para inglés); si es None, Whisper detectará el idioma en los primeros 30 segundos; por defecto es None.
embedding_model: extractor de embeddings de hablante; las opciones son 'ecapatdnn' o 'wespeaker'; por defecto es 'wespeaker'.
n_cluster: si se conoce el número de hablantes, se puede especificar este parámetro; por defecto es None.
distance_threshold: si n_cluster no se especifica, este es el umbral de distancia para el AHC (clustering jerárquico aglomerativo); por defecto es 0.8.
exemplar_dir: ruta del directorio que contiene los ejemplos de audio; por defecto es None.
exemplar_threshold: umbral de similitud del coseno que se utiliza para decidir los hablantes "desconocidos"; por defecto es 0.2.
Github: https://github.com/JaesungHuh/simple-subtitling









