
 Asistente de guiones▸
 Apps AI
 Noticias AI
ContextGem: herramienta de IA para extraer datos estructurados de documentos
小编 ·

ContextGem: herramienta de IA para extraer datos estructurados de documentos
¿Qué es ContextGem?
ContextGem es una herramienta de ia que extrae datos estructurados de documentos, cuya capacidad principal reside en comprender automáticamente la intención según la información de extracción especificada por el usuario y localizar con precisión el contenido correspondiente en el documento, siendo especialmente擅长 para realizar análisis en profundidad.
Es ideal para escenarios que requieren leer grandes volúmenes de documentos, como la extracción de cláusulas clave en contratos, datos importantes en informes o ideas centrales en artículos, ayudando a los usuarios a realizar una lectura profunda de manera eficiente.
ContextGem no solo puede localizar la información e indicarte exactamente en qué párrafo u oración se encuentra, sino que también explica las razones y el proceso de razonamiento detrás de la extracción de dicha información. Puede completar tareas de extracción complejas con unas pocas líneas de código, con un alto grado de automatización y muchas operaciones complejas encapsuladas. Es capaz de generar prompts automáticamente, realizar validación de datos de forma automática y segmentar de manera autónoma, simplificando enormemente el flujo de trabajo del usuario.
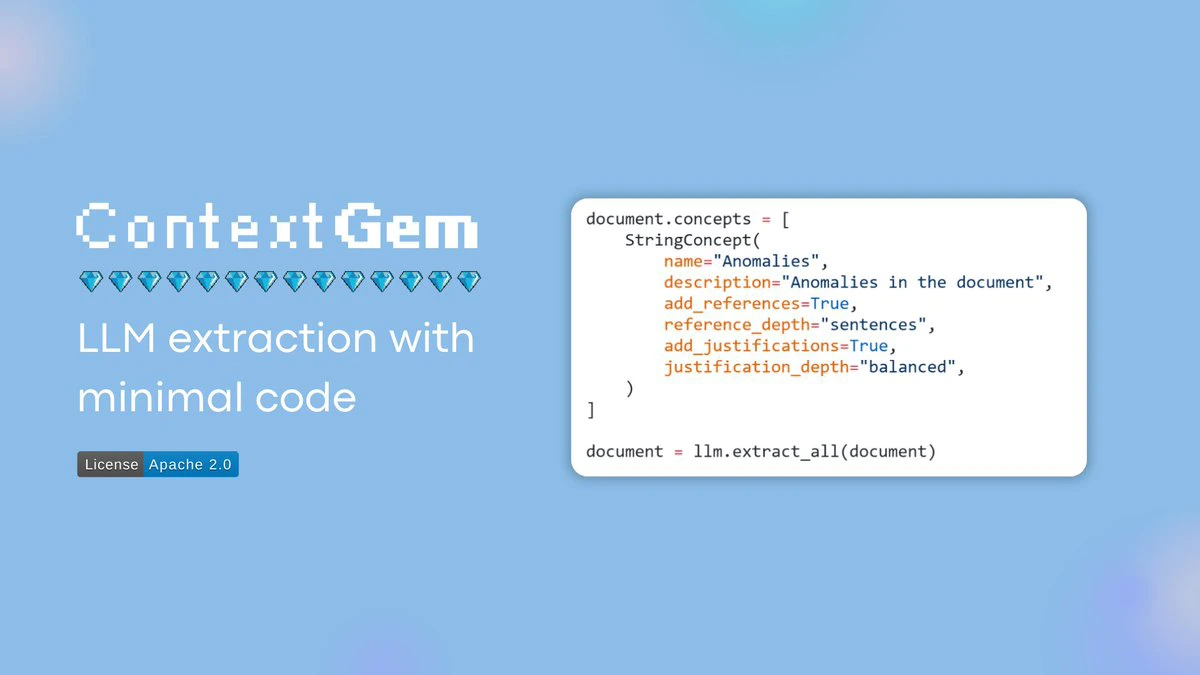
Funciones principales de ContextGem
Prompts dinámicos automatizados: genera automáticamente prompts personalizados y exhaustivos según las necesidades de extracción, sin necesidad de escribir ni mantener prompts manualmente.
Generación automática de modelos de datos y validadores: crea automáticamente modelos de datos y lógica de validación en Pydantic a partir de las definiciones, evitando escribir código boilerplate repetidamente.
Mapeo preciso del contenido extraído: asigna automáticamente los datos extraídos a su ubicación exacta en el documento fuente (con precisión a nivel de párrafo u oración), garantizando que los resultados sean verificables y trazables.
Provisión de razones para la extracción: incluye automáticamente evidencia o razones textuales que respaldan cada dato extraído, mejorando la transparencia y credibilidad de los resultados.
Segmentación inteligente de documentos: utiliza modelos de segmentación neuronal de última generación (SaT) para dividir con precisión los documentos en párrafos y oraciones, con soporte para múltiples idiomas.
Flujo de extracción unificado: permite definir todo el flujo de trabajo de extracción en una configuración de pipeline única, declarativa y reutilizable, incluyendo contexto anidado y LLM con roles específicos.
Soporte para extracción con contexto anidado: procesa automáticamente la extracción jerárquica de información según la definición del pipeline (por ejemplo, documento > sección > subsección > entidad), simplificando el análisis de documentos complejos.
Procesamiento concurrente integrado: habilita el procesamiento I/O concurrente mediante un simple interruptor use_concurrency=True, acelerando flujos de trabajo de extracción intensivos que involucran múltiples llamadas a LLM.
Seguimiento automático de uso y costos: monitoriza las llamadas a LLM, el uso de tokens y los costos asociados en el flujo de trabajo sin necesidad de configuración adicional.
Lógica integrada de fallback y reintentos: incorpora mecanismos de reintento y permite configurar fácilmente LLM de respaldo, mejorando la resiliencia.
Soporte multilingüe: admite entrada y salida en múltiples idiomas sin necesidad de prompts adicionales.
Soporte para múltiples proveedores de LLM: compatible con LLM en la nube (como OpenAI, Anthropic, Google, Azure OpenAI, etc.) y LLM locales (como Ollama, LM Studio, etc.), ofreciendo una interfaz unificada para facilitar el cambio entre ellos.
Estrategias de optimización: proporciona estrategias para optimizar la precisión, velocidad y costo, así como recomendaciones para manejar documentos largos y seleccionar el LLM adecuado.
Serialización de resultados: permite guardar y cargar objetos de documentos, pipelines y configuraciones de LLM, evitando llamadas costosas y repetidas a LLM.
Convertidor de documentos
ContextGem ofrece un convertidor de documentos integrado que permite transformar archivos DOCX en datos utilizables por LLM. Es capaz de extraer información que otras herramientas de código abierto suelen pasar por alto, como tablas desalineadas, anotaciones, notas al pie, cuadros de texto, encabezados/pies de página e imágenes incrustadas, conservando la estructura del documento y metadatos enriquecidos para un mejor análisis por parte del LLM.
Casos de uso de ContextGem
ContextGem se enfoca en realizar análisis profundos y precisos a partir de un único documento, aprovechando la ventana de contexto ampliada y las capacidades de los LLM modernos. Es adecuado para escenarios donde se necesita extraer datos e ideas precisas de documentos específicos, como el análisis de contratos legales, el procesamiento de documentos financieros, entre otros. Sin embargo, actualmente no admite consultas entre documentos ni recuperación en todo un corpus; para estos casos de uso, los sistemas RAG modernos (como LlamaIndex, Haystack) pueden ser más apropiados.
Enlace del proyecto ContextGem
https://github.com/shcherbak-ai/contextgem









