
 Asistente de guiones▸
 Apps AI
 Noticias AI
ACE-Step: un nuevo modelo base de código abierto para la generación de música
小编 ·

ACE-Step: un nuevo modelo base de código abierto para la generación de música
¿Qué es ACE-Step?
ACE-Step es un nuevo modelo fundacional de código abierto para la generación de música, desarrollado conjuntamente por ACE Studio y StepFun. Integra técnicas de generación basadas en difusión, el autocodificador de compresión profunda de Sana y un transformador lineal ligero, superando las limitaciones de los métodos actuales de generación musical en cuanto a velocidad de generación, coherencia musical y controlabilidad. El modelo puede sintetizar hasta 4 minutos de música en 20 segundos con una GPU A100, siendo 15 veces más rápido que las líneas base basadas en LLM. Además, logra una mejor coherencia musical y alineación de letras en métricas de melodía, armonía y ritmo, y admite mecanismos de control avanzado como clonación de voz y edición de letras, aunque también presenta limitaciones como inconsistencia en los resultados y bajo rendimiento en ciertos estilos específicos.
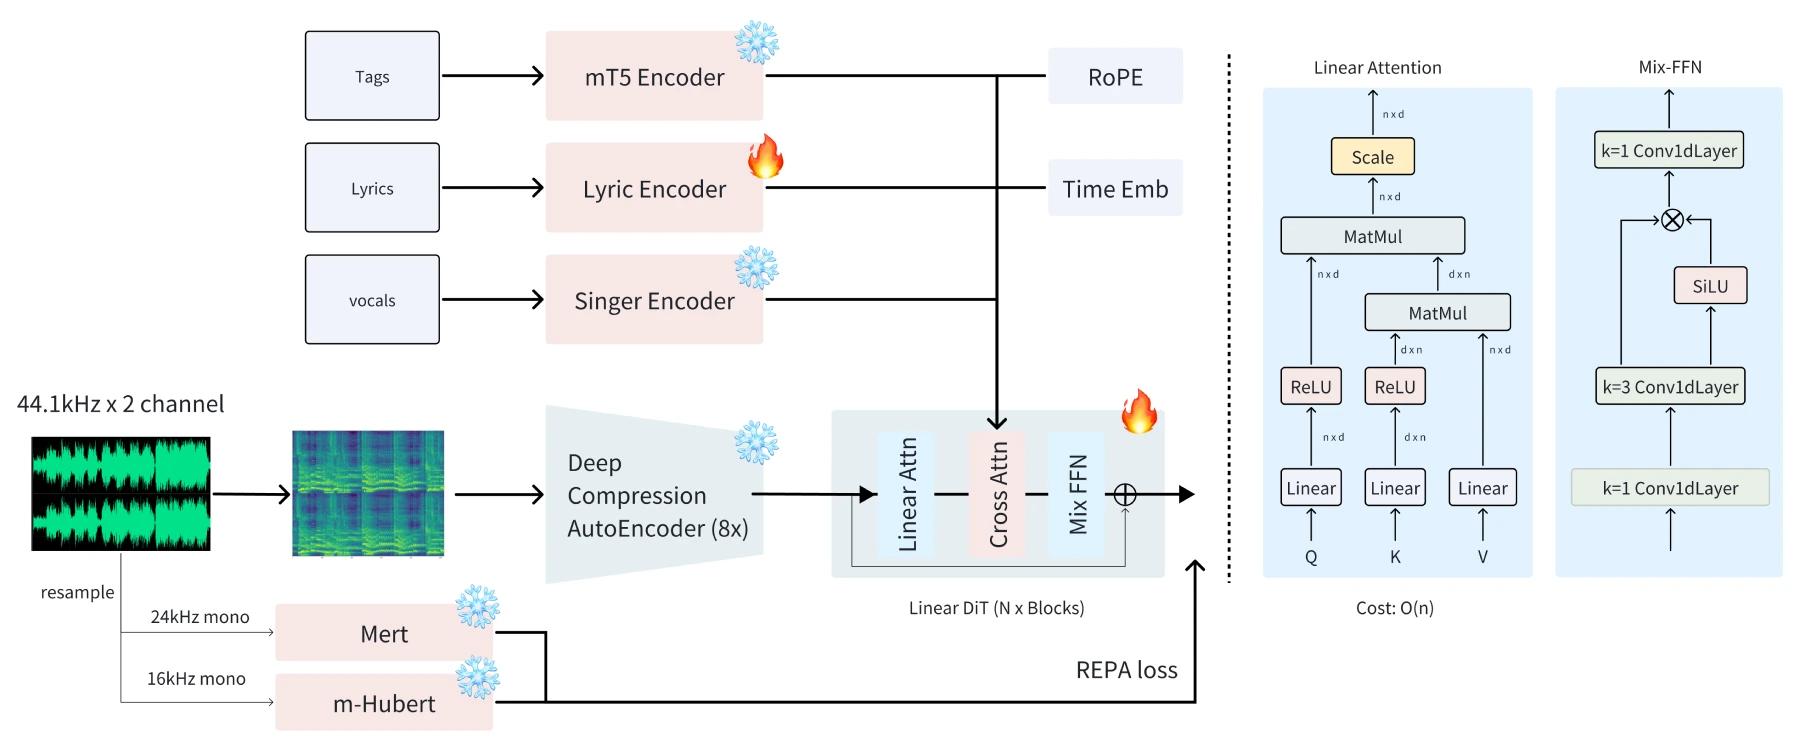
Arquitectura central de ACE-Step
ACE-Step logra una convergencia rápida al integrar modelos de difusión, un autocodificador de compresión profunda y un transformador lineal ligero, y al utilizar MERT y m-hubert para alinear representaciones semánticas (REPA) durante el entrenamiento. Este diseño arquitectónico le permite alcanzar un equilibrio entre velocidad de generación, coherencia musical y controlabilidad.
Ventajas de ACE-Step
Velocidad de generación: ACE-Step puede generar hasta 4 minutos de música en tan solo 20 segundos en una GPU NVIDIA A100, siendo 15 veces más rápido que los métodos de referencia basados en modelos de lenguaje grandes (LLM).
Coherencia musical: el modelo muestra una coherencia musical superior y una mejor alineación de letras en métricas de melodía, armonía y ritmo.
Preservación de detalles: ACE-Step preserva detalles acústicos de grano fino y admite mecanismos de control avanzado, como clonación de voz, edición de letras, mezcla y generación de pistas.
Características y funciones de ACE-Step
Diversidad de estilos: admite estilos musicales populares y maneja varios formatos de descripción, como etiquetas cortas, textos descriptivos o descripciones de escenarios de aplicación. También se comporta bien en pruebas experimentales de entrada y puede generar pistas instrumentales con diversos instrumentos.
Soporte multilingüe: admite 19 idiomas, aunque debido al desequilibrio en los datos, algunos idiomas tienen un rendimiento inferior. Los 10 idiomas con mejor desempeño incluyen inglés, chino, ruso, entre otros.
Alta controlabilidad:
Variations Generation: utiliza técnicas de optimización en tiempo de inferencia sin entrenamiento, ajustando la proporción de mezcla entre el ruido inicial y el nuevo ruido gaussiano para generar variantes con diferente grado de similitud a la canción original.
Repaint: añade ruido a la entrada de audio objetivo y aplica restricciones de enmascaramiento durante el proceso ODE, lo que permite modificar partes específicas. Combinado con la técnica de generación de variaciones, también posibilita cambios locales de estilo, letra o voz.
Edit: emplea la técnica flow-edit, capaz de modificar letras sin alterar la melodía, el timbre vocal ni la música de fondo, aunque solo permite editar pequeños fragmentos de la letra a la vez.
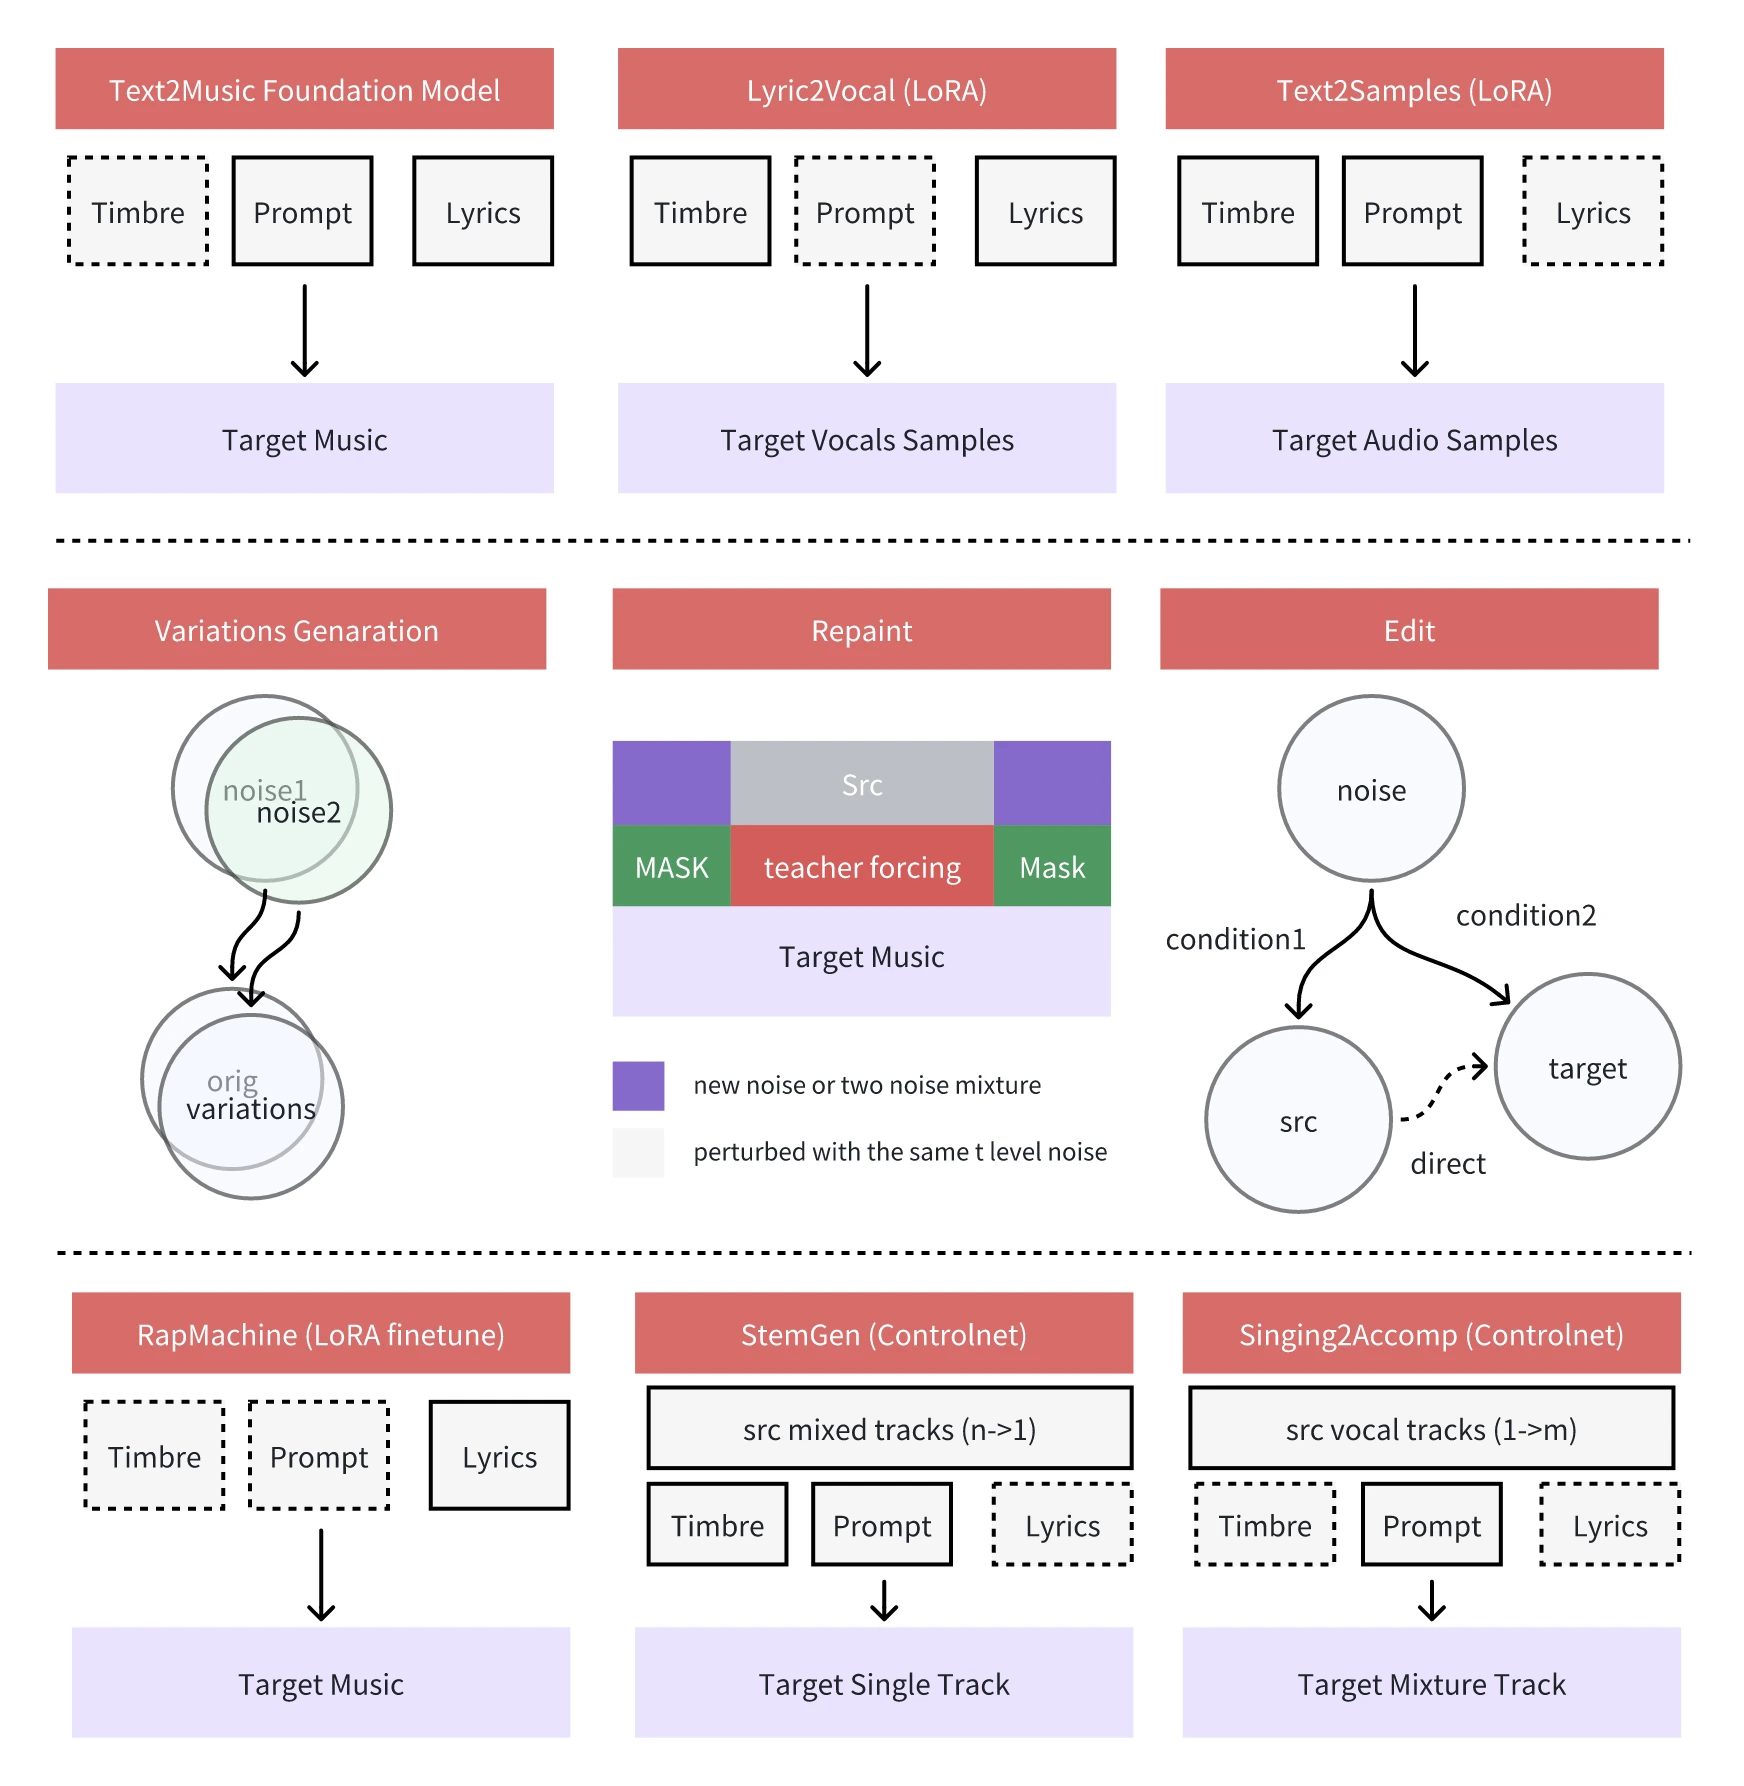
Escenarios de aplicación de ACE-Step
Lyric2Vocal (LoRA): ajuste fino LoRA basado en datos exclusivamente vocales, que permite generar muestras vocales directamente a partir de letras, útil para demostraciones vocales, asistencia en la composición de canciones, entre otros.
Text2Samples (LoRA): ajuste fino LoRA basado en datos puramente instrumentales y de muestras, capaz de generar muestras conceptuales de producción musical a partir de descripciones textuales, útil para crear loops instrumentales, efectos de sonido, etc.
Limitaciones de ACE-Step
Inconsistencia en los resultados: es sensible a la semilla aleatoria y a la duración de la entrada, lo que produce resultados inestables.
Rendimiento desigual por estilos: presenta un desempeño deficiente en ciertos estilos específicos (como el rap chino).
Problemas de continuidad: las transiciones durante operaciones de redibujo o extensión no son naturales.
Calidad vocal mejorable: las voces sintetizadas son bastante ásperas y carecen de detalles.
Granularidad de control insuficiente: requiere un control más preciso de los parámetros musicales.
Optimización de letras multilingües: es necesario mejorar el soporte de letras en varios idiomas para aumentar la precisión y naturalidad.
Preguntas frecuentes sobre ACE-Step
En comparación con otros modelos de generación musical, ¿cuál es la mayor ventaja de ACE-Step?
Respuesta: La mayor ventaja de ACE-Step es que resuelve el dilema entre velocidad de generación, coherencia musical y controlabilidad presente en los modelos actuales. Puede sintetizar hasta 4 minutos de música en 20 segundos con una GPU A100, siendo 15 veces más rápido que los modelos de referencia basados en LLM. Al mismo tiempo, logra una mejor coherencia musical y alineación de letras en métricas de melodía, armonía y ritmo, y ofrece potentes funciones de control, como clonación de voz y edición de letras, funcionalidades difíciles de combinar en otros modelos.
¿Qué problemas presenta ACE-Step en cuanto al soporte multilingüe?
Respuesta: Aunque ACE-Step admite 19 idiomas, debido al desequilibrio en los datos, los idiomas menos comunes tienen un rendimiento inferior. Al procesar letras en varios idiomas, la precisión y naturalidad aún deben mejorarse, por lo que es necesario optimizar aún más el soporte de letras multilingües para elevar el rendimiento general del modelo en diferentes idiomas.
Dentro de los escenarios de aplicación de ACE-Step, ¿a qué etapas creativas corresponden Lyric2Vocal y Text2Samples respectivamente?
Respuesta: Lyric2Vocal, basado en un ajuste fino LoRA con datos exclusivamente vocales, es adecuado para la etapa de demostración vocal en la composición de canciones, ayudando a los creadores a probar rápidamente el efecto de las letras cantadas. También puede usarse para producir pistas guía, asistir en la composición y realizar experimentos de arreglos vocales. Text2Samples, basado en un ajuste fino LoRA con datos puramente instrumentales y de muestras, es adecuado para la creación rápida de loops instrumentales, efectos de sonido y diversos elementos musicales en las fases iniciales de la producción musical, proporcionando muestras conceptuales que aumentan la eficiencia creativa.
Enlaces relacionados
https://ace-step.github.io/









