
 Asistente de guiones▸
 Apps AI
 Noticias AI
UniversalRAG: un nuevo marco para la recuperación cross-modal
小编 ·

UniversalRAG: un nuevo marco para la recuperación cross-modal
¿Qué es UniversalRAG?
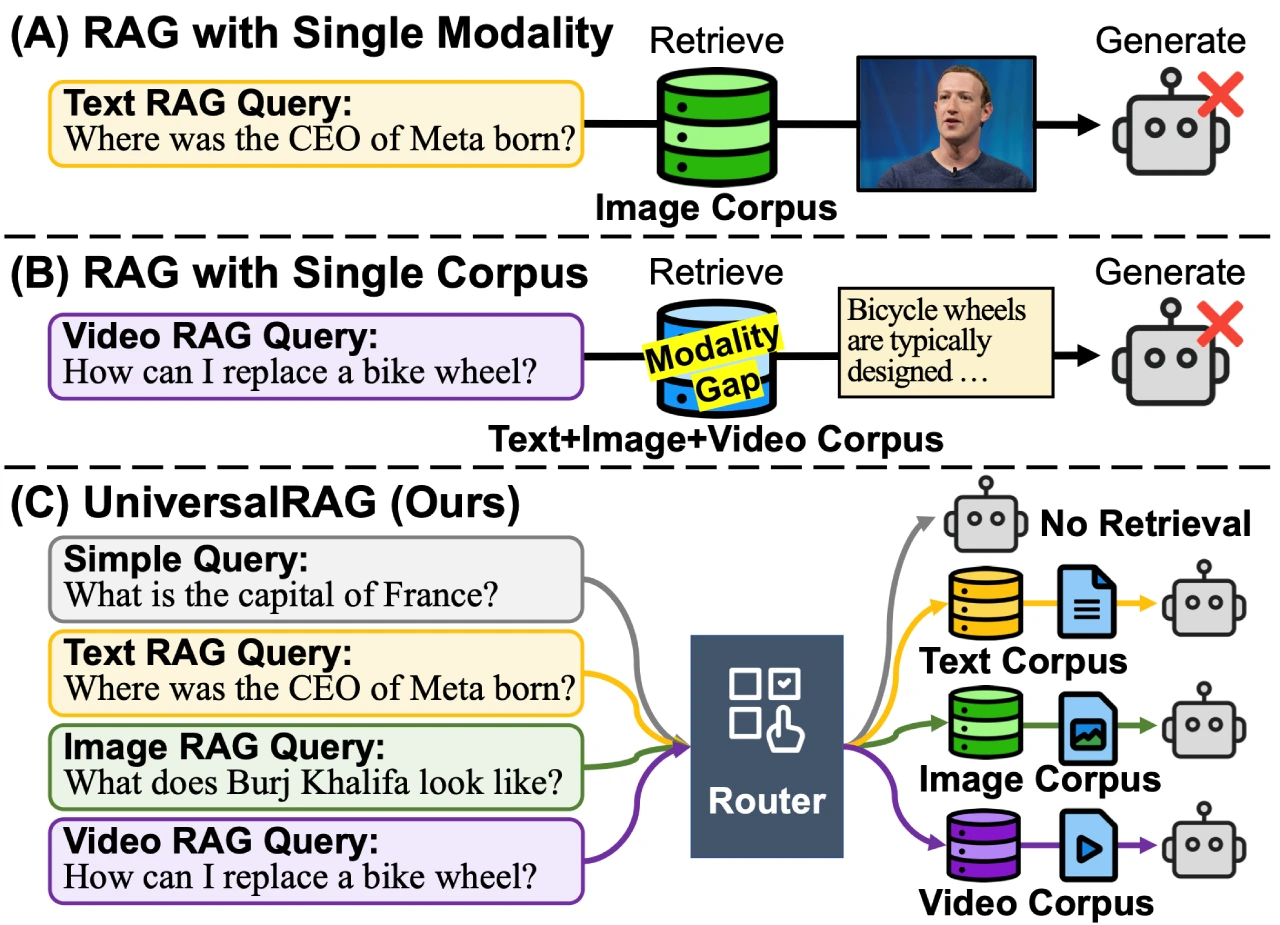
UniversalRAG es un nuevo tipo de marco de Generación Aumentada por Recuperación (RAG) que puede recuperar contenido de múltiples tipos, como texto, imágenes y vídeos, y también puede seleccionar bloques de información de diferentes tamaños según las necesidades, como párrafos, documentos, fragmentos de vídeo o vídeos completos. Este marco cuenta con un "enrutador consciente de la modalidad" que puede seleccionar automáticamente el tipo de contenido más adecuado según las necesidades, evitando sesgos hacia un tipo específico. También puede elegir de forma flexible si se necesita entrenamiento para optimizar el efecto de recuperación según las necesidades de diferentes tareas. Tras las pruebas, UniversalRAG supera a los sistemas tradicionales en múltiples escenarios de prueba, con resultados de recuperación más precisos y efectivos.
Características principales
Mecanismo de enrutamiento consciente de la modalidad:Los métodos RAG tradicionales suelen incrustar forzosamente los datos de todas las modalidades en un espacio de representación unificado, lo que provoca el problema de la "brecha de modalidad", es decir, la recuperación tiende a favorecer el contenido de la misma modalidad que la consulta. UniversalRAG introduce un mecanismo de enrutamiento consciente de la modalidad que identifica dinámicamente el corpus específico de la modalidad más adecuada y realiza búsquedas específicas dentro de él.
Recuperación multi-granularidad:Además de las diferencias de modalidad, UniversalRAG también tiene en cuenta la granularidad de los datos (es decir, el tamaño o la unidad de cada entrada en el corpus). Divide cada modalidad en varios niveles de granularidad, por ejemplo, el texto se divide en nivel de párrafo y nivel de documento, y el vídeo en fragmentos cortos y vídeos completos. Este diseño permite realizar búsquedas refinadas en función de la complejidad y el alcance de la consulta.
Soporte multimodal:UniversalRAG admite la recuperación en múltiples modalidades, como texto, imágenes y vídeo, y puede seleccionar dinámicamente la modalidad más adecuada según los requisitos de la consulta.
Objetivos principales
Recuperación de conocimiento multimodal: diseñar un mecanismo de enrutamiento consciente de la modalidad para evitar el problema de la brecha de modalidad causado por forzar todas las modalidades en un espacio de representación unificado, que puede identificar dinámicamente el corpus específico de la modalidad más adecuada y realizar búsquedas específicas.
Integración de conocimiento multi-granularidad: organizar cada modalidad en múltiples niveles de granularidad, como nivel de párrafo, nivel de documento, nivel de imagen, nivel de clip y nivel de vídeo, etc., capaz de ajustar finamente la búsqueda según la complejidad y el alcance de la consulta, adaptándose de forma más flexible a diferentes necesidades de consulta.
Método de investigación
Mecanismo de enrutamiento consciente de la modalidad:mantiene espacios de incrustación independientes para cada modalidad e introduce un módulo de enrutamiento. Este módulo puede seleccionar dinámicamente el corpus específico de la modalidad más adecuada para la recuperación según los requisitos modales de la consulta, evitando la brecha de modalidad.
Construcción de corpus multi-granularidad:considera la granularidad de los datos y organiza cada modalidad en múltiples niveles de granularidad, lo que permite al sistema seleccionar fuentes de conocimiento con la granularidad adecuada según la complejidad y el alcance de la consulta, proporcionando respuestas más precisas y completas.
Implementación del módulo de enrutamiento:
Enrutamiento sin entrenamiento: aprovecha el conocimiento y la capacidad de razonamiento de modelos de lenguaje grandes preentrenados (como GPT - 4o) para clasificar las consultas y seleccionar el tipo de recuperación mediante la provisión de instrucciones y ejemplos contextuales. No requiere entrenamiento adicional, pero puede estar limitado por los sesgos y las fronteras de conocimiento del modelo preentrenado.
Enrutamiento con entrenamiento: entrena el módulo de enrutamiento mediante la construcción de un conjunto de datos de entrenamiento, lo que le permite predecir con mayor precisión el tipo óptimo de recuperación para una consulta dada y adaptarse mejor a tareas y conjuntos de datos específicos.
Configuración experimental y resultados
Configuración experimental
Se realizaron experimentos en múltiples conjuntos de datos de referencia que cubren diferentes modalidades (texto, imagen, vídeo) y configuraciones de recuperación, utilizando varios modelos de lenguaje visual grandes (LVLMs) como generadores y configurando múltiples métodos de referencia para su comparación.
Resultados experimentales
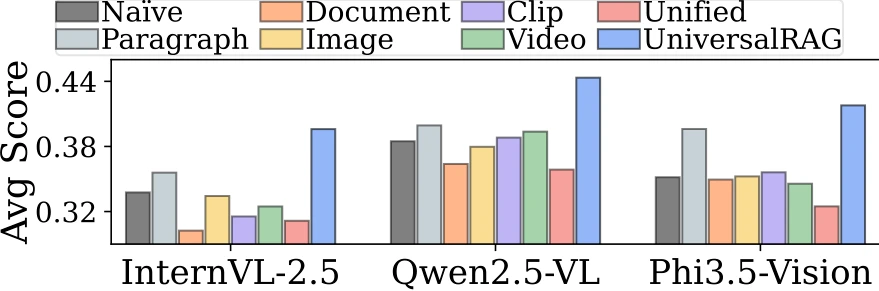
UniversalRAG supera a todos los métodos de referencia en la puntuación media en todos los conjuntos de datos de referencia, destacando en consultas que requieren conocimiento multimodal.
El modelo de enrutamiento con entrenamiento supera al modelo de enrutamiento sin entrenamiento en cuanto al rendimiento del módulo de enrutamiento, pero el modelo de enrutamiento sin entrenamiento sigue superando a otros métodos de referencia, lo que indica que el enrutamiento de cero disparos es efectivo dentro del marco UniversalRAG.
Admitir corpus de texto y vídeo con diferentes granularidades puede mejorar significativamente el rendimiento de UniversalRAG; en comparación con los modelos sin control de granularidad, puede seleccionar el nivel de granularidad adecuado según la consulta y generar respuestas más precisas.
En los conjuntos de datos de dominios cruzados, GPT - 4o como modelo de enrutamiento sin entrenamiento logra la mayor precisión de enrutamiento y la mayor puntuación media en preguntas y respuestas, mientras que el modelo de enrutamiento con entrenamiento presenta problemas de sobreajuste debido a la diversidad insuficiente de consultas en los datos de entrenamiento. La introducción de un método de enrutamiento conjunto, que combina las ventajas del enrutamiento con entrenamiento y sin entrenamiento, logra un mejor rendimiento en los conjuntos de datos de dominios cruzados.
Ventajas
Mayor precisión factual: al recuperar información de fuentes de conocimiento de múltiples modalidades y granularidades, UniversalRAG puede respaldar de forma más completa las respuestas del modelo, reduciendo los errores causados por una única modalidad o una granularidad insuficiente.
Flexibilidad: este marco puede manejar de forma flexible diferentes tipos de consultas, ya sean preguntas factuales simples o preguntas analíticas complejas.
Escalabilidad: al ampliar la lógica de enrutamiento, UniversalRAG puede integrar nuevas modalidades sin problemas, sin necesidad de modificar los recuperadores específicos de modalidad existentes.
Página del proyecto:https://universalrag.github.io/
Artículo:https://arxiv.org/abs/2504.20734









