
 Asistente de guiones▸
 Apps AI
 Noticias AI
LLMWhisperer: herramienta de análisis de documentos para convertirlos en texto estructurado
小编 ·

LLMWhisperer: herramienta de análisis de documentos para convertirlos en texto estructurado
¿Qué es LLMWhisperer?
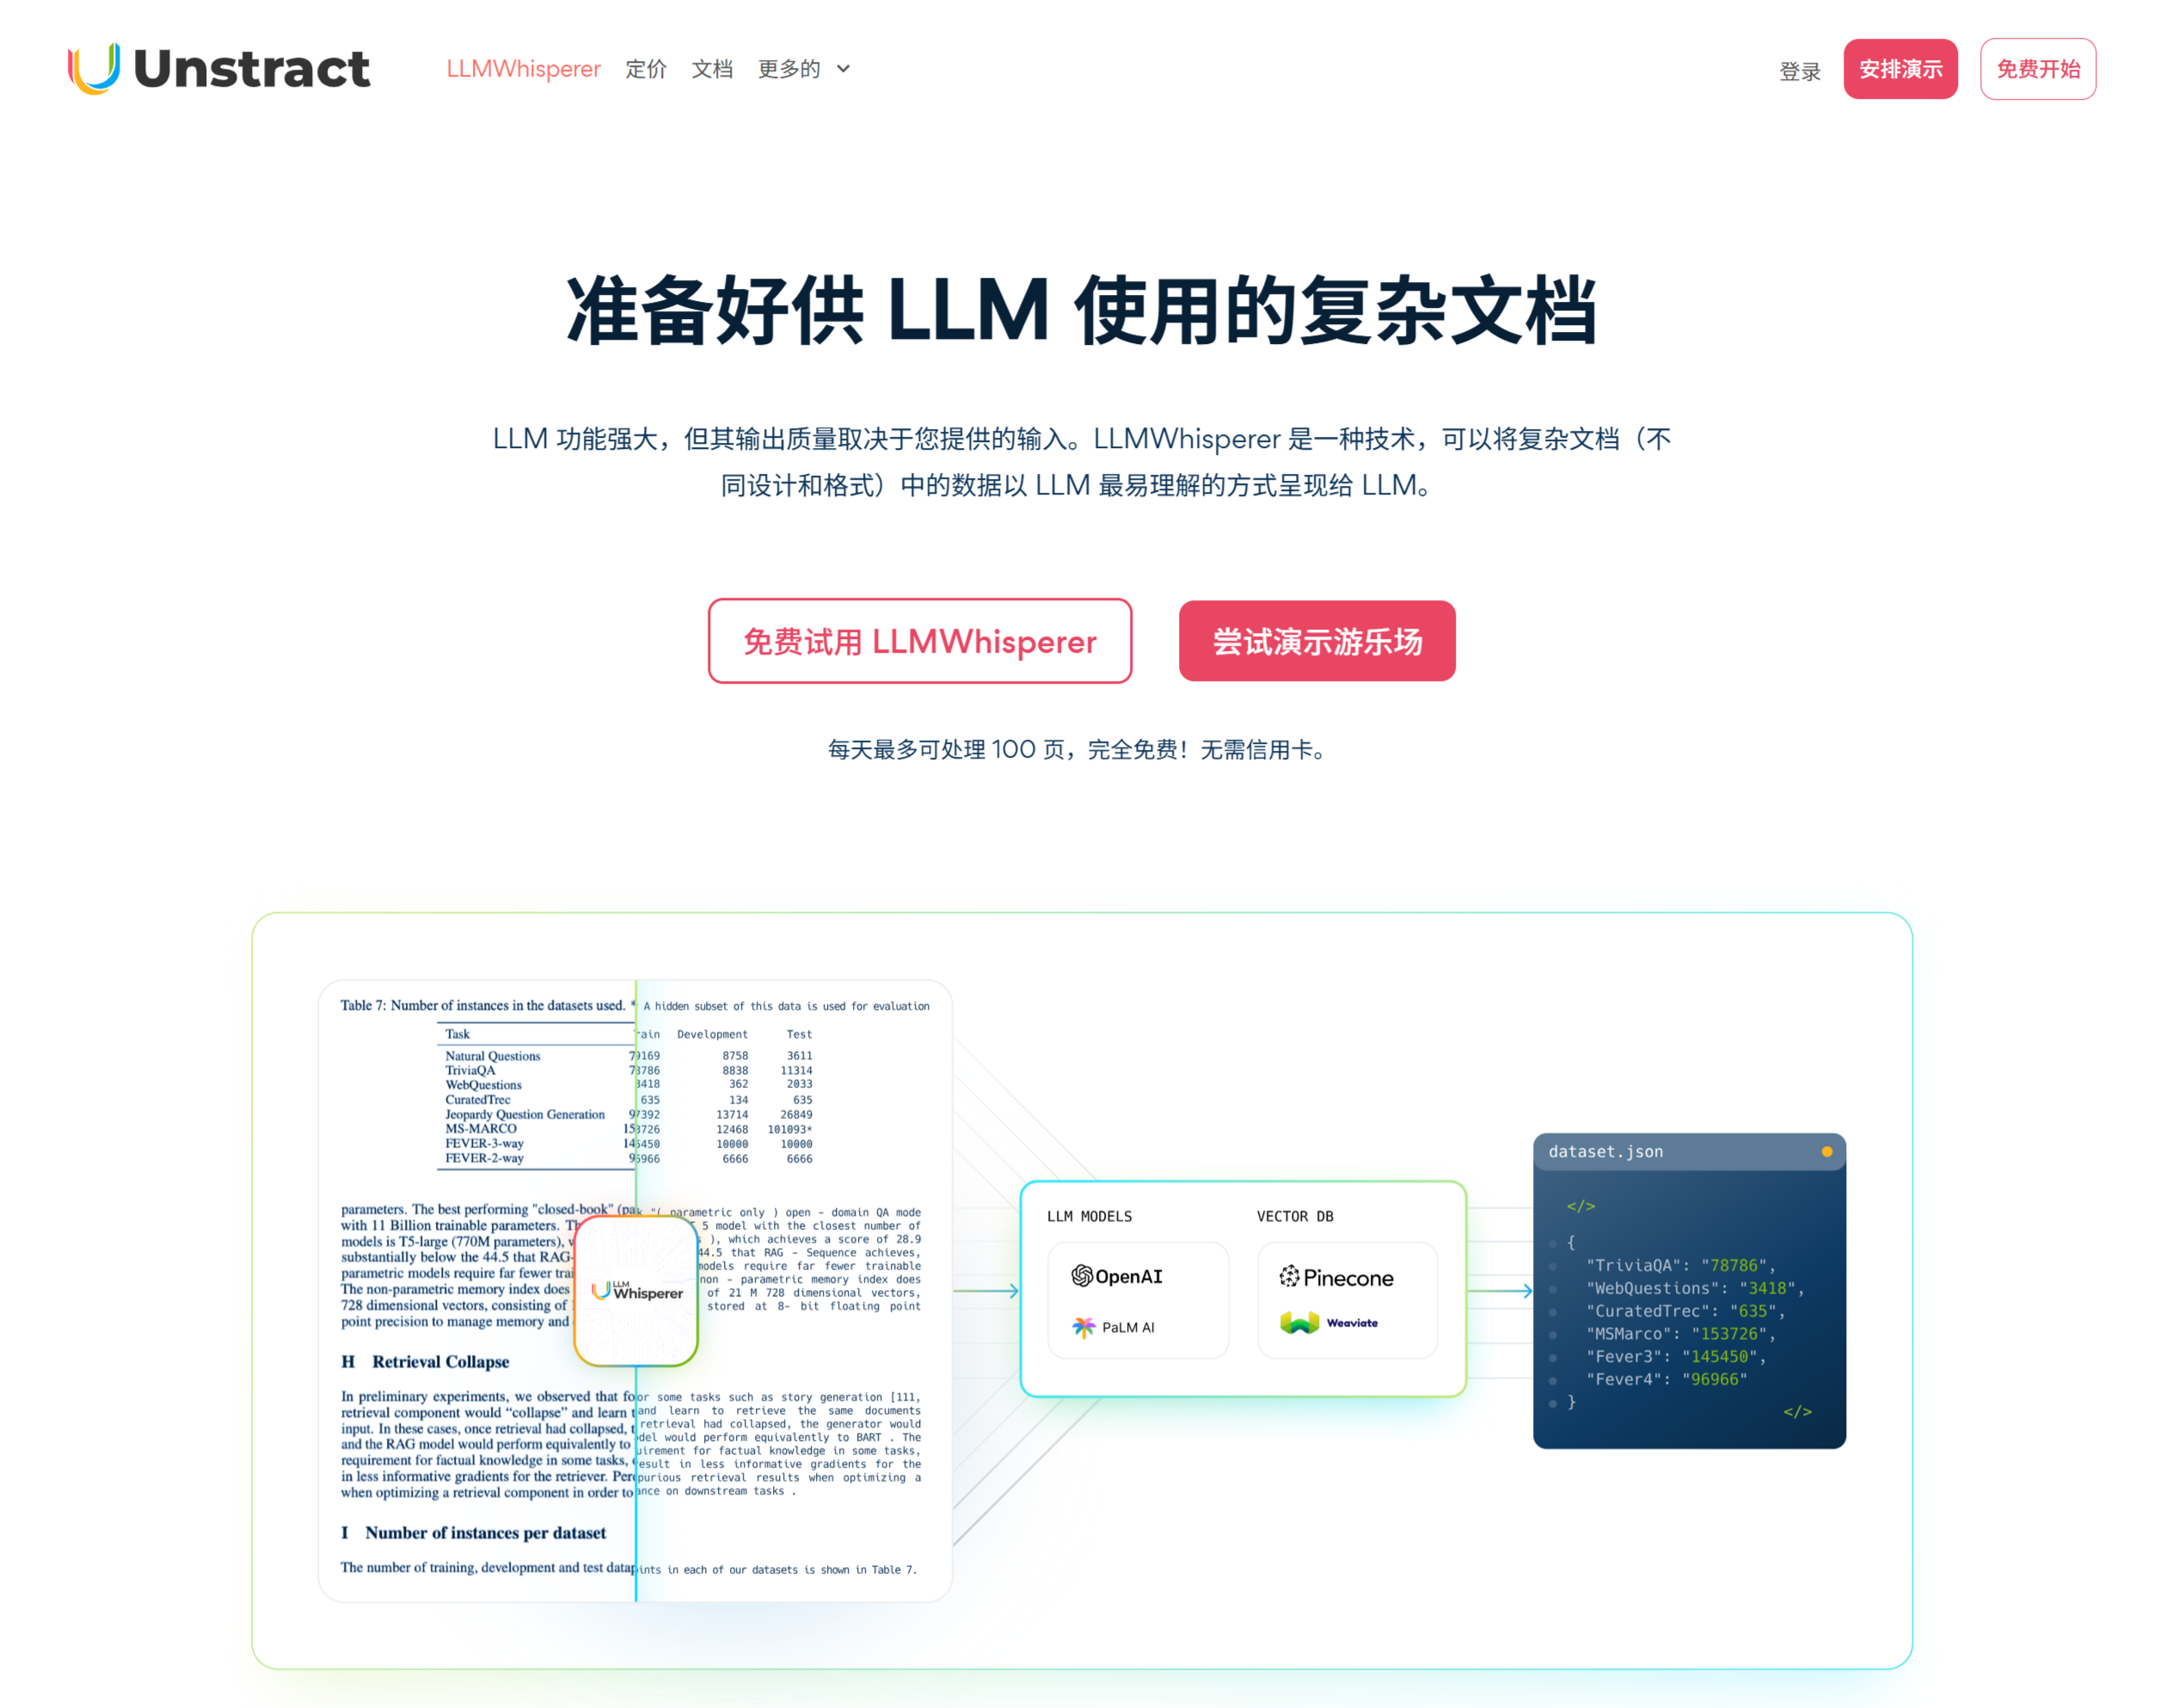
LLMWhisperer es una herramienta capaz de analizar documentos complejos y convertirlos a formato LLM, extrayendo de forma eficiente texto, URL, metadatos y otra información profunda de los documentos, y generando una salida en un formato estructurado y claro. Es compatible con múltiples formatos como PDF e imágenes, y también puede extraer automáticamente información importante como nombres y direcciones. Procesa 100 páginas de documentos al día de forma gratuita.
También dispone de un entorno de pruebas en línea, ofrece API y kits de desarrollo en JS/Python, lo que permite una integración sencilla con tecnologías habituales como Next.js, Node.js y bases de datos. Su uso permite ahorrar una cantidad considerable de costes en el procesamiento de entradas de imágenes, siendo especialmente adecuado para escenarios como facturas, documentos de identidad y notas de gastos.
Características y funciones de LLMWhisperer
Preservación del diseño del documento: el modo de preservación del diseño de LLMWhisperer puede conservar la estructura original del documento, incluyendo tablas, párrafos, diseños multicolumna, etc., asegurando que los datos extraídos sean coherentes con el documento original.
Cambio de modo automático: la herramienta es capaz de identificar automáticamente el tipo de documento y alternar entre el modo texto y el modo OCR. Si el documento es una imagen escaneada o contiene texto manuscrito, cambiará automáticamente al modo OCR.
Reconocimiento de elementos de formulario: LLMWhisperer es capaz de reconocer casillas de verificación y botones de opción en formularios PDF, y presenta sus valores como texto sin procesar, lo que facilita la comprensión por parte del LLM.
Compresión automática: al procesar documentos, LLMWhisperer puede comprimir automáticamente los tokens innecesarios, reduciendo el tiempo de procesamiento y los costes, al mismo tiempo que conserva la información clave.
Soporte multilingüe: LLMWhisperer admite más de 300 idiomas y es capaz de procesar documentos multilingües, incluidos alfabetos no latinos (como árabe, chino, japonés, etc.).
Soporte de múltiples formatos de documento: compatible con PDF, imágenes (JPEG, PNG, etc.), archivos de MS Office (Word, Excel, PowerPoint), formatos OpenDocument (ODT, ODP, ODS) y archivos de texto plano (TXT).
Cómo usar LLMWhisperer
Integración mediante API: LLMWhisperer ofrece una interfaz API que permite integrarla en los sistemas existentes para lograr el preprocesamiento automatizado de documentos.
Bibliotecas cliente: los usuarios pueden llamar a sus funcionalidades instalando la biblioteca cliente de LLM Whisperer (como llmwhisperer-client para Python).
Pruebas en línea: LLMWhisperer proporciona un entorno Playground en línea donde los usuarios pueden subir documentos para realizar pruebas en tiempo real, sin necesidad de registrarse ni instalar ningún software.
Capacidades de optimización
Cambio de modo automático: al procesar un documento, si la salida extraída en modo texto es insuficiente, cambia automáticamente al modo OCR.
Compresión automática: comprime las etiquetas que no aportan valor a la salida mientras se preserva el diseño, reduciendo el tiempo de procesamiento y los costes de los LLMs.
Control de preprocesamiento: permite controlar el preprocesamiento de las imágenes escaneadas, ajustando parámetros como el filtro de mediana y el desenfoque gaussiano a través de la API.
Sitio web oficial:https://unstract.com/llmwhisperer/









