
 Asistente de guiones▸
 Apps AI
 Noticias AI
Muyan-TTS: modelo TTS de código abierto y entrenable de Muyan, diseñado para podcasts
小编 ·

Muyan-TTS: modelo TTS de código abierto y entrenable de Muyan, diseñado para podcasts
¿Qué es Muyan-TTS?
Muyan-TTS es un modelo TTS de código abierto y entrenable publicado por Muyan Intelligence de Pekín, diseñado específicamente para podcasts, con un presupuesto controlado por debajo de los 50.000 dólares. Muyan-TTS se preentrena con más de 100.000 horas de datos de audio de podcasts, admite síntesis TTS de cero disparos, es capaz de generar voz de alta calidad y también admite ajuste adaptativo del hablante mediante la voz objetivo durante unas decenas de minutos.
Características del modelo Muyan-TTS
Preentrenamiento a gran escala: Muyan-TTS se basa en el modelo Llama-3.2-3B, preentrenado con más de 100.000 horas de datos de audio de podcasts, lo que permite la síntesis de texto a voz con IA de cero disparos y la generación de voz de alta calidad.
Compatibilidad con la adaptación del hablante: mediante varias decenas de minutos de datos de voz del hablante objetivo, Muyan-TTS puede adaptarse aún más a las características vocales de un hablante específico, logrando así una síntesis de voz altamente personalizada.
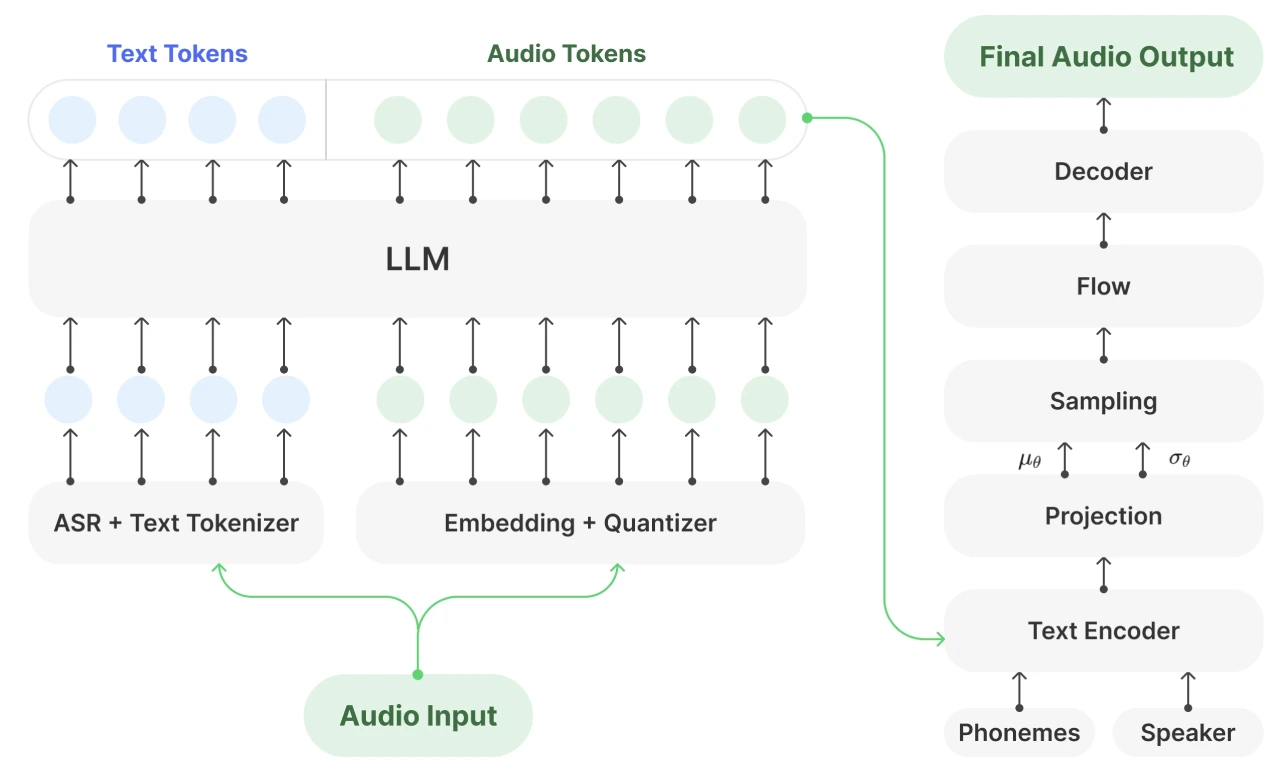
Diseño de la arquitectura: Muyan-TTS adopta la estructura de dos etapas de GPT-SoVITS. La parte del modelo de lenguaje utiliza Llama-3.2-3B como backbone para continuar con el preentrenamiento, y la parte del decodificador utiliza la arquitectura SoVITS, combinando la capacidad de modelado semántico de los LLM con las características fonema a fonema (G2P) del modelo VITS, lo que reduce eficazmente las alucinaciones.
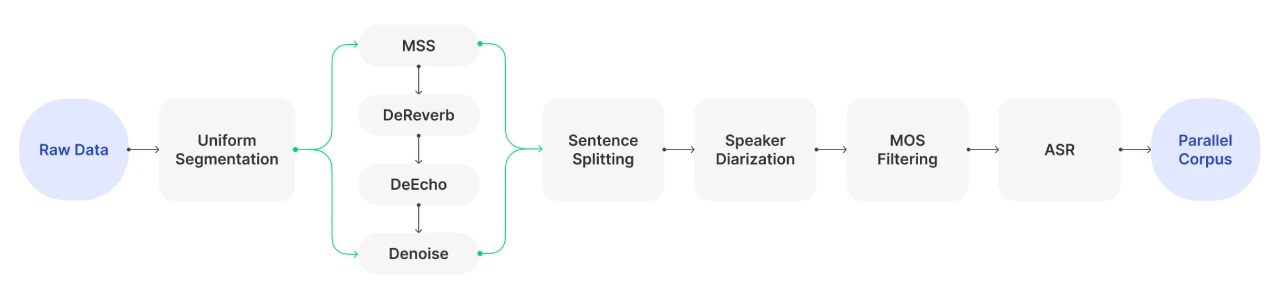
Procesamiento de datos: se ha construido un corpus paralelo que contiene más de 100.000 horas de voz de alta calidad con sus transcripciones correspondientes, adecuado para el entrenamiento TTS en escenarios de audio largo como podcasts.
Código abierto y entrenamiento
Información de código abierto: Muyan-TTS es totalmente de código abierto y proporciona un flujo completo de recopilación y procesamiento de datos, métodos detallados de entrenamiento y un marco de inferencia optimizado. Su código y modelo están disponibles en GitHub.
Coste de entrenamiento: en cuanto al coste de entrenamiento, suponiendo que los precios de alquiler de las GPU A10 y A100 sean de 0,5 y 1 dólar por hora, respectivamente, el coste total de entrenamiento de Muyan-TTS ronda los 50.540 dólares.
Rendimiento
Síntesis de cero disparos: en el conjunto de datos LibriSpeech, Muyan-TTS muestra un rendimiento excelente en la síntesis de cero disparos; su tasa de error de palabras solo es superada por CosyVoice2, y su puntuación media de opinión es superior a la de Spark-TTS y GPT-SoVITS v3.
Modelo ajustado con supervisión: Muyan-TTS-SFT, una vez ajustado con supervisión, supera al modelo base en calidad de voz y similitud con el hablante, aunque presenta una ligera disminución en la WER.
Velocidad de inferencia: Muyan-TTS presenta la velocidad de inferencia más rápida entre todos los modelos probados: solo necesita 0,33 segundos para sintetizar 1 segundo de voz, por lo que es adecuado para escenarios de generación de voz en tiempo real.
Escenarios de aplicación de Muyan-TTS
Muyan-TTS es adecuado para múltiples formatos de contenido de audio, como narración de presentadores, reproducción de entrevistas y resúmenes de voz. Tiene en cuenta la calidad de la síntesis, la capacidad de personalización y la eficiencia operativa, siendo adecuado para escenarios de audio largo como podcasts.
Limitaciones
Depende del módulo G2P del decodificador, requiere la secuencia completa de fonemas para llevar a cabo la síntesis y no permite la inferencia en streaming.
Los datos de entrenamiento son principalmente en inglés, por lo que su capacidad de síntesis de voz multilingüe es limitada.
Debido a la falta de anotaciones a nivel de instrucción en el corpus de entrenamiento, Muyan-TTS actualmente no admite tareas TTS con seguimiento de instrucciones.
Instalación y uso de Muyan-TTS
Pasos de instalación
1. Clone el repositorio y cree un entorno virtual:
git clone https://github.com/MYZY-AI/Muyan-TTS.git
cd Muyan-TTS
conda create -n muyan-tts python=3.10 -y
conda activate muyan-tts
make build
2. Instale FFmpeg (sistema Ubuntu):
sudo apt update
sudo apt install ffmpeg
3. Descargue los modelos:
Los modelos Muyan-TTS y Muyan-TTS-SFT se pueden descargar desde Hugging Face o ModelScope.
También es necesario descargar los pesos de chinese-hubert-base.
Coloque todos los modelos descargados en el directorio pretrained_models.
Modo de uso
Ejecute el siguiente comando para realizar la síntesis de voz:
python tts.py
El código principal de inferencia es el siguiente:
async def main(model_type, model_path):
tts = Inference(model_type, model_path, enable_vllm_acc=False)
wavs = await tts.generate(
ref_wav_path="assets/Claire.wav",
prompt_text="Although the campaign was not a complete success, it did provide Napoleon with valuable experience and prestige.",
text="Welcome to the captivating world of podcasts, let's embark on this exciting journey together."
)
output_path = "logs/tts.wav"
with open(output_path, "wb") as f:
f.write(next(wavs))
print(f"Speech generated in {output_path}")
Repositorio de GitHub:https://github.com/MYZY-AI/Muyan-TTS









