
 Asistente de guiones▸
 Apps AI
 Noticias AI
Alibaba lanza Qwen3: dos modos de pensamiento y capacidades multilingües
小编 ·

Alibaba lanza Qwen3: dos modos de pensamiento y capacidades multilingües
Alibaba lanzó oficialmente la serie de modelos Qwen3 el 29 de abril de 2025. Se trata del miembro más reciente de la serie de modelos de lenguaje de gran tamaño Qwen. Varios modelos, como el modelo insignia Qwen3-235B-A22B y el modelo MoE compacto Qwen3-30B-A3B, han obtenido resultados destacados en pruebas de referencia de código, matemáticas y capacidades generales. Qwen3 ha publicado en código abierto los pesos de varios modelos y está disponible en múltiples plataformas.
Qwen3 admite dos modos de pensamiento, posee capacidades multilingües y ha optimizado las capacidades de Agent y de código. Su volumen de datos de preentrenamiento alcanza aproximadamente 36 billones de tokens, el preentrenamiento se divide en tres etapas y el postentrenamiento adopta un flujo de entrenamiento en cuatro etapas.
Aspectos destacados del modelo
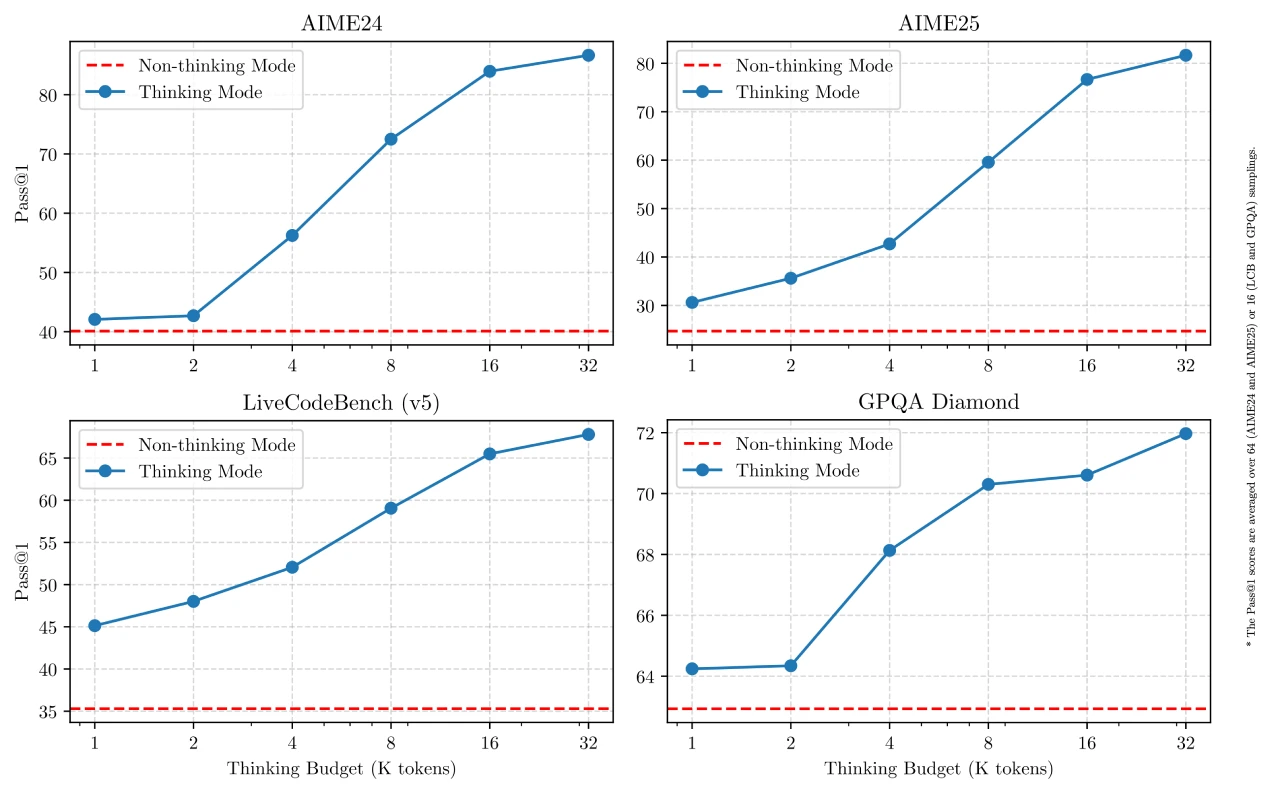
Múltiples modos de pensamiento: admite dos modos, pensamiento y no pensamiento. El modo de pensamiento es adecuado para problemas complejos, donde el modelo razona paso a paso; el modo de no pensamiento es adecuado para problemas sencillos, ofreciendo respuestas rápidas. La combinación de ambos modos mejora la capacidad de control del "presupuesto de pensamiento", lo que permite a los usuarios configurarlo según sus necesidades.
Capacidades multilingües: admite 119 idiomas y dialectos, abarcando múltiples familias lingüísticas como las indoeuropeas y las sinotibetanas, lo que abre posibilidades para usos internacionales.
Capacidades mejoradas de Agent: se han optimizado las capacidades de Agent y de código, reforzando el soporte para MCP. Mediante Qwen - Agent se reduce la complejidad del código en la invocación de herramientas.
Rendimiento de Qwen3
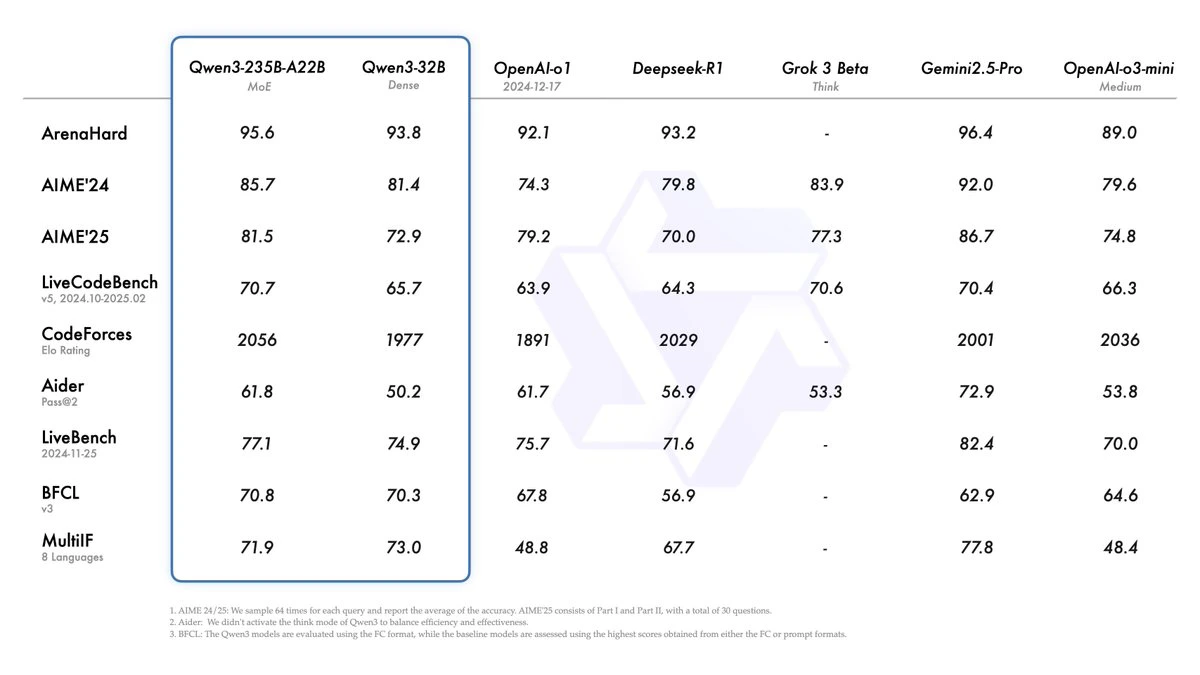
Modelo insignia: Qwen3-235B-A22B es el modelo insignia de la serie, con más de 235 000 millones de parámetros totales y más de 22 000 millones de parámetros activados. En pruebas de referencia de código, matemáticas y capacidades generales, este modelo ofrece resultados altamente competitivos en comparación con modelos de primer nivel como DeepSeek-R1, o1 y o3-mini de Openai, Grok-3 de Musk y Gemini-2.5-Pro de Google.
Modelo compacto: el modelo MoE compacto Qwen3-30B-A3B cuenta con un número de parámetros activados equivalente al 10 % de QwQ-32B, pero ofrece un rendimiento superior. Además, modelos pequeños como Qwen3-4B pueden igualar el rendimiento de Qwen2.5-72B-Instruct.
Características técnicas de Qwen3
Modelo de razonamiento híbrido: Qwen3 es el primer "modelo de razonamiento híbrido" en China, que integra el "pensamiento rápido" y el "pensamiento lento" en un mismo modelo. Este diseño permite al modelo realizar razonamientos profundos al resolver problemas complejos y responder rápidamente ante solicitudes sencillas.
Soporte multilingüe: Qwen3 admite 119 idiomas y se ha entrenado con cerca de 36 billones de tokens, siendo su volumen de datos de entrenamiento el doble que el de Qwen2.5.
Longitud de contexto: Qwen3 admite una longitud de contexto de hasta 256K, lo que le permite abordar tareas complejas como el análisis de documentos extensos, la generación de código y diálogos de múltiples turnos.
Rendimiento y coste del modelo Qwen3
Versión insignia Qwen3-235B-A22B: cuenta con 235 000 millones de parámetros totales y 22 000 millones de parámetros activados. En comparación con DeepSeek-R1, su número total de parámetros es solo un tercio del de este, y se estima que el coste de despliegue se reduzca a menos de la mitad. Además, este modelo permite activar bajo demanda el modo "pensamiento profundo", y es posible su despliegue local con solo 4 tarjetas H20.
Qwen3-30B-A3B: cuenta con 30 000 millones de parámetros totales y 3 000 millones de parámetros activados, con un rendimiento general comparable al de Qwen2.5-32B.
Funcionalidades de Qwen3
Soporte nativo del protocolo MCP: la serie Qwen3 cuenta con capacidad de llamada a herramientas y, combinada con su propio framework Qwen-Agent, reduce en gran medida la complejidad de la programación, admite tareas de operación de Agent en teléfonos móviles y ordenadores, e impulsa la evolución de la IA desde la conversación hacia la ejecución.
Soporte multilingüe: admite 119 idiomas, entre ellos chino, inglés, francés, español, ruso, árabe, etc.
Modelos de código abierto: la serie Qwen3 ha publicado en código abierto un total de 8 modelos, entre los que se incluyen:
6 modelos Dense: 0.6B, 1.7B, 4B, 8B, 14B, 32B
2 modelos MoE: Qwen3-30B-A3B y la versión insignia Qwen3-235B-A22B
El modelo más pequeño, Qwen3-0.6B: de tamaño ligero, es muy adecuado para su despliegue en dispositivos edge como teléfonos móviles, manteniendo al mismo tiempo buenas capacidades de comprensión y generación, lo que lo hace ideal para aplicaciones inteligentes en el extremo.
Proceso de entrenamiento
Preentrenamiento: el conjunto de datos se ha ampliado significativamente en comparación con Qwen2.5, alcanzando aproximadamente 36 billones de tokens, el doble que Qwen2.5. Las fuentes de datos incluyen la web, documentos PDF, etc., y se han utilizado modelos expertos para sintetizar datos de matemáticas y código. El preentrenamiento se divide en tres etapas: desde el entrenamiento de habilidades lingüísticas básicas, pasando por el aumento de datos densos en conocimiento, hasta la ampliación de la longitud de contexto a 32K tokens.
Postentrenamiento: se adopta un flujo de entrenamiento en cuatro etapas, que incluye arranque en frío con cadenas de pensamiento largas, aprendizaje por refuerzo con cadenas de pensamiento largas, fusión de modos de pensamiento y aprendizaje por refuerzo general, con el fin de desarrollar un modelo híbrido con capacidades de razonamiento y respuesta rápida.
Instrucciones de uso
Uso básico: hay código de ejemplo estándar para utilizar Qwen3-30B-A3B con transformers de Hugging Face, y se puede cambiar el modo de pensamiento modificando el parámetro enable_thinking.
Despliegue: con sglang>=0.4.6.post1 o vllm>=0.8.4 es posible crear un endpoint de API compatible con la API de OpenAI; retirando parámetros específicos se puede desactivar el modo de pensamiento.
Desarrollo local: se pueden utilizar herramientas como ollama, LMStudio, llama.cpp y ktransformers para el desarrollo local.
Uso avanzado: se ofrece un mecanismo de conmutación flexible que permite alternar el modo de pensamiento turno a turno añadiendo /think y /no_think en los mensajes del usuario o del sistema.
Enlaces relacionados
Blog: https://qwenlm.github.io/zh/blog/qwen3/
HF: https://huggingface.co/collections/Qwen/qwen3-67dd247413f0e2e4f653967f
github: https://github.com/QwenLM/Qwen3
Demo: https://huggingface.co/spaces/Qwen/Qwen3-Demo
Qwen Chat: https://chat.qwenlm.ai









