
 Asistente de guiones▸
 Apps AI
 Noticias AI
LiveCC: modelo de lenguaje de video en tiempo real co-desarrollada por ByteDance y la Universidad Nacional de Singapur
小编 ·

LiveCC: modelo de lenguaje de video en tiempo real co-desarrollada por ByteDance y la Universidad Nacional de Singapur
¿Qué es LiveCC?
LiveCC es un modelo de lenguaje de gran tamaño para vídeos desarrollado en colaboración entre ByteDance y la Universidad Nacional de Singapur, capaz de comentar el contenido de vídeo en tiempo real. Se entrena con transcripciones de reconocimiento automático del habla (ASR), lo que reduce costes y aumenta la eficiencia. Los investigadores también desarrollaron un nuevo método de entrenamiento en streaming y un pipeline de producción de datos, creando dos conjuntos de datos: Live-CC-5M y Live-WhisperX-526K. Incluso sin un ajuste fino supervisado de alta calidad, el modelo LiveCC-7B-Base destaca en el respuesta a preguntas sobre vídeo y en la narración en tiempo real. Tras ser evaluado con el benchmark LiveSports-3K, el modelo final LiveCC-7B-Instruct supera en calidad de narración en tiempo real a modelos avanzados de 72B, y también logra resultados de primer nivel en benchmarks de respuesta a preguntas sobre vídeo como VideoMME y OVOBench.
Características principales de LiveCC
Método de entrenamiento del modelo
Enfoque de entrenamiento innovador: propone un nuevo método de entrenamiento en streaming de vídeo y ASR que entrelaza estrechamente las palabras del ASR y los fotogramas de vídeo según sus marcas temporales, alineado con la naturaleza streaming del ASR, lo que permite al modelo aprender alineación temporal y modelado fino entre visión y lenguaje.
Producción de datos y construcción de conjuntos de datos: introduce un pipeline de producción de datos que procesa vídeos de YouTube y sus subtítulos (CC, equivalentes al ASR), creando el conjunto de datos Live-CC-5M para preentrenamiento y el conjunto de datos Live-WhisperX-526K para el ajuste fino supervisado (SFT) de alta calidad.
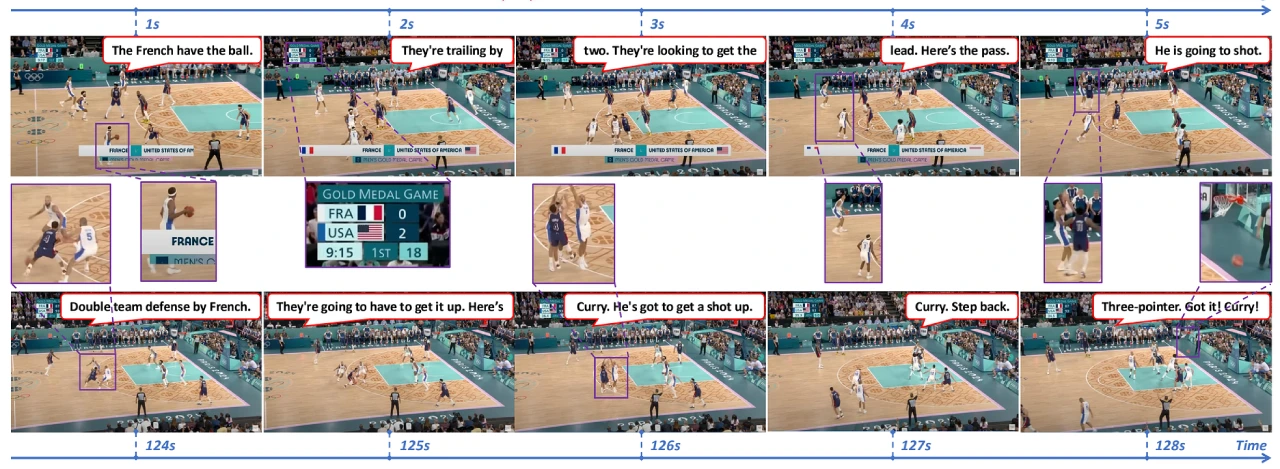
Rendimiento del modelo
Modelo LiveCC-7B-Base: incluso sin SFT, este modelo muestra un rendimiento competitivo en tareas generales de respuesta a preguntas sobre vídeo y además posee la nueva capacidad de narrar vídeos en tiempo real.
Modelo LiveCC-7B-Instruct: evaluado mediante el benchmark LiveSports-3K diseñado cuidadosamente (que utiliza un LLM como juez para medir la narración en formato libre), este modelo supera en calidad de narración en modo tiempo real a modelos avanzados de 72B (como Qwen2.5-VL-72B-Instruct y LLaVA-Video-72B). En benchmarks populares de respuesta a preguntas sobre vídeo (como VideoMME y OVOBench), alcanza resultados de state-of-the-art en la escala de 7B/8B, lo que demuestra la amplia versatilidad del método.
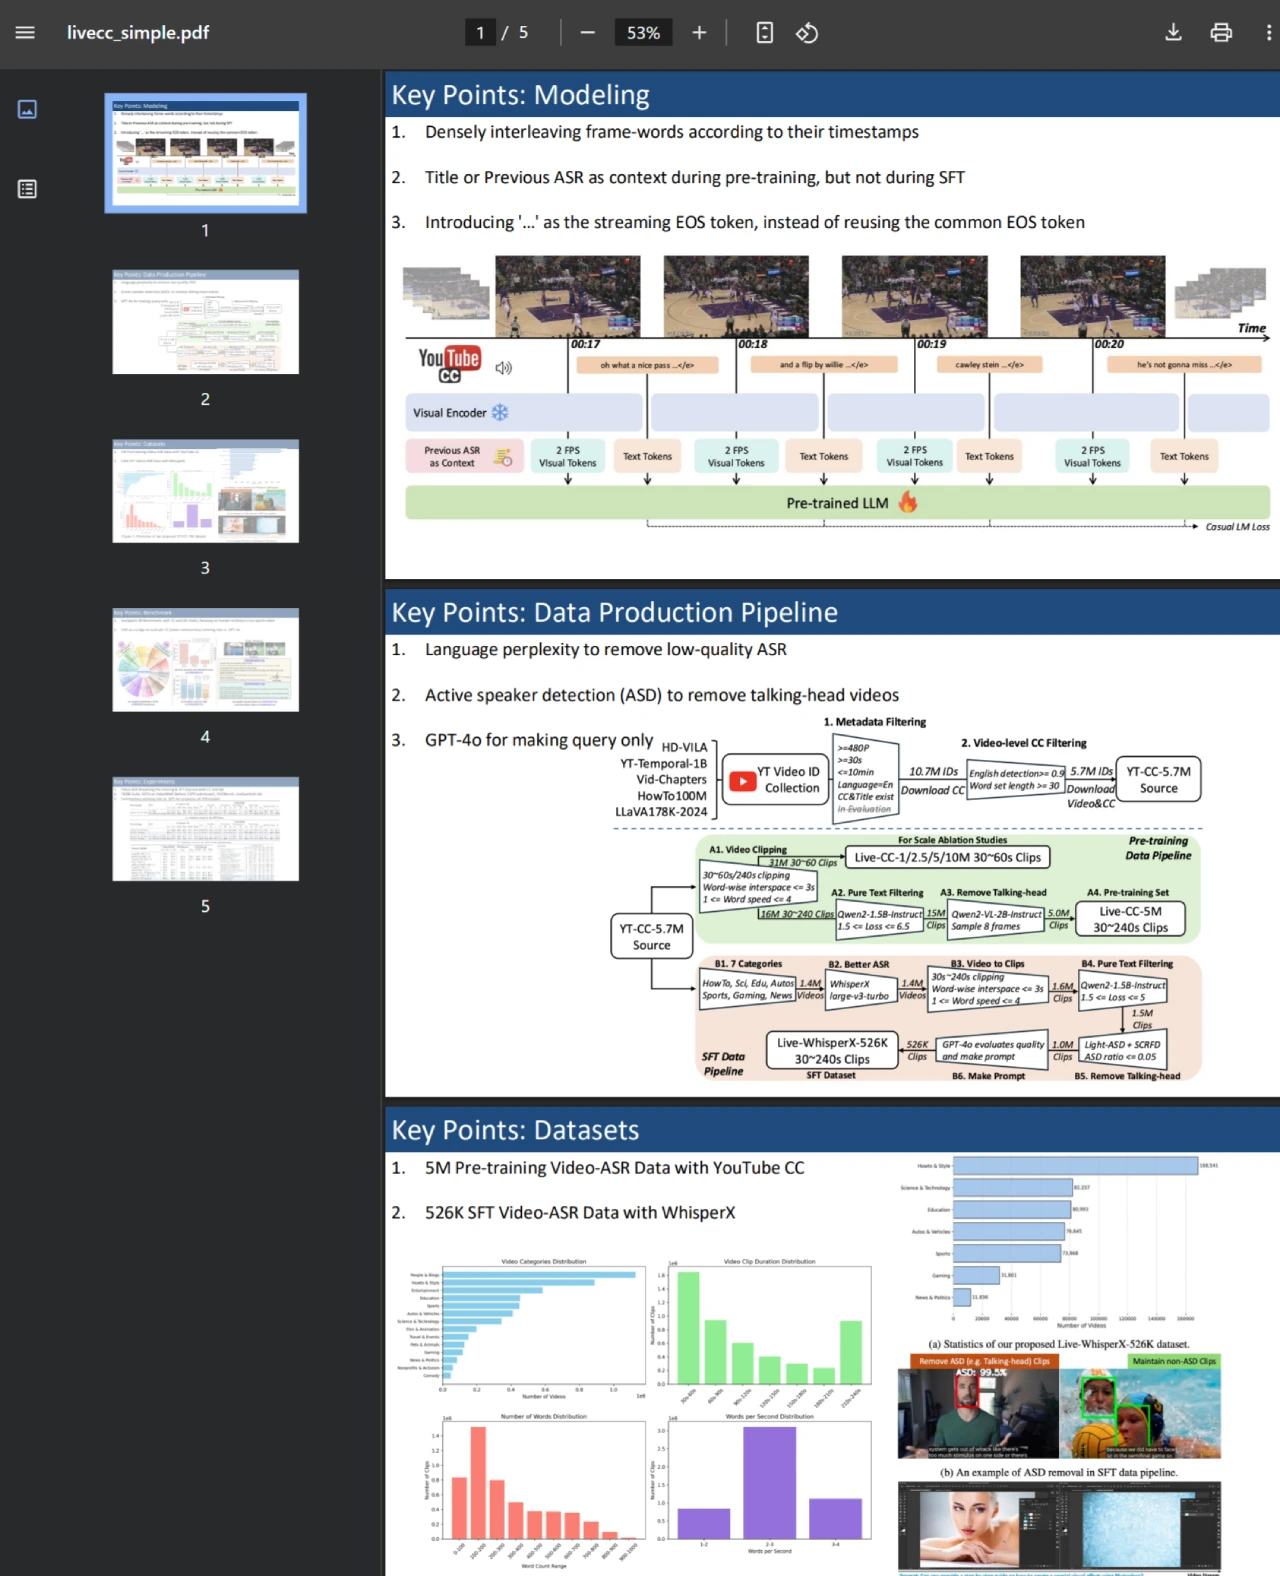
Aplicaciones de LiveCC
LiveCC puede aplicarse ampliamente en áreas como la interpretación en tiempo real de contenidos de vídeo, los comentarios en vivo de eventos deportivos y la explicación interactiva de vídeos educativos.
Preguntas frecuentes
Pregunta: ¿En qué se diferencia LiveCC de otros modelos de lenguaje de gran tamaño para vídeo en la obtención de datos de entrenamiento?
Respuesta:LiveCC utiliza transcripciones económicas de reconocimiento automático del habla (ASR) para el entrenamiento a gran escala, mientras que otros modelos suelen depender de anotaciones humanas costosas o de APIs de modelos propietarios (como GPT-4o). Esta diferencia otorga a LiveCC una ventaja en coste y escala de los datos de entrenamiento.
Pregunta: ¿Qué función tienen respectivamente los conjuntos de datos Live-CC-5M y Live-WhisperX-526K?
Respuesta:El conjunto de datos Live-CC-5M se utiliza para el preentrenamiento del modelo, ayudándolo a aprender características y conocimientos generales de visión y lenguaje; el conjunto de datos Live-WhisperX-526K se utiliza para el ajuste fino supervisado (SFT) de alta calidad, lo que permite al modelo rendir mejor en tareas específicas y mejorar su rendimiento.
Pregunta: ¿Qué significado tiene que el modelo LiveCC-7B-Instruct supere a modelos de 72B en narración en tiempo real?
Respuesta:Indica que el método de entrenamiento y la arquitectura del modelo de LiveCC son efectivos, capaces de lograr una funcionalidad de narración en tiempo real más eficiente con un número menor de parámetros. Esto ofrece una solución con mejor relación coste-beneficio para la推广 de modelos de lenguaje de gran tamaño para vídeo en escenarios de aplicación en tiempo real (como la narración en vivo de eventos deportivos).
Enlaces relacionados
Repositorio de GitHub:https://github.com/showlab/livecc
Página de Releases:https://github.com/showlab/livecc/releases
Página del proyecto:https://showlab.github.io/livecc/
Enlace al paper:https://arxiv.org/abs/2504.06885
Demostración en línea:https://huggingface.co/spaces/chenjoya/LiveCC









