
 Asistente de guiones▸
 Apps AI
 Noticias AI
No-OCR: una herramienta de procesamiento de documentos que no necesita extracción de texto por OCR
小编 ·

No-OCR: una herramienta de procesamiento de documentos que no necesita extracción de texto por OCR
¿Qué es No-OCR?
No-OCR es una herramienta de procesamiento de documentos que no requiere extracción de texto mediante OCR complejo; simplemente sube archivos PDF para buscar o consultar rápidamente contenido en múltiples colecciones de documentos, sin depender de la tecnología OCR tradicional, lo que mejora la eficiencia del análisis de documentos. Permite crear y gestionar colecciones de PDF/documentos, organizadas por "casos", al mismo tiempo que construye automáticamente conjuntos de datos al estilo Hugging Face. Además, No-OCR ofrece búsqueda basada en vectores de páginas PDF e imágenes relacionadas (utilizando LanceDB), y responde preguntas visuales sobre imágenes y gráficos mediante Qwen2-VL. Admite búsquedas híbridas de consultas textuales y visuales, se puede desplegar rápidamente con Docker, con una configuración sencilla, e incluye instrucciones detalladas de instalación y desarrollo.
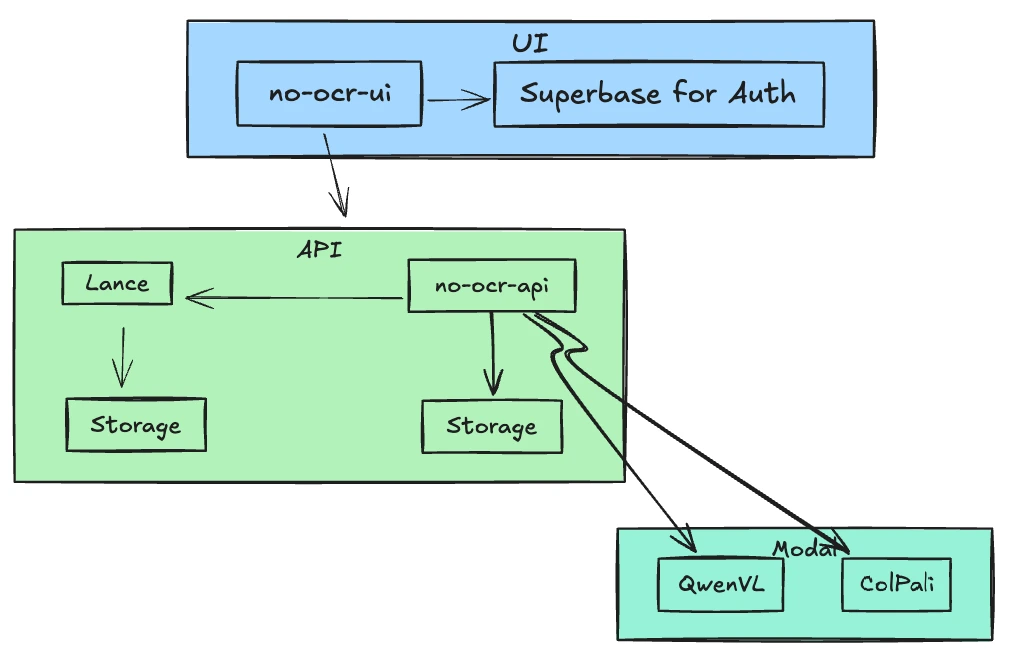
Características de No-OCR
Sin OCR: no depende en absoluto de la tecnología OCR, siendo adecuado para archivos PDF con contenido visual enriquecido.
Fácil de usar: tras subir el archivo PDF, se puede buscar directamente, admitiendo contenido visual complejo (como tablas, gráficos, diseños, etc.).
Modelos de código abierto: basado en LLM (modelos de lenguaje de gran tamaño) de código abierto para la recuperación e interpretación de contenido.
Desplegable: compatible con despliegue mediante Docker, válido para cualquier entorno empresarial.
Casos de uso de No-OCR
Caso aplicable: si los documentos contienen contenido visual enriquecido (como tablas, gráficos, diseños, etc.), No-OCR es una excelente opción.
Caso no aplicable: si los documentos son principalmente texto plano, la búsqueda tradicional BM25 puede ser más adecuada.
Contenido mixto: si los documentos contienen una mezcla de texto y contenido visual, puede ser necesario adaptar la solución según las necesidades.
Diseño de la arquitectura de No-OCR
Arquitectura sencilla: no depende de bases de datos ni colas de mensajes; todas las operaciones de persistencia se basan en el sistema de archivos.
Servicios principales:
Modal: utilizado para el despliegue de LLMs.
Qdrant: utilizado para búsqueda multivectorial.
Supabase: utilizado para la autenticación y autorización de usuarios.
Crear caso: el usuario sube archivos PDF y especifica el nombre del caso; el sistema convierte los PDF en un conjunto de datos y los sube a Qdrant.
Flujo de búsqueda: el usuario introduce una consulta de búsqueda; el sistema identifica las páginas relevantes mediante el LLM e interpreta el contenido.
Modelos LLM de No-OCR
Familia ColPali: utilizada para recuperación de imágenes, convirtiendo las imágenes en un formato buscable.
Familia Qwen2-VL: utilizada para razonamiento sobre contenido visual; en particular, el modelo Qwen2-VL-7B-Instruct es uno de los modelos visuales de código abierto más avanzados actualmente.
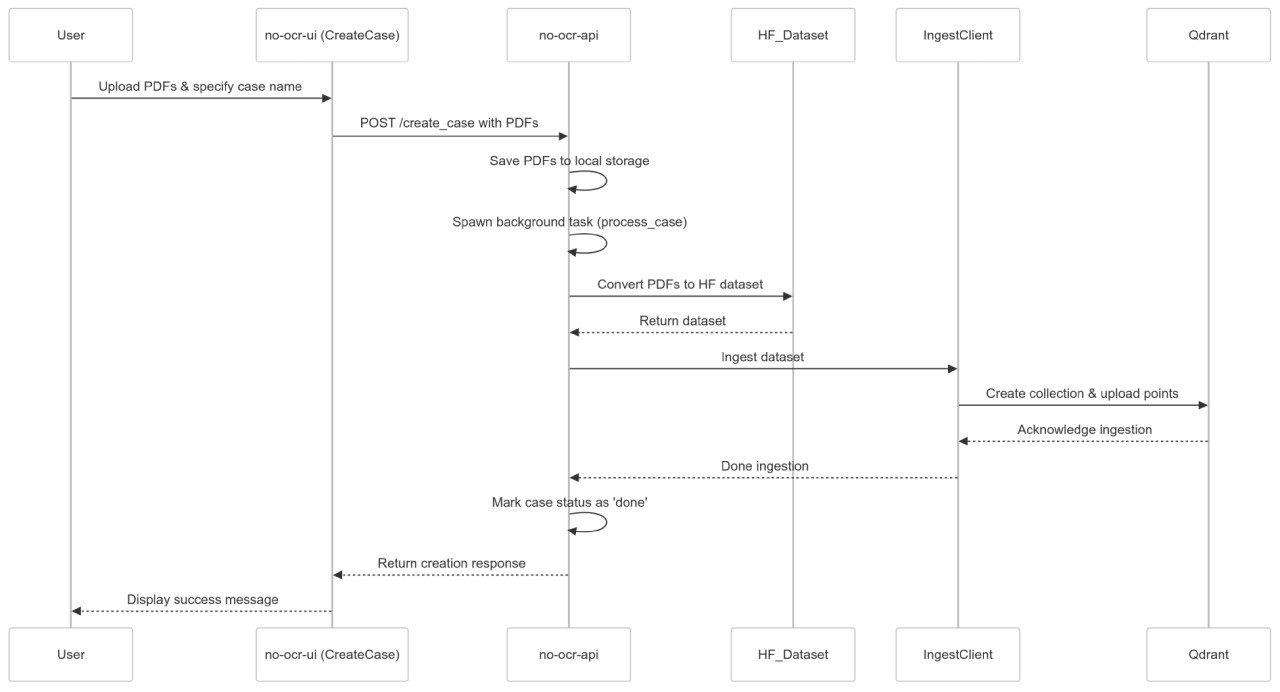
Flujo de creación de casos
Cómo funciona
La plataforma No-OCR adopta un enfoque RAG simplificado: el usuario solo tiene que subir archivos PDF para crear un caso, y el sistema los procesa y los hace buscables. El usuario puede hacer cualquier pregunta, incluidas preguntas sobre elementos visuales, y la plataforma proporcionará respuestas utilizando los mejores modelos de razonamiento de código abierto.
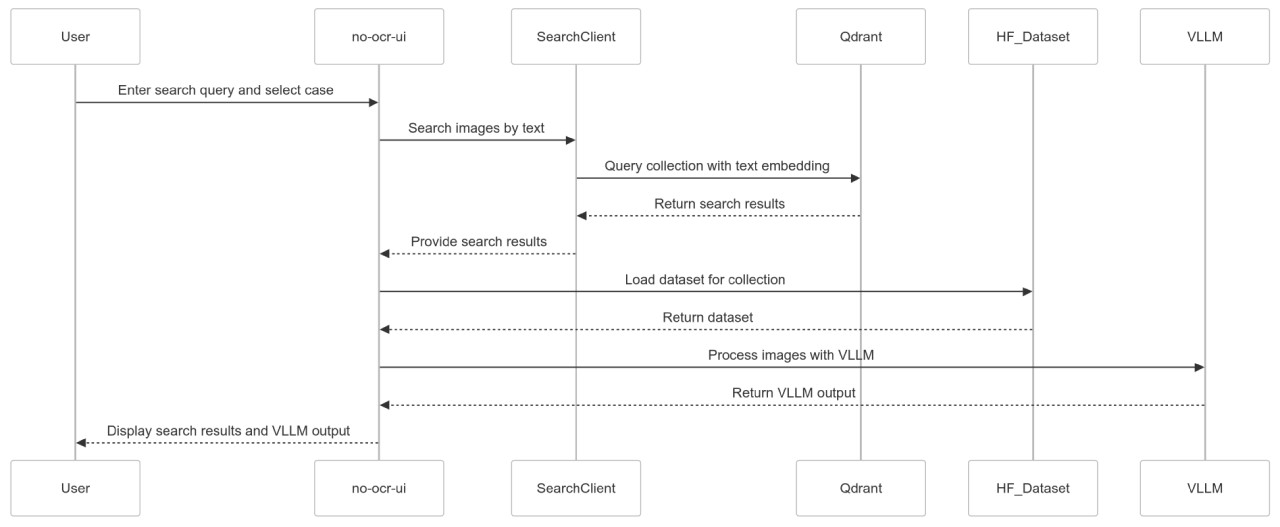
Flujo de búsqueda
Pasos para usar No-OCR
Sube y procesa PDFs complejos: el usuario sube archivos PDF desafiantes para crear un nuevo caso; el sistema genera embeddings sin necesidad de procesamiento OCR complejo.
Hazlo buscable: una vez procesado, el usuario puede ejecutar consultas basadas en texto y encontrar rápidamente páginas y citas relevantes, sin importar la complejidad del diseño del PDF.
Realiza preguntas visuales: la plataforma localizará rápidamente las páginas relevantes y luego refinará las respuestas mediante un modelo visual de código abierto especializado, ofreciendo información contextual incluso si el PDF contiene tablas o gráficos.
TLDR:https://no-ocr.com/about
Github:https://github.com/kyryl-opens-ml/no-ocr









