
 Asistente de guiones▸
 Apps AI
 Noticias AI
HawkinsDB: un sistema de memoria para IA inspirado en el cerebro humano
小编 ·

HawkinsDB: un sistema de memoria para IA inspirado en el cerebro humano
¿Qué es HawkinsDB?
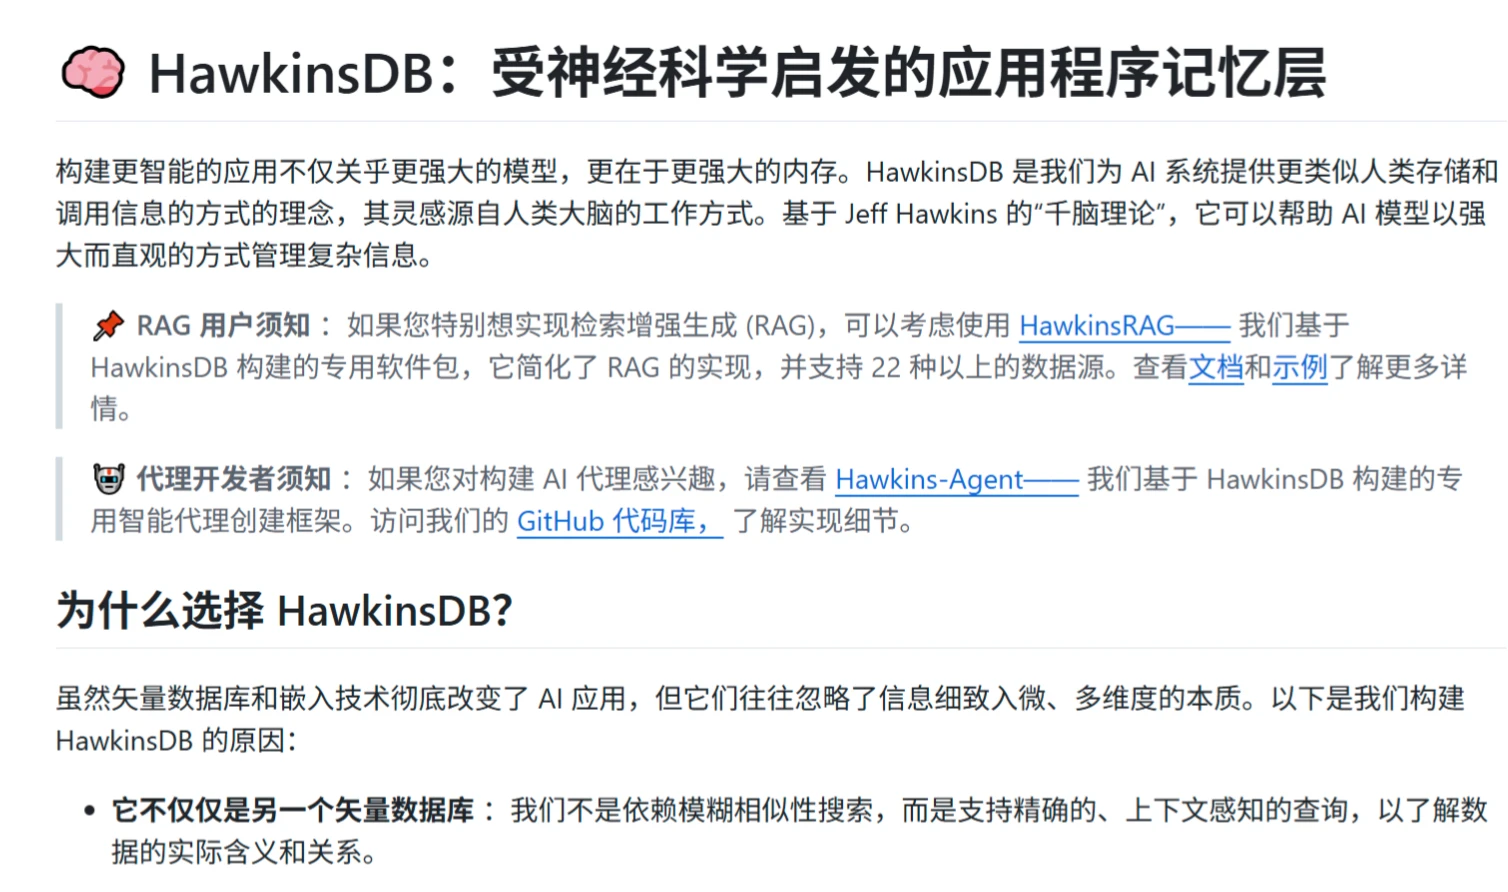
HawkinsDB es un sistema de memoria de ia basado en el funcionamiento del cerebro humano, que permite a la IA almacenar y recuperar información como lo haría una persona. Se basa en la "Teoría de las mil mentes" de Jeff Hawkins, imitando la forma en que opera el cerebro humano y ayudando a los modelos de IA a gestionar información compleja de una manera más potente e intuitiva. Así como nuestro cerebro no solo recuerda hechos aislados, sino que también los conecta para formar complejas redes de conocimiento, HawkinsDB también busca que la IA memorice y comprenda la información como lo hace el cerebro humano.
A diferencia de las bases de datos vectoriales tradicionales, HawkinsDB no depende de búsquedas difusas por similitud, sino que admite consultas exactas y con conciencia del contexto, capaces de comprender el significado real y las relaciones de los datos. Unifica la memoria semántica, la memoria episódica y la memoria procedimental en un único marco, permitiendo que la IA no solo almacene información, sino que también registre las relaciones entre los datos como un grafo de conocimiento, comprendiendo y aplicando así diferentes tipos de conocimiento. Este diseño hace que HawkinsDB sea especialmente adecuado para escenarios que requieren una gestión compleja del conocimiento y procesamiento multimodal, como sistemas RAG y el desarrollo de agentes de IA.
Funciones principales de HawkinsDB
Consultas exactas: a diferencia de las bases de datos vectoriales tradicionales, HawkinsDB no depende de búsquedas difusas por similitud, sino que admite consultas exactas y con conciencia del contexto, capaces de comprender el significado real y las relaciones de los datos.
Sistema de memoria unificado: unifica la memoria semántica, la memoria episódica y la memoria procedimental en un único marco, permitiendo que la IA acceda simultáneamente a diferentes tipos de conocimiento.
Procesamiento de información multidimensional: a diferencia de las bases de datos vectoriales tradicionales, HawkinsDB no depende de búsquedas difusas por similitud, sino que comprende el significado real y las relaciones de los datos mediante consultas exactas con conciencia del contexto.
Arquitectura inspirada en el cerebro: toma como referencia conceptos del cerebro como los "marcos de referencia" (Reference Frames) y las "columnas corticales" (Cortical Columns), lo que hace que el sistema sea más robusto y flexible.
Transparencia: a diferencia de los métodos de incrustación de caja negra, el enfoque estructurado de HawkinsDB permite a los usuarios ver claramente cómo se conecta la información y por qué se toman ciertas decisiones.
¿Cómo funciona HawkinsDB?
Soporta múltiples opciones de almacenamiento: incluye SQLite (adecuado para entornos de producción) y JSON (adecuado para desarrollo de prototipos).
Integración inteligente: admite la integración con herramientas de grafos de conocimiento como ConceptNet, enriqueciendo automáticamente el conocimiento y descubriendo relaciones.
Apto para el desarrollo de RAG y agentes de IA: para los usuarios que necesitan implementar la generación aumentada por recuperación (RAG), HawkinsDB ofrece el paquete especializado HawkinsRAG, que admite más de 22 fuentes de datos. Además, HawkinsDB también soporta marcos para la construcción de agentes inteligentes.
Instalación de HawkinsDB
HawkinsDB es compatible con Python 3.10 o versiones superiores y requiere una clave de API de OpenAI para las operaciones con LLM. A continuación se muestra el método de instalación:
pip install hawkinsdb
También puede instalar todas las funciones:
pip install hawkinsdb[all]
HawkinsDB se encuentra actualmente en fase de desarrollo y entre las mejoras计划adas se encuentran el procesamiento multimodal, la optimización del rendimiento, la ampliación de la compatibilidad con proveedores de LLM, la mejora de las capacidades de consulta y la mejora de la documentación.
Github:https://github.com/harishsg993010/HawkinsDB









