
 Asistente de guiones▸
 Apps AI
 Noticias AI
Video-R1: el primer modelo R1 para vídeo del mundo, desarrollado conjuntamente por la CUHK y la Universidad de Tsinghua
小编 ·

Video-R1: el primer modelo R1 para vídeo del mundo, desarrollado conjuntamente por la CUHK y la Universidad de Tsinghua
¿Qué es Video-R1?
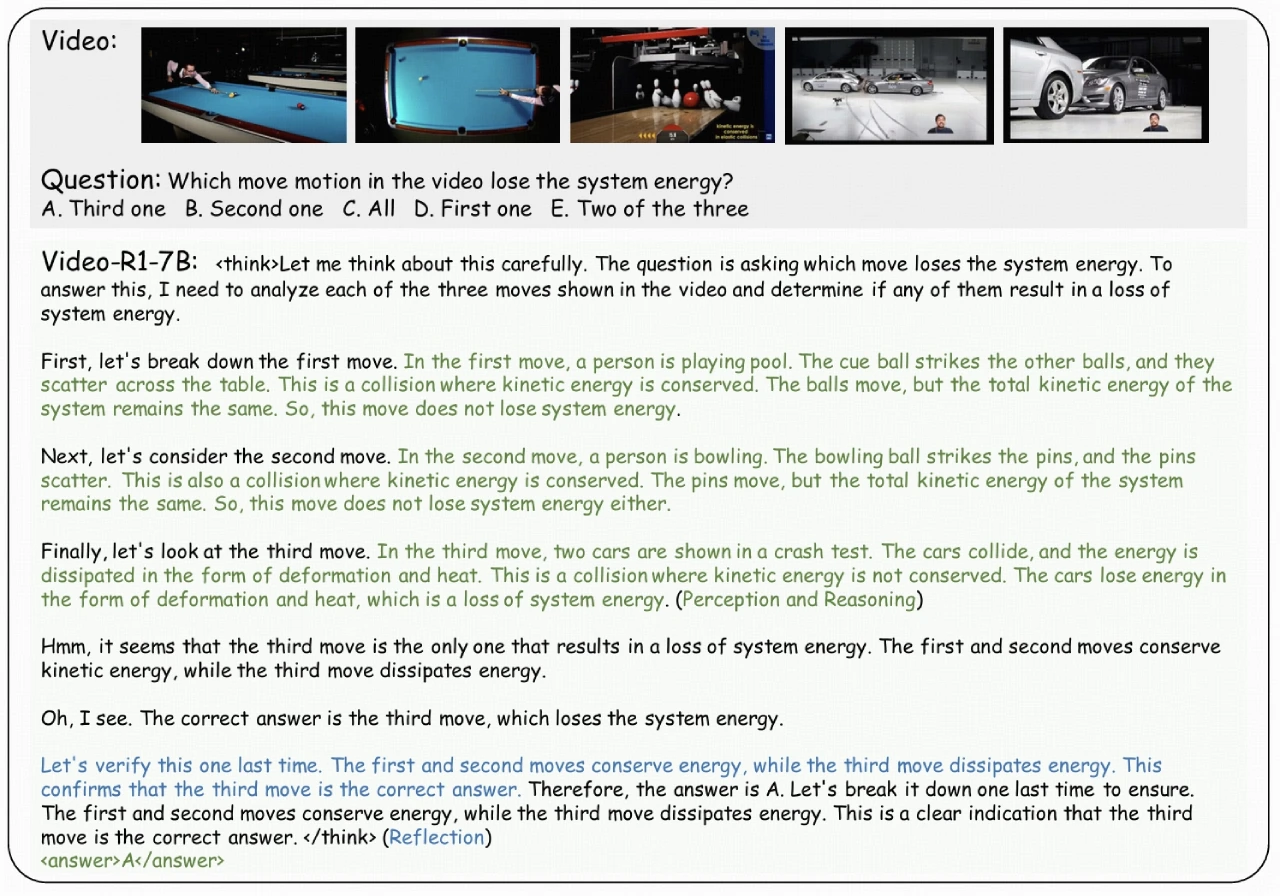
Video-R1 es el primer modelo R1 para vídeo del mundo, desarrollado conjuntamente por la Universidad China de Hong Kong y la Universidad de Tsinghua. Mejora la capacidad de razonamiento sobre vídeo de los modelos de lenguaje multimodales de gran tamaño (MLLMs) mediante aprendizaje por refuerzo.
Funciones de Video-R1
Razonamiento con percepción temporal: Video-R1 introduce el algoritmo T-GRPO, que compara fotogramas de vídeo desordenados con fotogramas en orden, animando al modelo a utilizar la información temporal para razonar y comprender mejor las relaciones secuenciales en el vídeo.
Entrenamiento con datos mixtos: Para abordar la escasez de datos de razonamiento sobre vídeo de alta calidad, Video-R1 emplea un conjunto de datos mixto de imágenes y vídeo, que incluye Video-R1-COT-165k (para el arranque en frío SFT) y Video-R1-260k (para el entrenamiento RL), lo que permite al modelo transferir la capacidad de razonamiento de imágenes estáticas al razonamiento dinámico en vídeo.
Múltiples tipos de salida: Video-R1 admite varios tipos de respuesta, incluyendo opción múltiple, valores numéricos, OCR, formato libre y regresión.
Comportamiento de razonamiento autorreflexivo: El modelo lleva a cabo una autorreflexión durante el proceso de razonamiento, ajustando la dirección de su razonamiento para alcanzar conclusiones más precisas. Este «momento eureka» indica que el modelo está realizando activamente un bucle de retroalimentación interna.
Tecnología de Video-R1
Algoritmo con percepción temporal T-GRPO: Este algoritmo mejora la comprensión del modelo sobre las series temporales, permitiéndole reflexionar en profundidad sobre las relaciones causales entre eventos. En comparación con el algoritmo GRPO tradicional, T-GRPO vincula la comprensión temporal mediante un mecanismo de recompensa, de modo que el modelo solo obtiene recompensa cuando la proporción de aciertos en entradas en orden es mayor.
Conjunto de datos mixto de imágenes y vídeo: Los investigadores crearon dos conjuntos de datos de alta calidad: Video-R1-COT-165k (centrado en imágenes) y Video-R1-260k (centrado en vídeo de alta calidad), lo que resuelve el problema de la escasez de datos de razonamiento sobre vídeo. Este enfoque de entrenamiento mixto permite al modelo evolucionar de «describir imágenes» a «reflexionar profundamente sobre vídeo», logrando una auténtica comprensión multimodal.
Estrategia de entrenamiento mediante aprendizaje por refuerzo: Mediante el aprendizaje por refuerzo, el modelo abandona progresivamente los modos de razonamiento subóptimos durante el entrenamiento, formando trayectorias de expresión más eficientes y lógicas.
Aplicaciones de Video-R1
Análisis de contenido de vídeo: Video-R1 puede analizar y comprender de forma eficiente el contenido dinámico de los vídeos, siendo útil para generar automáticamente fragmentos clave, reconocimiento de acciones y generación inteligente de etiquetas.
Búsqueda y recomendación de vídeos: Mediante razonamiento profundo, Video-R1 puede comprender con mayor precisión las necesidades del usuario y ofrecer recomendaciones de contenido de vídeo más afines a sus intereses.
Comprensión visual para conducción autónoma: El modelo es capaz de comprender las relaciones temporales y la lógica causal en los vídeos, lo que ayuda a los sistemas de conducción autónoma a percibir y predecir mejor el entorno vial.
Vigilancia por vídeo y seguridad: Video-R1 puede emplearse en el análisis en tiempo real de vídeos de vigilancia para identificar rápidamente comportamientos o eventos anómalos, mejorando la seguridad pública.
Educación y formación: En el ámbito educativo, Video-R1 puede integrarse en sistemas de tutoría inteligente para analizar el contenido de vídeos didácticos y ofrecer a los estudiantes recomendaciones de aprendizaje personalizadas.
Hogar inteligente: El modelo puede integrarse en sistemas de hogar inteligente para lograr una percepción del entorno y un control automatizado más inteligentes mediante el análisis de vídeo.
Repositorio en GitHub:https://github.com/tulerfeng/Video-R1
Paper:https://arxiv.org/abs/2503.21776









