
 Asistente de guiones▸
 Apps AI
 Noticias AI
PDF Document Layout Analysis: un servicio de análisis de diseño de PDF y OCR de PDF basado en Docker
小编 ·

PDF Document Layout Analysis: un servicio de análisis de diseño de PDF y OCR de PDF basado en Docker
¿Qué es PDF Document Layout Analysis?
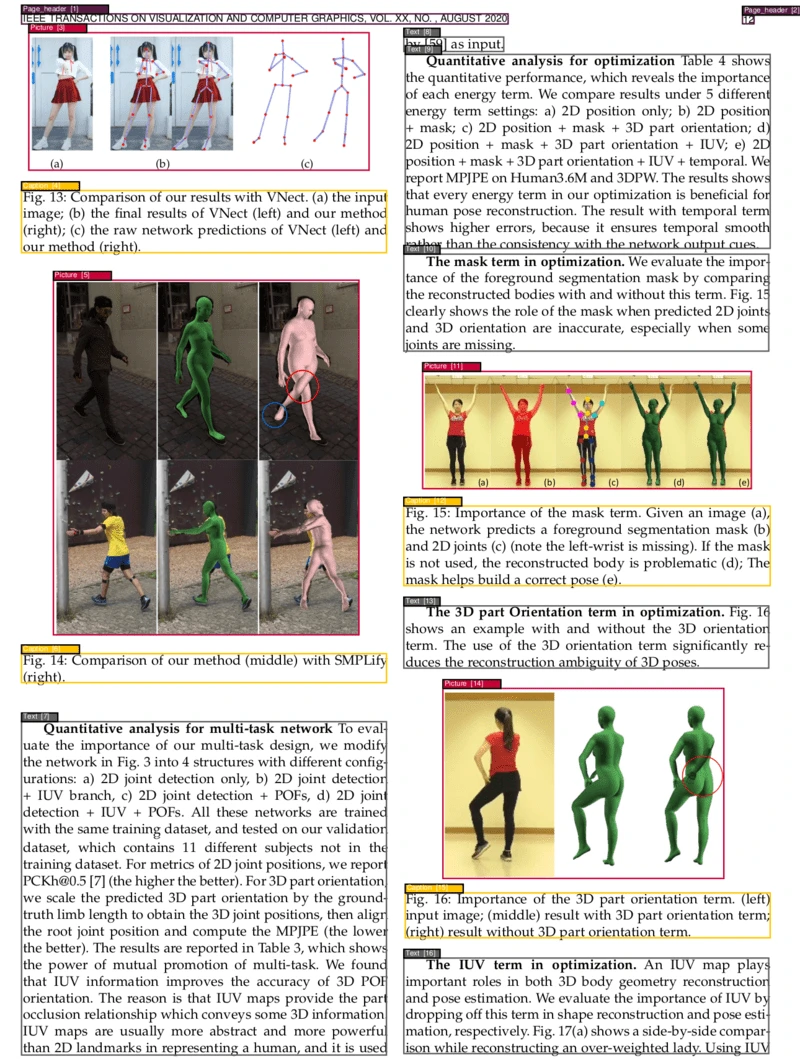
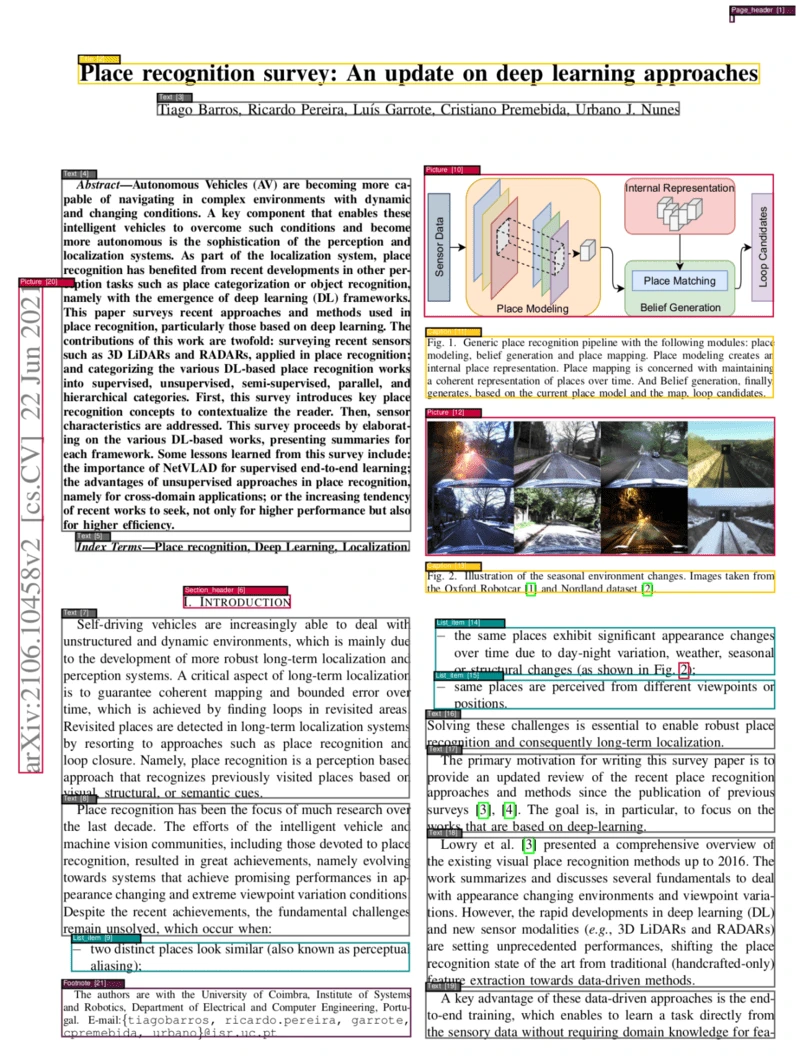
PDF Document Layout Analysis es un servicio basado en Docker para analizar el diseño de documentos PDF. Es capaz de segmentar y clasificar las diferentes partes de las páginas PDF, identificando de forma automática y precisa elementos como texto, títulos, imágenes, tablas, etc., y determinando el orden correcto de estos elementos.
Características de PDF Document Layout Analysis
1. Funcionalidad OCR
Soporte multilingüe: admite OCR en varios idiomas; los usuarios pueden procesar documentos PDF en distintos idiomas especificando el parámetro de idioma.
Extracción de texto: convierte las imágenes o el texto no buscable del PDF en un formato de texto buscable, lo que facilita su posterior procesamiento y análisis.
2. Segmentación y clasificación de páginas
Reconocimiento de múltiples elementos: capaz de identificar y clasificar distintos elementos en las páginas PDF:
Texto: contenido de texto normal.
Títulos: títulos y subtítulos del documento.
Imágenes: imágenes presentes en la página.
Tablas: contenido de tablas.
Fórmulas: fórmulas matemáticas, con salida en formato LaTeX.
Elementos de lista: listas ordenadas o desordenadas.
Encabezados y pies de página: encabezados y pies de página del documento.
Notas al pie: notas al pie del documento.
Otros: como pies de imagen, títulos de tablas, etc.
Clasificación precisa: utiliza modelos visuales avanzados (como Vision Grid Transformer - VGT) y modelos de aprendizaje automático (como LightGBM) para garantizar resultados de clasificación de alta precisión.
3. Ordenación de elementos
Orden lógico: determina automáticamente el orden lógico de los elementos según el diseño de la página y el tipo de elemento, garantizando que el resultado de salida siga el orden de lectura del documento.
Reglas de ordenación personalizadas: combina el orden de lectura inicial de Poppler con el tipo de párrafo para ordenar los elementos, asegurando la lógica y la coherencia del resultado.
4. Salida visualizada
PDF visualizado: permite visualizar los resultados del análisis en un nuevo archivo PDF, para que el usuario pueda ver de forma intuitiva los resultados de la segmentación y clasificación.
Función de anotación: en la salida visualizada, los distintos tipos de elementos se marcan con colores o estilos diferentes para facilitar su distinción.
5. Extracción de tablas y fórmulas
Extracción de tablas: admite la extracción de tablas en varios formatos, como Markdown, LaTeX o HTML, para su posterior procesamiento y análisis.
Extracción de fórmulas: las fórmulas se exportan en formato LaTeX, lo que facilita su uso en documentos académicos y de ingeniería.
Casos de uso de PDF Document Layout Analysis
Investigación académica: extraer y organizar texto, figuras, tablas y referencias de artículos de investigación para facilitar la revisión bibliográfica y el análisis de datos.
Análisis de documentos legales: analizar y estructurar documentos legales, contratos y expedientes de casos.
Informes comerciales: extracción automatizada de datos financieros, gráficos e indicadores clave para generar insights y resúmenes.
Archivos y digitalización: digitalizar y clasificar documentos históricos, manuscritos y archivos en un formato fácil de buscar.
Publicación y medios: organizar y dar formato al contenido de manuscritos, artículos e informes, garantizando coherencia y calidad.
Inicio rápido
Ejecutar el servicio: admite modo GPU y modo sin GPU.
Funcionalidad OCR: admite varios idiomas, invocable mediante el comando curl.
Obtener resultados de segmentación: enviar archivos PDF mediante el comando curl y obtener los resultados segmentados.
Detener el servicio: se proporcionan comandos para detener el servidor.
Dependencias y requisitos
Docker Desktop: se requiere Docker Desktop 4.25.0 o superior.
Soporte GPU: si se necesita aceleración por GPU, se debe instalar el software de soporte de GPU correspondiente.
Requisitos de hardware: se necesitan al menos 2 GB de memoria; si se utiliza GPU, se requieren 5 GB de memoria GPU.
Modelos
Modelo visual (Vision Grid Transformer - VGT): modelo por defecto, entrenado por el equipo de investigación de Alibaba; admite un análisis de diseño más complejo, pero requiere más recursos.
Modelo LightGBM: modelo no visual que utiliza la información XML extraída por Poppler para clasificar y segmentar; es más rápido y consume menos recursos.
Datos
Datos de entrenamiento: se utiliza el conjunto de datos DocLayNet, que contiene 11 categorías, como títulos, notas al pie, fórmulas, elementos de lista, etc.
Modo de uso
Comandos básicos: enviar archivos PDF mediante el comando curl y elegir entre el modelo visual o el modelo no visual.
Salida visualizada: admite la visualización de los resultados del análisis en un archivo PDF.
Extracción de tablas y fórmulas: admite la extracción de tablas y fórmulas en diferentes formatos (como LaTeX, Markdown).
Orden de salida
Reglas de ordenación: la ordenación se basa en el orden de lectura inicial de Poppler y en el tipo de párrafo, garantizando un orden lógico en la salida.
Rendimiento y velocidad
Rendimiento: el modelo VGT ofrece un rendimiento excelente en el conjunto de datos PubLayNet, con una precisión media superior al 96%.
Velocidad: el modelo no visual procesa cada página en 0,42 segundos en CPU; el modelo visual tarda 1,75 segundos en GPU y 13,5 segundos en CPU.
Enlaces relacionados
GitHub:https://github.com/huridocs/pdf-document-layout-analysis
DockerHub:https://hub.docker.com/r/huridocs/pdf-document-layout-analysis









