
 Asistente de guiones▸
 Apps AI
 Noticias AI
UNO: un modelo de generación de imágenes condicional con múltiples sujetos desarrollado por ByteDance
小编 ·

UNO: un modelo de generación de imágenes condicional con múltiples sujetos desarrollado por ByteDance
¿Qué es UNO?
UNO es un modelo de generación de imágenes condicionado por múltiples sujetos desarrollado por el equipo de investigación de ByteDance, que genera datos de emparejamiento de múltiples sujetos con alta consistencia mediante la capacidad de generación contextual de un transformador de difusión.
Características principales de UNO
Generación condicionada por múltiples imágenes: admite la generación de imágenes impulsada por un solo sujeto o por múltiples sujetos, capaz de generar nuevas imágenes a partir de una o varias imágenes de referencia.
Alineación progresiva cross-modal: mejora la consistencia de la generación mediante la alineación gradual de diferentes modalidades (como texto e imagen), dividida en dos fases. En la primera fase se ajustan los datos generados con contexto de un solo sujeto para refinar un modelo preentrenado de texto a imagen, convirtiéndolo en un modelo de sujeto a imagen; la segunda fase continúa el entrenamiento con los pares de datos de múltiples sujetos generados.
Embeddings posicionales rotatorios universales: admite la generación de imágenes en múltiples resoluciones y relaciones de aspecto, y puede mitigar eficazmente el problema de confusión de atributos que surge al ampliar el control de sujetos visuales.
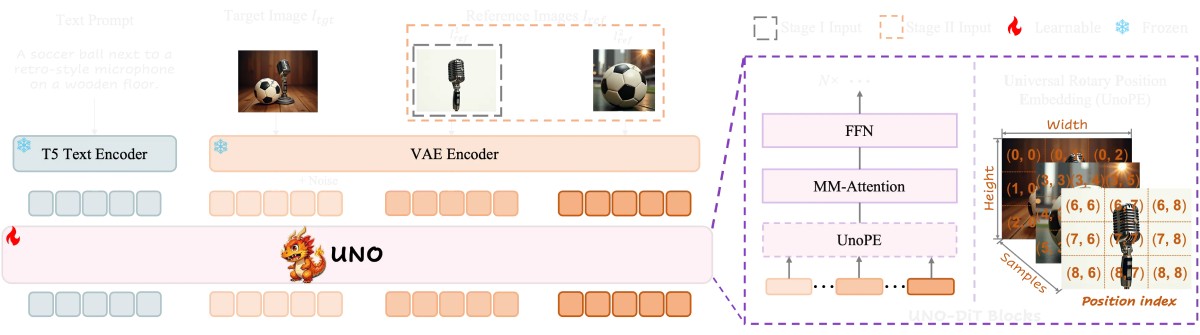
Mecanismos clave de UNO:
Alineación progresiva cross-modal (Progressive Cross-Modal Alignment): dividida en dos fases. En la primera fase se ajustan los datos generados con contexto de un solo sujeto para refinar un modelo preentrenado de texto a imagen, convirtiéndolo en un modelo de sujeto a imagen; la segunda fase continúa el entrenamiento con los pares de datos de múltiples sujetos generados.
Embeddings posicionales rotatorios universales (Universal Rotary Position Embedding, UnoPE): mitiga eficazmente el problema de confusión de atributos que aparece al ampliar el control de sujetos visuales, y admite la generación de imágenes en múltiples resoluciones y relaciones de aspecto.
¿Cómo funciona UNO?
UNO aprovecha la capacidad de generación contextual del transformador de difusión para generar datos de emparejamiento de múltiples sujetos con alta consistencia. Se entrena de forma iterativa a partir de un modelo de texto a imagen y, gracias a sus singulares mecanismos de alineación progresiva cross-modal y de embeddings posicionales rotatorios universales, consigue mantener tanto una alta consistencia como un control preciso en la generación impulsada por uno o por múltiples sujetos.
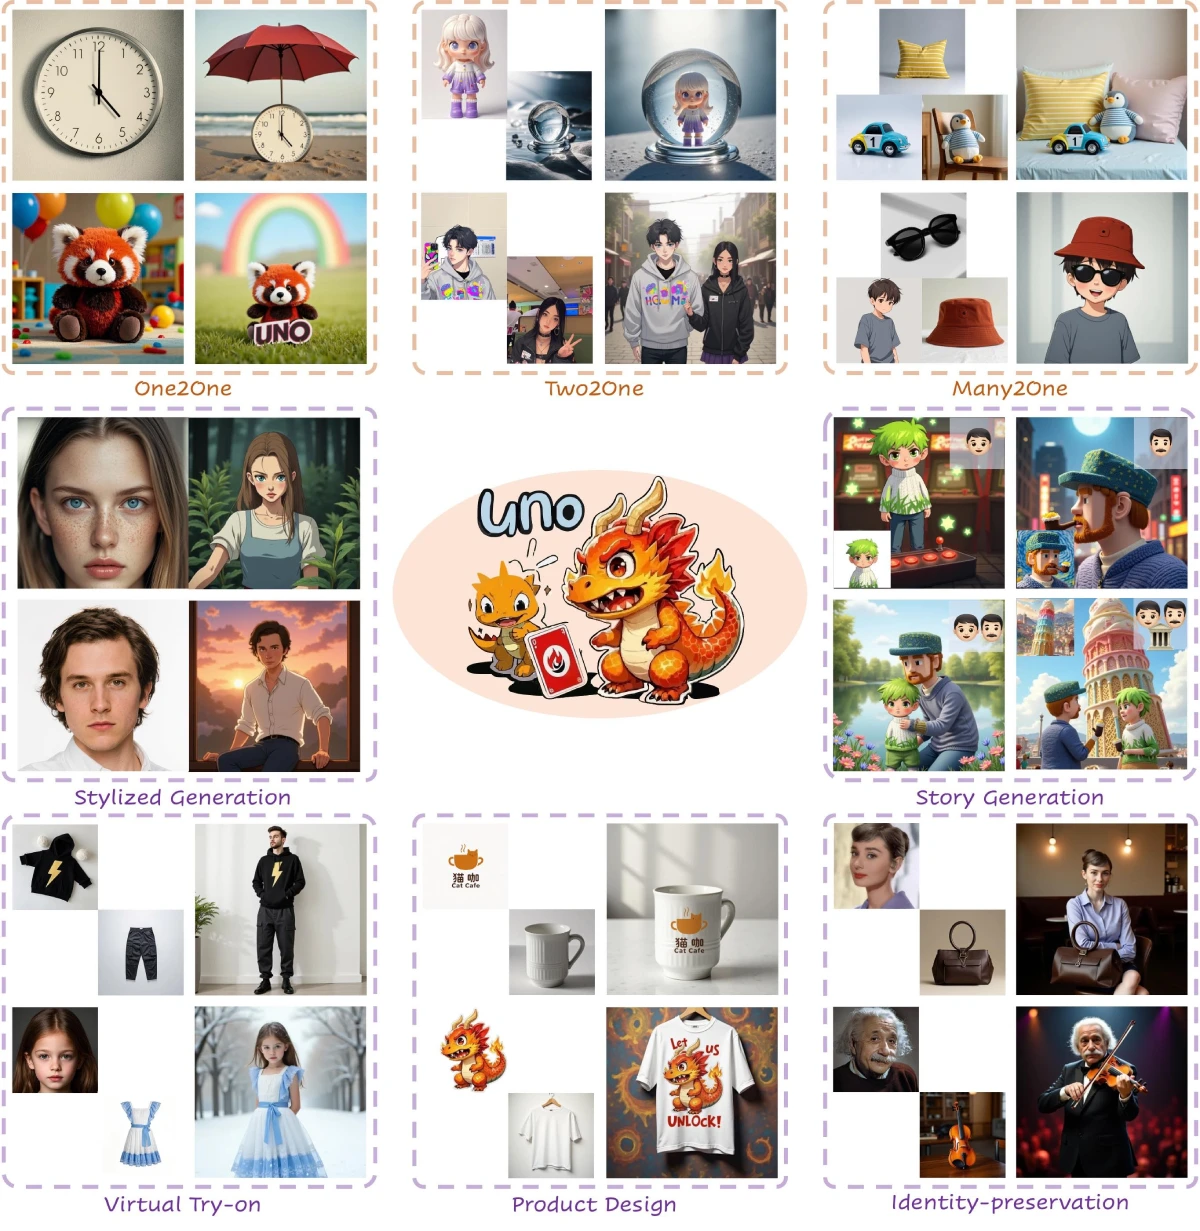
Escenarios de aplicación de UNO
Generación de un solo sujeto: genera imágenes a partir de una imagen de referencia; por ejemplo, a partir de la imagen de un reloj se puede generar una imagen de ese reloj en la playa.
Generación de múltiples sujetos: genera imágenes a partir de varias imágenes de referencia; por ejemplo, usando como referencia la imagen de una muñeca y la imagen de una bola de cristal, se puede generar la imagen de la muñeca dentro de la bola de cristal.
Generación contextual: genera imágenes de alta consistencia mediante indicaciones contextuales; por ejemplo, dada la indicación "un reloj en la playa con una sombrilla roja", combinada con la imagen de referencia del reloj, se genera una imagen que se ajusta a la descripción.
Cómo usar UNO
Configuración del entorno:
Crea un entorno virtual e instala las dependencias:
python -m venv uno_env
source uno_env/bin/activate
pip install -r requirements.txt
Descarga los pesos del modelo: descarga automática (el código los descarga automáticamente al ejecutar el script de inferencia), o descárgalos manualmente usando huggingface-cli en el directorio especificado.
Ejemplo de inferencia: ejecuta el siguiente comando para generar una imagen:
python inference.py --prompt "A clock on the beach is under a red sun umbrella" --image_paths "assets/clock.png" --width 704 --height 704
Entrenamiento: ejecuta el script de entrenamiento:
accelerate launch train.py
Enlaces relacionados
Página del proyecto:https://bytedance.github.io/UNO
Repositorio de GitHub:https://github.com/bytedance/UNO
Paper en arXiv:https://arxiv.org/abs/2504.02160
Demo:https://huggingface.co/spaces/bytedance-research/UNO-FLUX









