
 Asistente de guiones▸
 Apps AI
 Noticias AI
Crawl4AI: un rastreador y scraper web de código abierto amigable con la IA
小编 ·

Crawl4AI: un rastreador y scraper web de código abierto amigable con la IA
¿Qué es Crawl4ai?
Crawl4AI es un rastreador y scraper web de código abierto y amigable con la IA, un proyecto popular en GitHub, diseñado para LLM, agentes de IA y pipelines de datos. Admite la extracción rápida y flexible de datos web, genera datos en formato Markdown adecuados para LLM, y cuenta con extracción de datos estructurados, integración con navegadores, manejo de contenido dinámico, entre otras funciones.
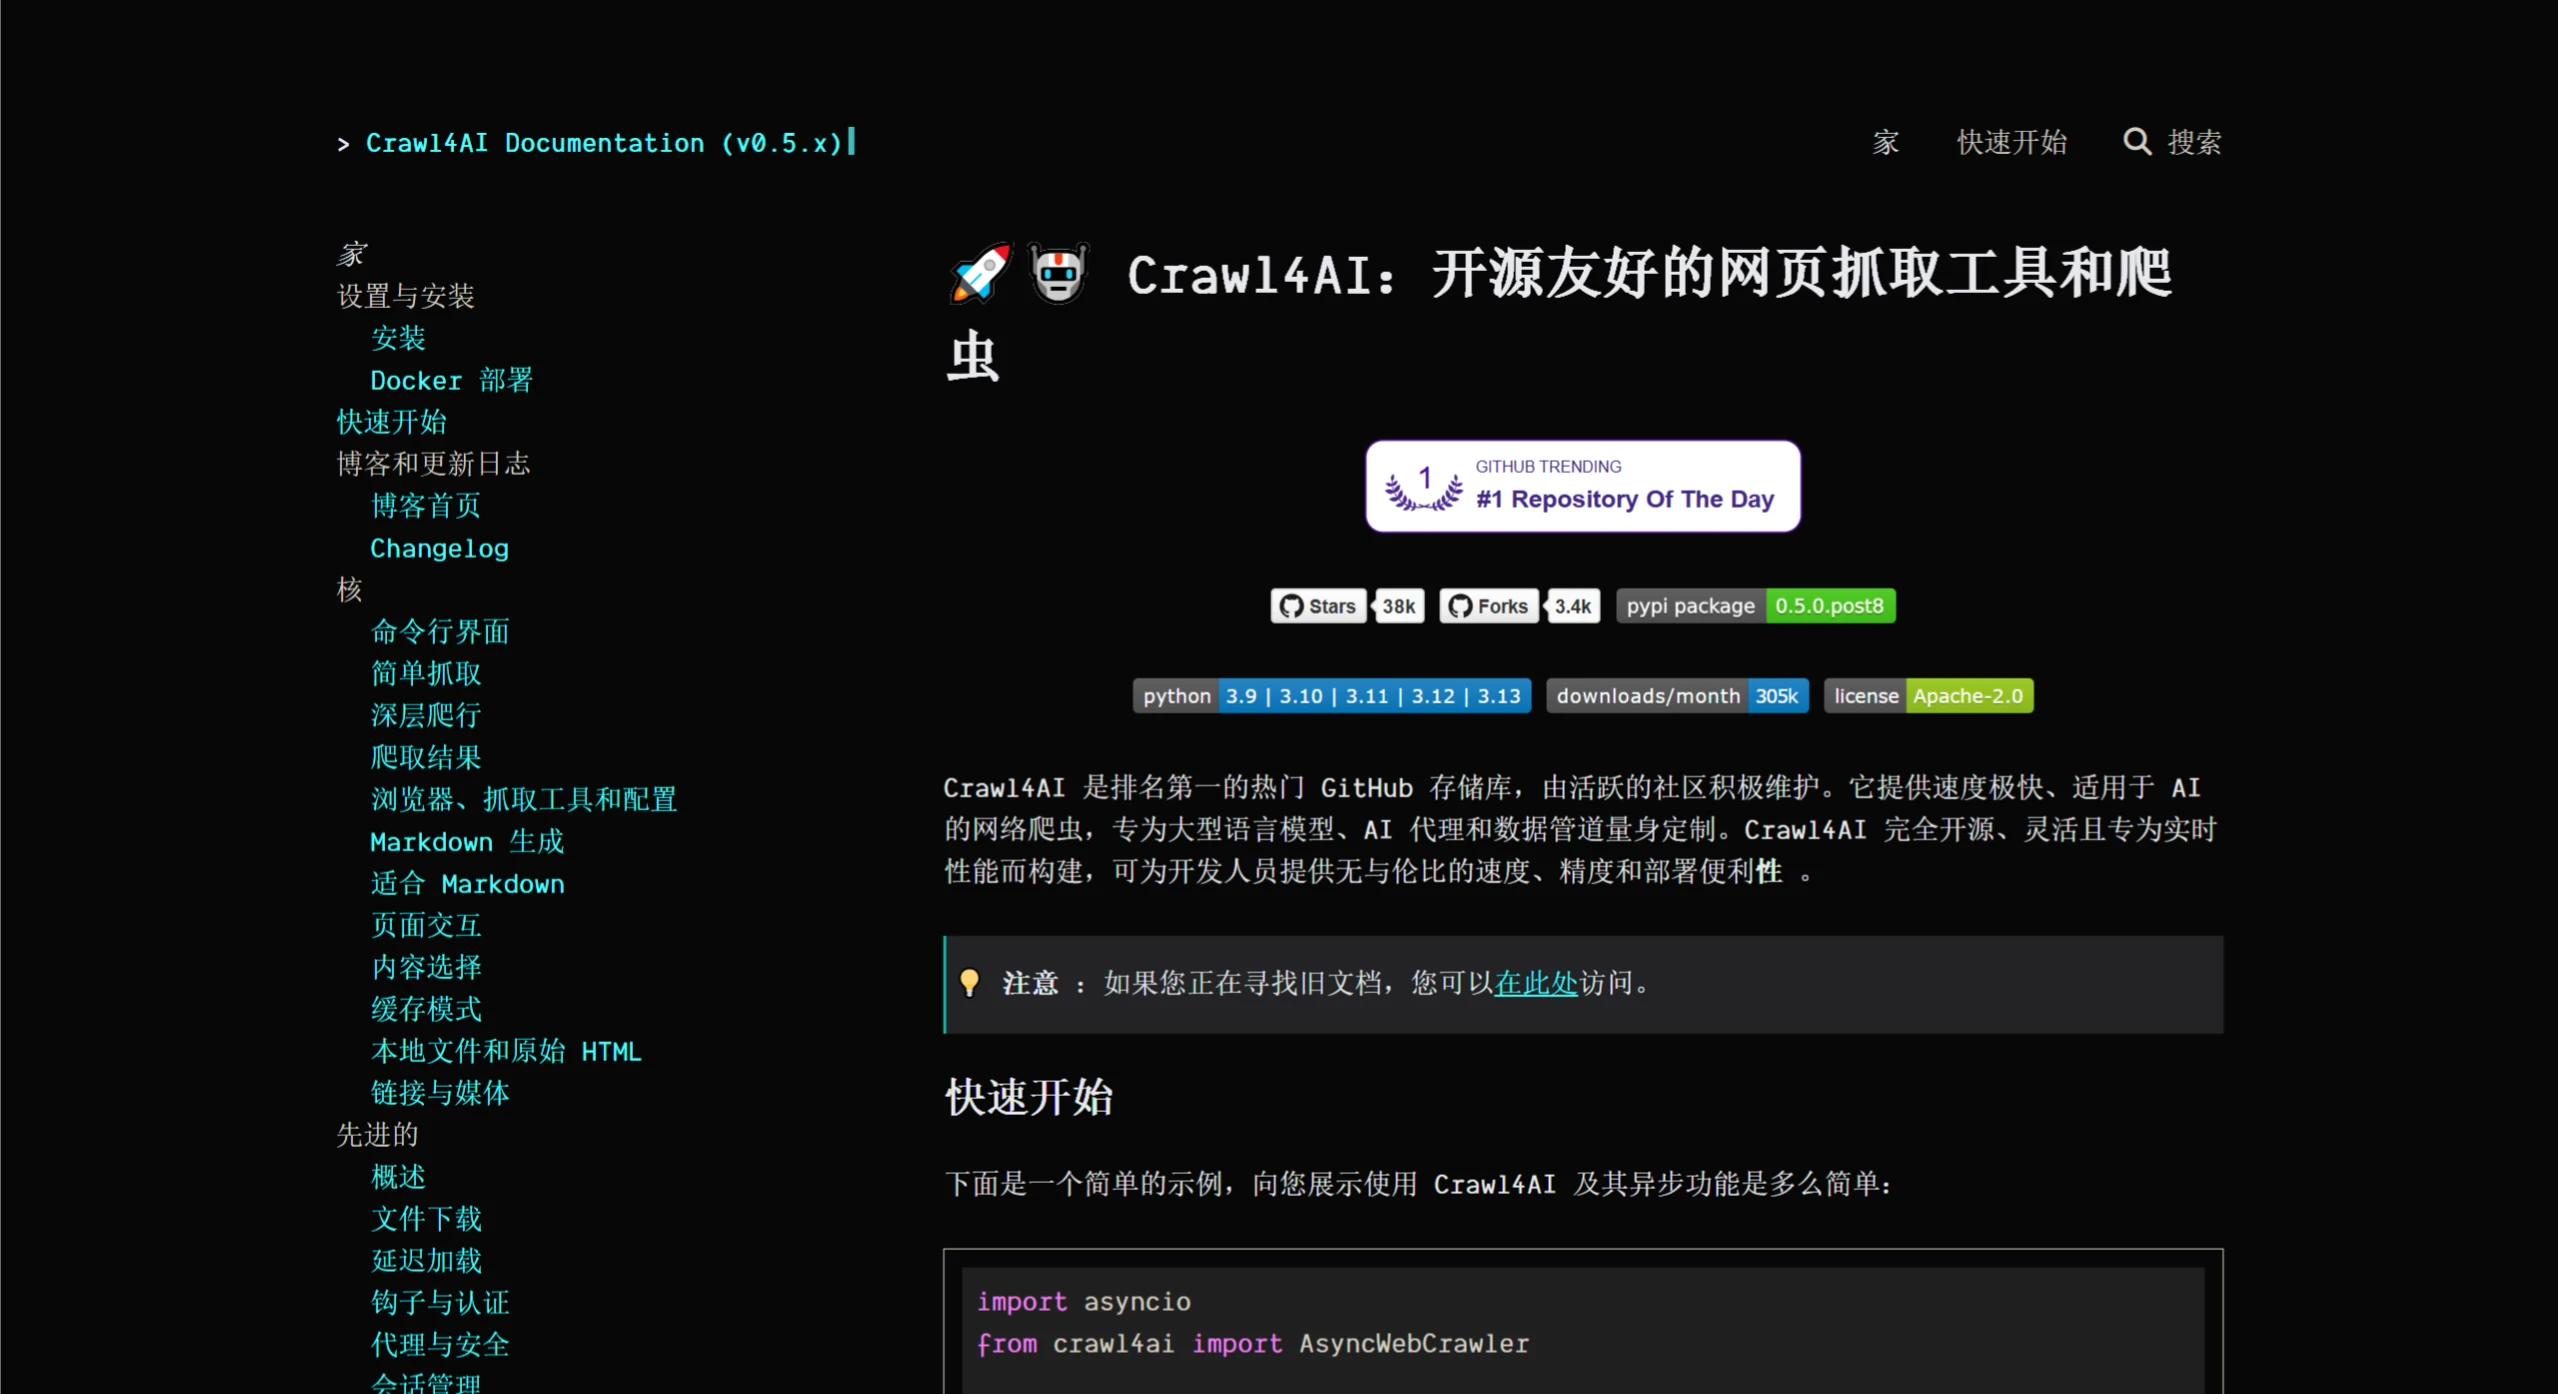
Funciones de Crawl4AI
Generación de Markdown
Markdown limpio: genera texto Markdown con una estructura clara y formato preciso.
Markdown adaptado: filtra el ruido y el contenido irrelevante mediante algoritmos heurísticos para generar Markdown adecuado para el procesamiento de IA.
Citas y referencias: convierte los enlaces de la página en una lista numerada de referencias, con citas claras.
Estrategias personalizadas: los usuarios pueden crear sus propias estrategias de generación de Markdown para satisfacer necesidades específicas.
Algoritmo BM25: filtra el contenido basándose en el algoritmo BM25 para extraer la información esencial y eliminar contenido irrelevante.
Extracción de datos estructurados
Extracción impulsada por LLM: admite todos los LLM (tanto de código abierto como propietarios) para la extracción de datos estructurados.
Estrategias de fragmentación: implementa fragmentación basada en temas, expresiones regulares y nivel de oración.
Similitud del coseno: encuentra bloques de contenido relevantes según la consulta del usuario, permitiendo la extracción semántica.
Extracción basada en CSS: utiliza XPath y selectores CSS para una extracción de datos rápida y basada en patrones.
Definición de esquemas: define esquemas personalizados para extraer datos JSON estructurados a partir de patrones repetitivos.
Integración con navegadores
Navegador autohospedado: utiliza el navegador del propio usuario para evitar ser detectado como rastreador.
Control remoto del navegador: conéctate a un navegador remoto mediante el protocolo de herramientas de desarrollador de Chrome para realizar extracción de datos a gran escala.
Perfiles de navegador: crea y gestiona perfiles persistentes para guardar estados de autenticación, cookies y configuraciones.
Gestión de sesiones: conserva y reutiliza el estado del navegador para admitir el rastreo en varios pasos.
Soporte de proxies: conexión fluida a proxies con autenticación, garantizando un acceso seguro.
Control total del navegador: modifica cabeceras de solicitud, cookies, agentes de usuario, etc., para personalizar la configuración de rastreo.
Soporte multimnavegador: compatible con Chromium, Firefox y WebKit.
Ajuste dinámico del viewport: ajusta automáticamente el viewport del navegador para que coincida con el contenido de la página, asegurando la renderización completa y la captura de todos los elementos.
Rastreo y scraping
Soporte de medios: extrae imágenes, audio, vídeos y formatos de imágenes responsivas (como srcset y picture).
Rastreo dinámico: ejecuta JavaScript y espera contenido asíncrono o síncrono para extraer contenido dinámico.
Capturas de pantalla: captura capturas de pantalla de la página durante el proceso de rastreo, para depuración o análisis.
Rastreo de datos sin procesar: procesa directamente HTML sin procesar (raw:) o archivos locales (file://).
Extracción completa de enlaces: extrae enlaces internos, externos y contenido de iframes incrustados.
Ganchos personalizados: define ganchos en cada paso para personalizar el comportamiento del rastreo.
Caché: almacena datos en caché para mejorar la velocidad y evitar raspados repetidos.
Extracción de metadatos: extrae metadatos estructurados de las páginas web.
Extracción de contenido de iframes: extrae sin problemas el contenido de iframes incrustados.
Manejo de carga diferida: espera a que las imágenes se carguen por completo, asegurando que no se omita contenido debido a la carga diferida.
Escaneo de página completa: simula el desplazamiento para cargar y capturar todo el contenido dinámico, ideal para páginas con scroll infinito.
Otras funciones
Modo stealth: imita el comportamiento de usuarios reales para evitar ser detectado como rastreador.
Extracción de contenido basada en etiquetas: refina el contenido rastreado según etiquetas, títulos o metadatos personalizados.
Análisis de enlaces: extrae y analiza todos los enlaces para una exploración detallada de los datos.
Manejo de errores: gestión de errores robusta, garantizando una ejecución fluida.
CORS y servicio estático: admite caché basada en el sistema de archivos y solicitudes de origen cruzado.
Documentación clara: guías simplificadas para principiantes y usuarios avanzados.
Ventajas de Crawl4AI
Diseñado para LLM: genera Markdown inteligente y conciso, adecuado para aplicaciones RAG y de fine-tuning.
Rendimiento ultrarrápido: rendimiento en tiempo real y rentable, hasta 6 veces más rápido que los métodos tradicionales.
Control flexible del navegador: ofrece gestión de sesiones, soporte de proxies y ganchos personalizados, garantizando un acceso a datos sin interrupciones.
Inteligencia heurística: utiliza algoritmos avanzados para extraer contenido de forma eficiente, reduciendo la dependencia de modelos costosos.
Código abierto y desplegable: completamente de código abierto, sin necesidad de claves de API, compatible con Docker e integraciones en la nube.
Casos de uso de Crawl4AI
IA y aprendizaje automático: proporciona datos de entrenamiento de alta calidad para LLM, apoyando el procesamiento del lenguaje natural y la construcción de grafos de conocimiento.
Pipelines de datos: construye pipelines de datos eficientes para extraer y procesar datos web en tiempo real.
Extracción de contenido: extrae texto, imágenes, vídeos y otros contenidos multimedia de páginas web para sistemas de gestión de contenidos.
Investigación académica: ayuda a los investigadores a extraer artículos y datos de investigación de la web, apoyando el trabajo de investigación académica.
Inteligencia empresarial: extrae datos de mercado, información de productos y reseñas de usuarios para respaldar la toma de decisiones comerciales.
Medios de comunicación: rastrea rápidamente contenido de noticias, apoyando la agregación de noticias y el análisis de contenidos.
Tutorial de instalación y uso de Crawl4AI
Instalación
Instalación básica:
pip install crawl4ai
crawl4ai-setup  # Configurar el navegador
Instalación de la versión preliminar:
pip install crawl4ai --pre
Instalación para desarrollo:
git clone https://github.com/unclecode/crawl4ai.git
cd crawl4ai
pip install -e .  # Instalación básica
pip install -e ".[all]"  # Instalar todas las funciones opcionales
Dirección de Github:https://github.com/unclecode/crawl4ai
Documentación de Crawl4AI:https://docs.crawl4ai.com/
Discord:https://discord.com/invite/jP8KfhDhyN









