
 Asistente de guiones▸
 Apps AI
 Noticias AI
Versatile-OCR-Program: OCR que extrae datos estructurados de materiales complejos como exámenes
小编 ·

Versatile-OCR-Program: OCR que extrae datos estructurados de materiales complejos como exámenes
¿Qué es Versatile-OCR-Program?
Versatile-OCR-Program es un sistema OCR optimizado específicamente para el entrenamiento de aprendizaje automático, capaz de extraer datos estructurados de materiales educativos complejos (como exámenes) y generar salida en formato JSON o Markdown. Admite japonés, coreano e inglés, y es extensible a otros idiomas, fórmulas matemáticas, tablas, gráficos y diagramas. Además, puede realizar anotaciones semánticas para generar descripciones en lenguaje natural.
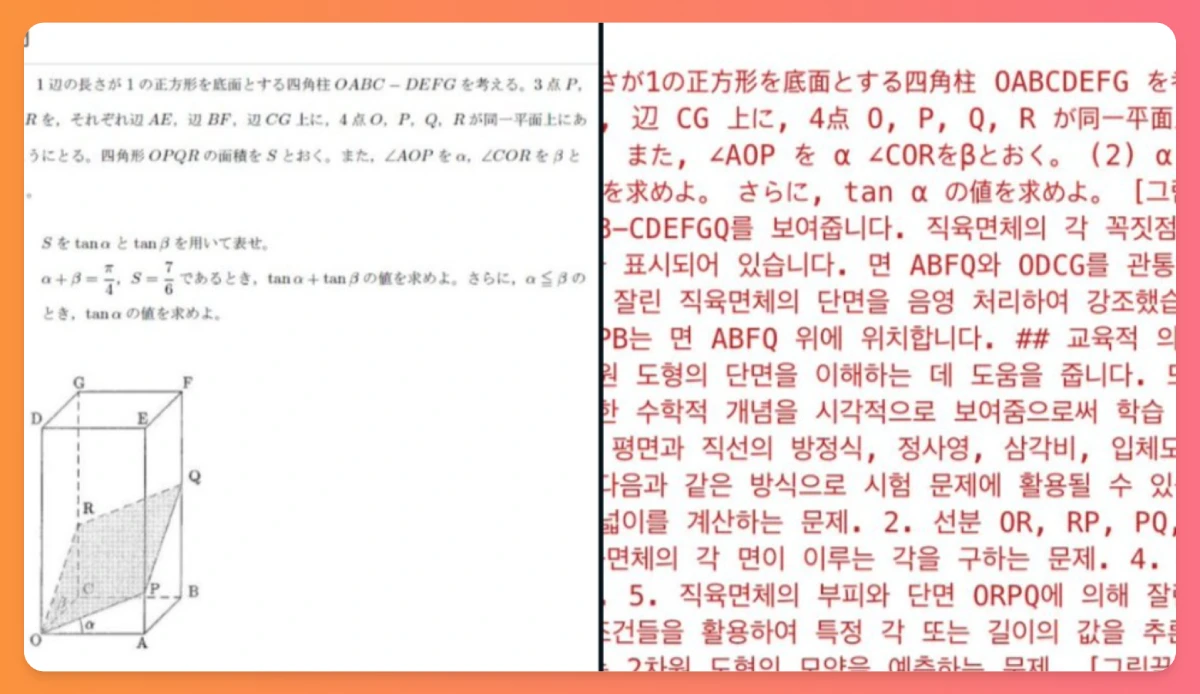
Características principales de Versatile-OCR-Program
Optimizado para el entrenamiento de aprendizaje automático: los elementos extraídos (como gráficos, tablas y figuras) se anotan semánticamente, incluyendo la generación automática de descripciones en lenguaje natural del contenido visual, para mejorar el entrenamiento de modelos posteriores.
Soporte multilingüe: admite japonés, coreano e inglés, y se puede personalizar fácilmente para otros idiomas.
Salida estructurada: genera salida lista para IA en formato JSON o Markdown, incluyendo descripciones legibles por humanos de expresiones matemáticas, resúmenes de tablas y títulos de figuras.
Alta precisión: alcanza una precisión del 90% - 95% en conjuntos de datos académicos reales como EJU Biología y Matemáticas de la Universidad de Tokio.
Soporte de diseños complejos: capaz de procesar con precisión archivos PDF estilo examen que contienen contenido científico denso, párrafos con muchas fórmulas y elementos visuales enriquecidos.
Implementación técnica: utiliza tecnologías como DocLayout-YOLO, Google Vision API, Gemini Pro Vision, MathPix OCR, OpenAI API, OpenCV, entre otras.
Ejemplos de salida
Proporciona ejemplos de salida reales, incluyendo imágenes de entrada y salida convertida de problemas de matemáticas y biología, así como el contexto semántico y los datos extraídos de la traducción al inglés.
Ejemplo de problema de matemáticas: muestra cómo extraer información de una imagen que contiene figuras geométricas y ángulos, y generar descripciones y preguntas relacionadas.
Ejemplo de problema de biología: muestra cómo extraer información de una imagen que muestra el proceso de mitosis en células de la punta de la raíz de cebolla, y generar descripciones y preguntas relacionadas.
Flujo de uso de Versatile-OCR-Program
Paso 1: Extracción OCR inicial: ejecute el script ocr_stage1.py para extraer elementos sin procesar (texto, tablas, figuras, etc.) del PDF de entrada, realizar la detección de diseño y almacenar los resultados intermedios.
Paso 2: Interpretación semántica y salida final: ejecute el script ocr_stage2.py para procesar los datos intermedios y convertirlos en una salida estructurada y legible por humanos, incluyendo la generación de explicaciones en lenguaje natural, resúmenes y la organización del contenido en un formato listo para IA (JSON/Markdown).
Implementación técnica
Optimización del procesamiento de tablas: utiliza DocLayout-YOLO para detectar áreas de tablas, Google Vision OCR para el procesamiento de tablas (mejor rendimiento con texto japonés) y conserva la estructura de la tabla en formato JSON estructurado.
Procesamiento de imágenes y áreas especiales: utiliza las funciones de análisis de imágenes de Google Vision API para procesar áreas de imágenes, Google Cloud Vision API para generar descripciones de imágenes, y la función de análisis de documentos de Google Cloud Vision API para procesar gráficos/diagramas, almacenando los resultados en formato JSON estructurado.
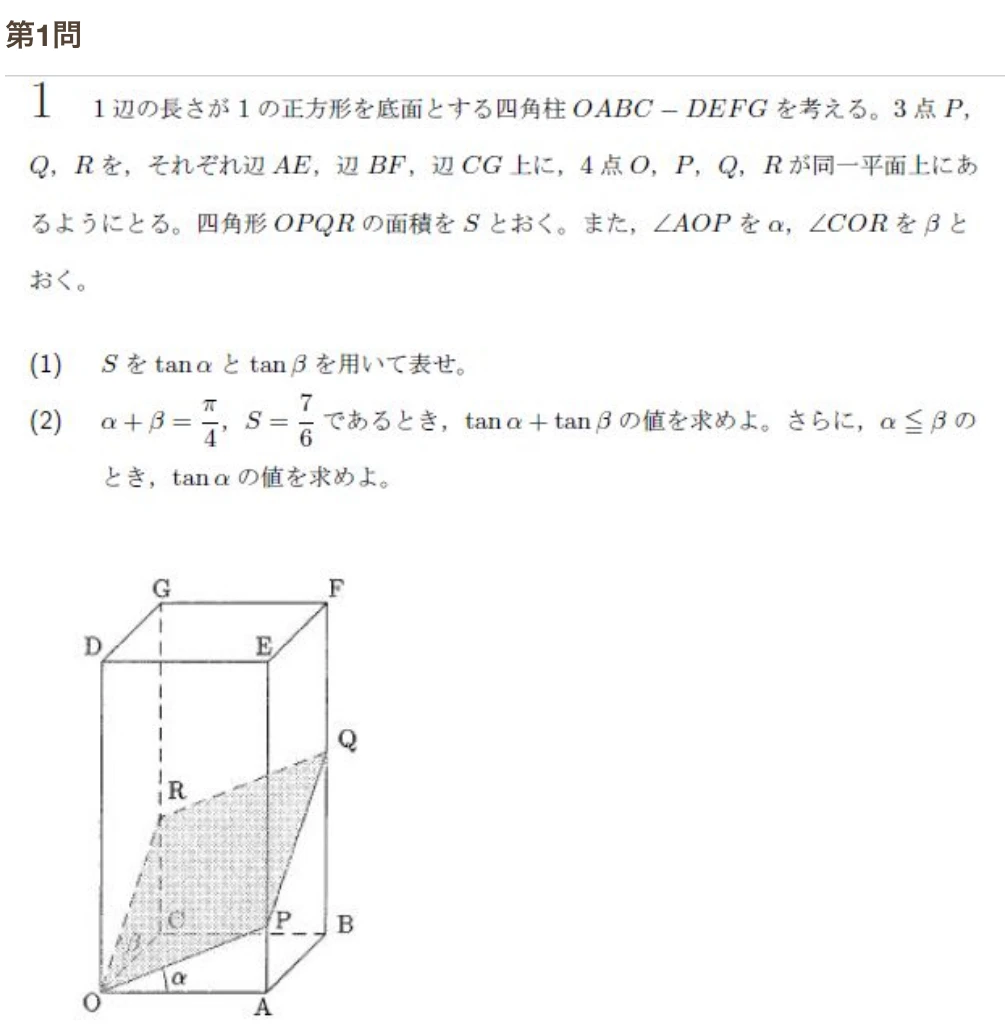
Efecto de entrada
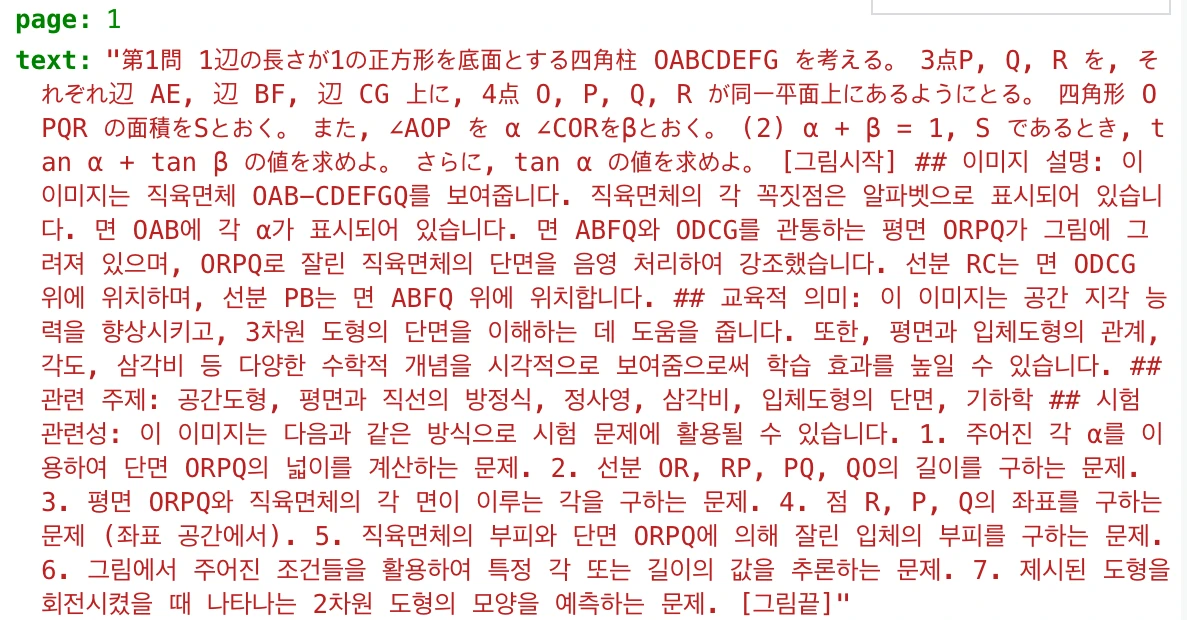
Efecto de salida
Aplicaciones de Versatile-OCR-Program
Campo educativo: se utiliza para extraer y organizar datos de materiales educativos como exámenes y artículos académicos, proporcionando soporte para la investigación y el aprendizaje educativo.
Entrenamiento de aprendizaje automático: genera conjuntos de datos de entrenamiento de alta calidad para entrenar modelos de aprendizaje automático, especialmente en aplicaciones del campo educativo.
Procesamiento de documentos multilingües: adecuado para escenarios que requieren el procesamiento de documentos en varios idiomas, como el intercambio académico internacional, la digitalización de materiales educativos multilingües, entre otros.
Proyecto en GitHub:https://github.com/ses4255/Versatile-OCR-Program









