
 Asistente de guiones▸
 Apps AI
 Noticias AI
Dolphin: un modelo de reconocimiento automático de voz para lenguas orientales, lanzado conjuntamente por Datatang y la Universidad de Tsinghua
小编 ·

Dolphin: un modelo de reconocimiento automático de voz para lenguas orientales, lanzado conjuntamente por Datatang y la Universidad de Tsinghua
¿Qué es Dolphin?
Dolphin es un modelo de reconocimiento automático de voz diseñado específicamente para lenguas orientales, desarrollado conjuntamente por DataoceanAI y el Laboratorio de Tecnología de Voz y Audio del Departamento de Ingeniería Electrónica de la Universidad de Tsinghua.Dolphin admite 40 idiomas orientales y 22 dialectos chinos. Ofrece alta precisión y gran robustez, siendo capaz de adaptarse a entornos de voz complejos. Dolphin se utiliza ampliamente en escenarios de conversión de voz a texto, interacción por voz y análisis de contenido de voz, y admite instalación con un solo clic y múltiples métodos de invocación.
Características del modelo Dolphin
Soporte multilingüe: Dolphin admite 40 idiomas orientales, incluidos idiomas de Asia oriental, meridional, sudoriental y Oriente Medio, así como 22 dialectos chinos (incluido el mandarín).
Adaptación al idioma: identifica automáticamente el idioma del audio de entrada sin necesidad de especificarlo manualmente.
Alta precisión: en varios conjuntos de pruebas, la tasa de error de palabras (WER) es significativamente inferior a la de modelos similares.
Gran robustez: se adapta a entornos de voz complejos con diferentes acentos, velocidades de habla y ruido de fondo.
Alto rendimiento: en los tres conjuntos de pruebas de DataoceanAI, Fleurs y CommonVoice, en comparación con modelos Whisper del mismo tamaño, la tasa de error de palabras (WER) de Dolphin se reduce significativamente. Por ejemplo, la WER media se reduce un 63,1 % en la versión base y un 68,2 % en la versión small.
Código abierto: los modelos base y small, junto con el código de inferencia de Dolphin, son totalmente de código abierto.
Arquitectura técnica de Dolphin
Estructura de red: basada en la arquitectura CTC-Attention, utiliza un codificador E-Branchformer y un decodificador Transformer, e incorpora una capa de submuestreo 4x. Esta estructura combina la capacidad de modelado de secuencias de CTC con la capacidad de captura de contexto del mecanismo de atención, lo que mejora eficazmente la precisión y la eficiencia del reconocimiento del modelo.
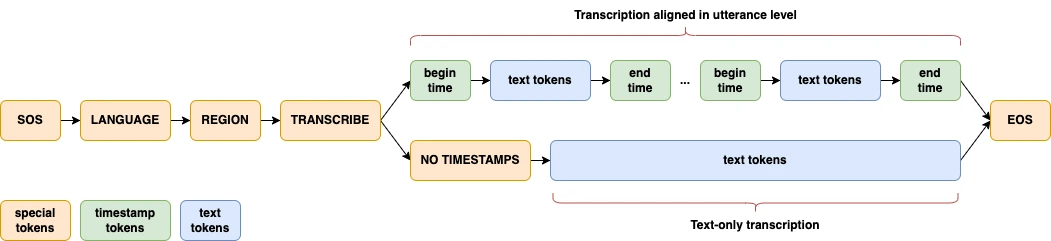
Formato multitarea: Dolphin toma como referencia los métodos de diseño de Whisper y OWSM, centrándose en ASR e introduce varias modificaciones clave, como eliminar el uso del texto anterior y sus etiquetas asociadas, simplificando el formato de entrada. Además, Dolphin introduce un sistema de etiquetas de idioma de dos niveles para gestionar mejor la diversidad lingüística y regional.
Base de datos
El conjunto de datos de entrenamiento de Dolphin combina datos propietarios de DataoceanAI con múltiples conjuntos de datos de código abierto, con una duración total superior a 212 000 horas. Entre ellos, el conjunto de datos de DataoceanAI contiene 137 712 horas de audio que abarcan 38 idiomas orientales.
Escenarios de aplicación
Conversión de voz a texto: adecuado para escenarios como transcripción de reuniones y entrada de voz.
Interacción por voz: utilizado en asistentes de voz con ia, hogares inteligentes, etc., para mejorar la experiencia de interacción.
Análisis de contenido de voz: transcripción y análisis rápidos del contenido de medios de voz.
Tutorial de uso de Dolphin
Instalación: los usuarios pueden instalarlo con un solo clic mediante el comando pip install -U dataoceanai-dolphin.
Invocación por línea de comandos: por ejemplo, utilice dolphin audio.wav para realizar el reconocimiento de voz. También puede especificar la versión del modelo, el idioma y las etiquetas regionales.
Invocación en Python: importe el módulo dolphin , cargue el audio y el modelo, y podrá realizar el reconocimiento de voz.
Enlaces relacionados
Dirección de Github: https://github.com/DataoceanAI/Dolphin
Página del proyecto: https://huggingface.co/DataoceanAI









