
 Asistente de guiones▸
 Apps AI
 Noticias AI
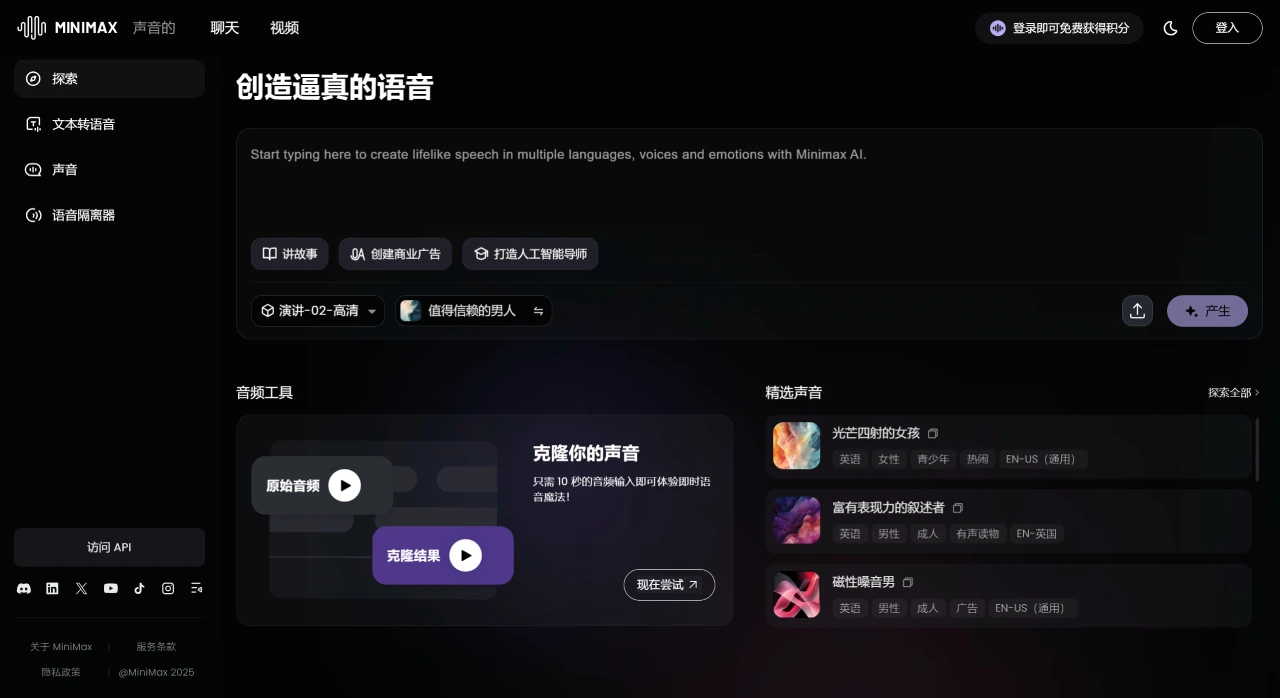
Speech-02: un potente modelo de texto a voz (TTS) de MiniMax Audio
小编 ·

Speech-02: un potente modelo de texto a voz (TTS) de MiniMax Audio
¿Qué es Speech-02?
MiniMax Audio Speech-02 es un potente modelo de texto a voz (TTS) capaz de convertir cualquier archivo o URL en audio realista al instante. Admite entradas únicas de hasta 200 000 caracteres, cubre más de 30 idiomas y ofrece acentos auténticos. Además, Speech-02 admite clonación de voz ilimitada, procesamiento de streaming por debajo del segundo y múltiples formatos de audio (como FLAC, WAV, MP3 y PCM).
El modelo Speech-02 está disponible en dos versiones: speech-02-hd-preview (que ofrece un 99 % de similitud de voz y una claridad de calidad de estudio, ideal para locuciones, audiolibros y otros escenarios que requieren un rendimiento realista) y speech-02-turbo-preview (que logra un equilibrio entre baja latencia y alto rendimiento, ideal para aplicaciones en tiempo real).
Capacidades de idiomas y voces
Soporte multilingüe: Speech-02 admite texto a voz en más de 30 idiomas, incluidos inglés, chino, japonés, coreano, francés, alemán, español, portugués, italiano, árabe, ruso, turco, holandés, ucraniano, vietnamita, hindi, tailandés, polaco, rumano, griego, finlandés e indonesio, con acentos auténticos.
Amplia biblioteca de voces: cuenta con más de 300 voces reales y naturales que admiten expresiones auténticas en múltiples idiomas.
Rendimiento técnico
Número de caracteres por entrada: admite entradas únicas de hasta 200 000 caracteres.
Velocidad de procesamiento de streaming: admite procesamiento de streaming por debajo del segundo.
Versiones del modelo: incluye speech-02-hd-preview y speech-02-turbo-preview. La primera se caracteriza por un 99 % de similitud de voz y una claridad de calidad de estudio, ideal para locuciones, audiolibros y otros escenarios que requieren un rendimiento realista; la segunda logra un equilibrio entre baja latencia y alto rendimiento, ideal para aplicaciones en tiempo real.
Características de Speech-02
Clonación de voz ilimitada: capaz de clonar rápidamente voces en diversos estilos y tonos con una calidad líder en el sector.
Control de voz: los usuarios pueden controlar fácilmente la emoción, el volumen, la velocidad y el formato de salida de la voz.
Mezcla de voces: permite combinar voces existentes para crear voces nuevas y únicas.
Compatibilidad con formatos de audio: admite varios formatos de audio como FLAC, WAV, MP3 y PCM.
Escenarios de aplicación de Speech-02
Producción de audiolibros: ideal para convertir novelas extensas, artículos académicos, etc., en contenido de audio de alta calidad.
Creación de podcasts: ayuda a los creadores de podcasts a producir contenido más atractivo y diverso.
Locución para cine y videojuegos: ofrece graves de calidad cinematográfica y efectos de audio envolventes.
Conferencias internacionales y traducción: admite cambios instantáneos y fluidos entre múltiples idiomas.
Actualmente, el modelo Speech-02 ya está disponible en la plataforma MiniMax Audio y en la plataforma de API, pero la versión para China aún no se ha lanzado.
Enlaces oficiales
Plataforma MiniMax Audio: https://www.minimax.io/audio
Plataforma API de MiniMax Audio: https://www.minimax.io/platform









