
 Asistente de guiones▸
 Apps AI
 Noticias AI
SegAnyMo: identifica y segmenta con precisión los objetos en movimiento en vídeos
小编 ·

SegAnyMo: identifica y segmenta con precisión los objetos en movimiento en vídeos
¿Qué es SegAnyMo?
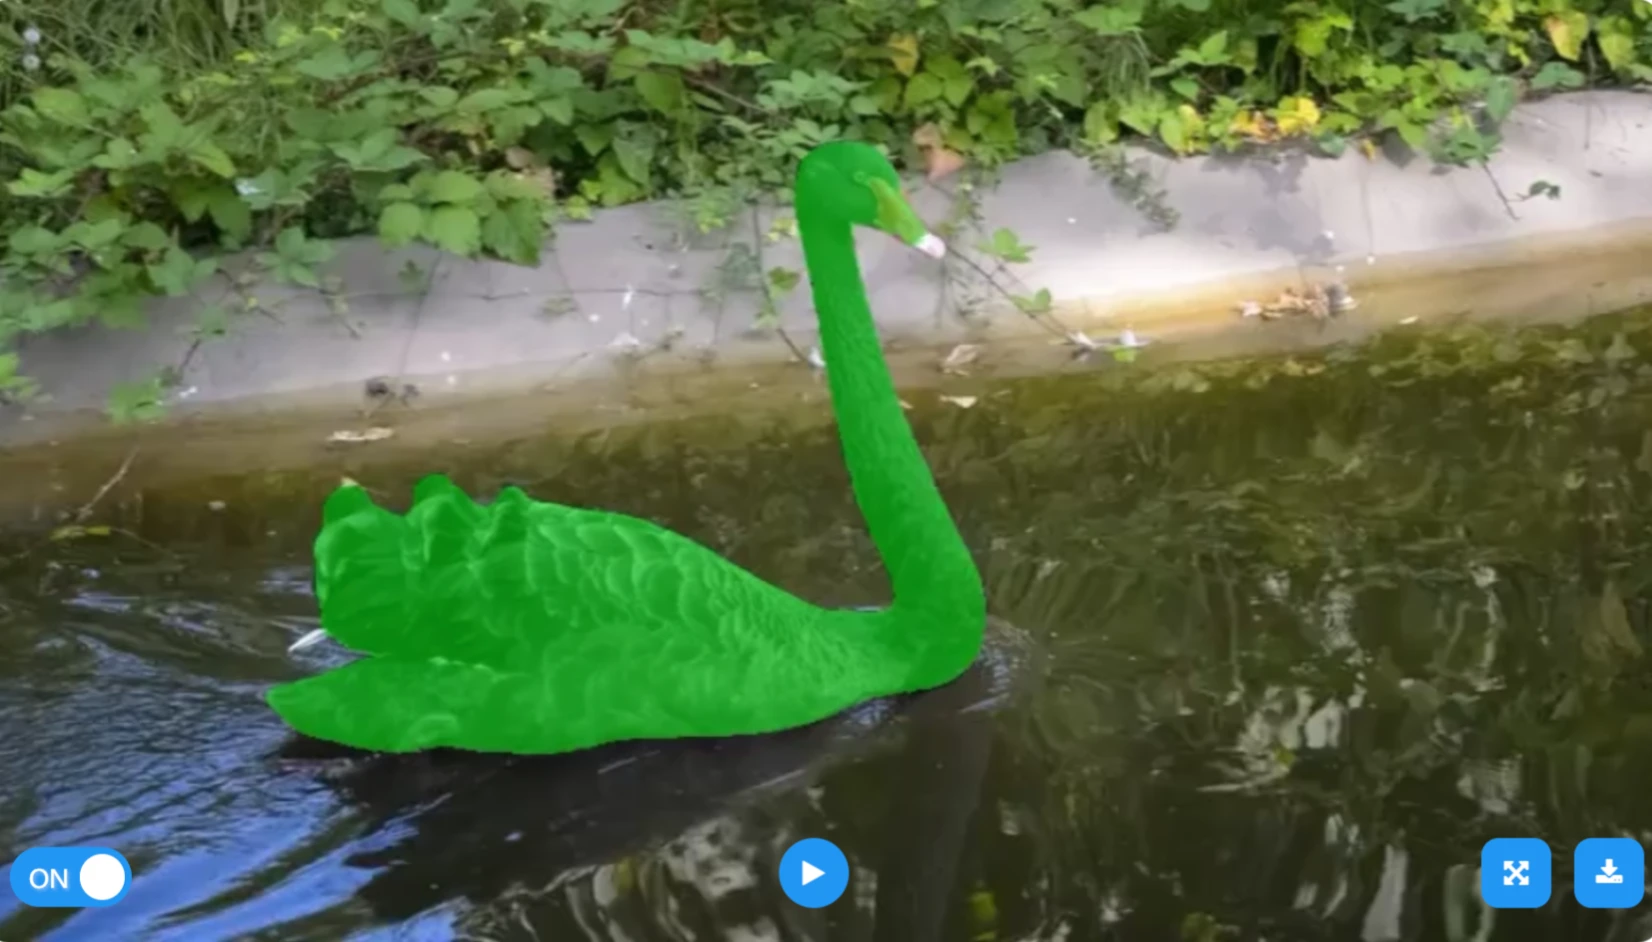
SegAnyMo (Segment Any Motion in Videos) es una herramienta inteligente de "eliminación de fondo de vídeo" y "recorte" basada en IA. Puede identificar y segmentar con precisión los objetos en movimiento dentro de un vídeo de forma automática. No requiere anotaciones manuales y es capaz de segmentar múltiples objetos en movimiento en el vídeo, incluso en escenas con objetos que se mueven a alta velocidad, imágenes borrosas o fondos complejos.
Contexto de la investigación
La segmentación de objetos en movimiento es una tarea clave para lograr una comprensión avanzada de escenas visuales, con numerosas aplicaciones posteriores. La mayoría de los estudios anteriores dependían del flujo óptico para proporcionar pistas de movimiento, pero este método, al enfrentarse a desafíos como movimiento parcial, deformaciones complejas, desenfoque por movimiento e interferencias del fondo, solía producir predicciones imprecisas.
Descripción del método
Esta investigación propone un nuevo método de segmentación de objetos en movimiento que combina pistas de movimiento de trayectorias de largo alcance con características semánticas basadas en DINO, y utiliza SAM2 con una estrategia de提示 iterativa para densificar máscaras a nivel de píxel. El proceso específico es el siguiente:
Procesamiento de entrada: toma como entrada trayectorias 2D y mapas de profundidad generados por modelos ya existentes; mediante un codificador de movimiento se capturan los patrones de movimiento y se generan trayectorias de características.
Decodificación de trayectorias: se utiliza un decodificador de trayectorias que integra características DINO para decodificar las trayectorias de características; desacoplando la información de movimiento y semántica, se obtienen finalmente trayectorias dinámicas.
Generación de máscaras: se utiliza SAM2 para agrupar las trayectorias dinámicas que pertenecen al mismo objeto y generar máscaras refinadas del objeto en movimiento.
Funciones de SegAnyMo
Detección y segmentación de objetos en movimiento: detecta automáticamente los objetos en movimiento en el vídeo y genera las máscaras de segmentación correspondientes, identificando con precisión el contorno y la posición de los objetos en movimiento.
Manejo de escenas complejas: es capaz de hacer frente a escenas complejas con movimiento parcial, deformaciones complejas, desenfoque por movimiento e interferencias del fondo, manteniendo una segmentación precisa del objeto objetivo.
Segmentación multi-objeto: puede detectar y segmentar simultáneamente múltiples objetivos en movimiento en el vídeo, generando máscaras de segmentación independientes para cada uno, lo que facilita su procesamiento y análisis individual.
Capacidad de generalización: posee una fuerte capacidad de generalización y puede adaptarse a distintos conjuntos de datos y escenas de vídeo, manteniendo una alta precisión de segmentación incluso en escenas nunca antes vistas.
Combinación de información semántica: al combinar información semántica, segmenta con mayor precisión los objetos en movimiento y evita identificar erróneamente objetos estáticos como objetos en movimiento.
Capacidad de tiempo real y eficiencia: satisface en cierta medida las necesidades de procesamiento en tiempo real, siendo aplicable a escenarios con elevados requisitos de tiempo real.
Soporte de múltiples entradas: admite diversos datos de entrada como trayectorias 2D y mapas de profundidad, y permite ajustar con flexibilidad la estrategia de segmentación según las diferentes condiciones de entrada.
Escalabilidad: el diseño de la arquitectura presenta una buena escalabilidad, pudiendo mejorarse el rendimiento o adaptarse a nuevos requisitos de tarea mediante la incorporación o el ajuste de módulos.
Ventajas técnicas
Mecanismo de atención de trayectorias espacio-temporales: gracias a este mecanismo, el modelo puede prestar mayor atención a la información de movimiento y, al mismo tiempo, combinar el soporte semántico, lo que permite segmentar con precisión los objetos en movimiento incluso en escenas complejas.
Embedding con desacoplo de movimiento y semántica: evita juicios erróneos derivados de una dependencia excesiva del modelo en la información semántica; por ejemplo, no clasificará incorrectamente una calzada estática como objeto dinámico.
Sólida capacidad de generalización: las exhaustivas pruebas realizadas en múltiples conjuntos de datos demuestran que el modelo ofrece un rendimiento destacado en escenas difíciles y en la segmentación fina de múltiples objetivos.
Escenarios de aplicación
Videovigilancia: detecta en tiempo real objetivos en movimiento como peatones y vehículos, reduciendo las falsas alarmas y mejorando la precisión de la vigilancia de seguridad.
Conducción autónoma: identifica obstáculos dinámicos en la carretera para ayudar en la toma de decisiones de la conducción autónoma.
Análisis de vídeo deportivo: segmenta los movimientos de los deportistas y admite el análisis de acciones complejas y escenarios con varias personas.
Seguridad inteligente: evita falsas alarmas provocadas por objetos estáticos y mejora la fiabilidad del sistema.
Edición de vídeo: clasifica y procesa los distintos objetivos en movimiento, facilitando la incorporación de efectos especiales y la sustitución de objetivos.
Monitorización del tráfico: analiza el movimiento de múltiples vehículos y admite la gestión del flujo de tráfico.
Visión para robots: utiliza mapas de profundidad para segmentar objetivos en movimiento y ayudar en la navegación y evasión de obstáculos del robot.
Videoconferencias multi-persona: segmenta la imagen de los interlocutores para mejorar la experiencia de interacción.
Ámbito académico y de desarrollo: el código abierto facilita la reproducción y el desarrollo secundario, y admite el entrenamiento y la prueba con nuevos conjuntos de datos.
Página del proyecto:https://motion-seg.github.io/
Dirección de Github:https://github.com/nnanhuang/SegAnyMo









