
 Asistente de guiones▸
 Apps AI
 Noticias AI
VideoMind: herramienta de IA todo-en-uno para producción automatizada de vídeo, razonamiento sobre vídeos largos y resúmenes de vídeo
小编 ·

VideoMind: herramienta de IA todo-en-uno para producción automatizada de vídeo, razonamiento sobre vídeos largos y resúmenes de vídeo
¿Qué es VideoMind?
VideoMind es una herramienta de IA para vídeos que integra funciones como la producción automatizada de modelos de IA de vídeo, la inferencia de vídeos largos y la generación de resúmenes de vídeo. Se basa en operaciones en forma de flujo de trabajo, con un alto grado de automatización, incorpora una gran cantidad de datos y permite entrenar rápidamente modelos de alta calidad. Además, mediante la estrategia Chain-of-LoRA, realiza inferencias sobre vídeos largos, localizando con precisión y generando respuestas. Asimismo, puede generar resúmenes de vídeo con un solo clic, ayudando a los usuarios a extraer rápidamente la información clave y mejorando la eficiencia en el procesamiento de contenidos de vídeo.
Características y funcionalidades de VideoMind
Funcionalidad integral: integra todas las funciones desde la creación hasta la publicación de modelos, incluyendo 7 etapas: crear un nuevo modelo, crear etiquetas, subir datos, anotar datos, entrenar el modelo, evaluar y validar, y publicar el modelo.
Datos abundantes: integra hasta millones de horas de datos anotados e incorpora una gran cantidad de etiquetas temáticas y de entidades. Si los usuarios logran mapear correctamente las etiquetas que crean con las etiquetas incorporadas, no será necesario subir ni anotar datos para esas etiquetas.
Producción eficiente: por un lado, el flujo de producción automatizado reduce la barrera técnica y ahorra tiempo de desarrollo a los clientes; por otro lado, la estructura y los parámetros de la red IA preentrenada incorporada permiten a los clientes entrenar e iterar modelos rápidamente.
Alta calidad del modelo: gracias a la amplia experiencia de Baidu en el campo de la IA, los modelos producidos por VideoMind ofrecen un rendimiento excelente y pueden satisfacer las necesidades de análisis de contenido de vídeo e imágenes verticales de las empresas.
Implementación flexible: los modelos entrenados admiten su implementación en la nube pública, la nube privada, dispositivos embebidos, etc., y posteriormente los clientes pueden invocarlos mediante API.
Generación de resúmenes con un solo clic: permite generar con un solo clic resúmenes de vídeo, traducciones y formatos de publicaciones en redes sociales.
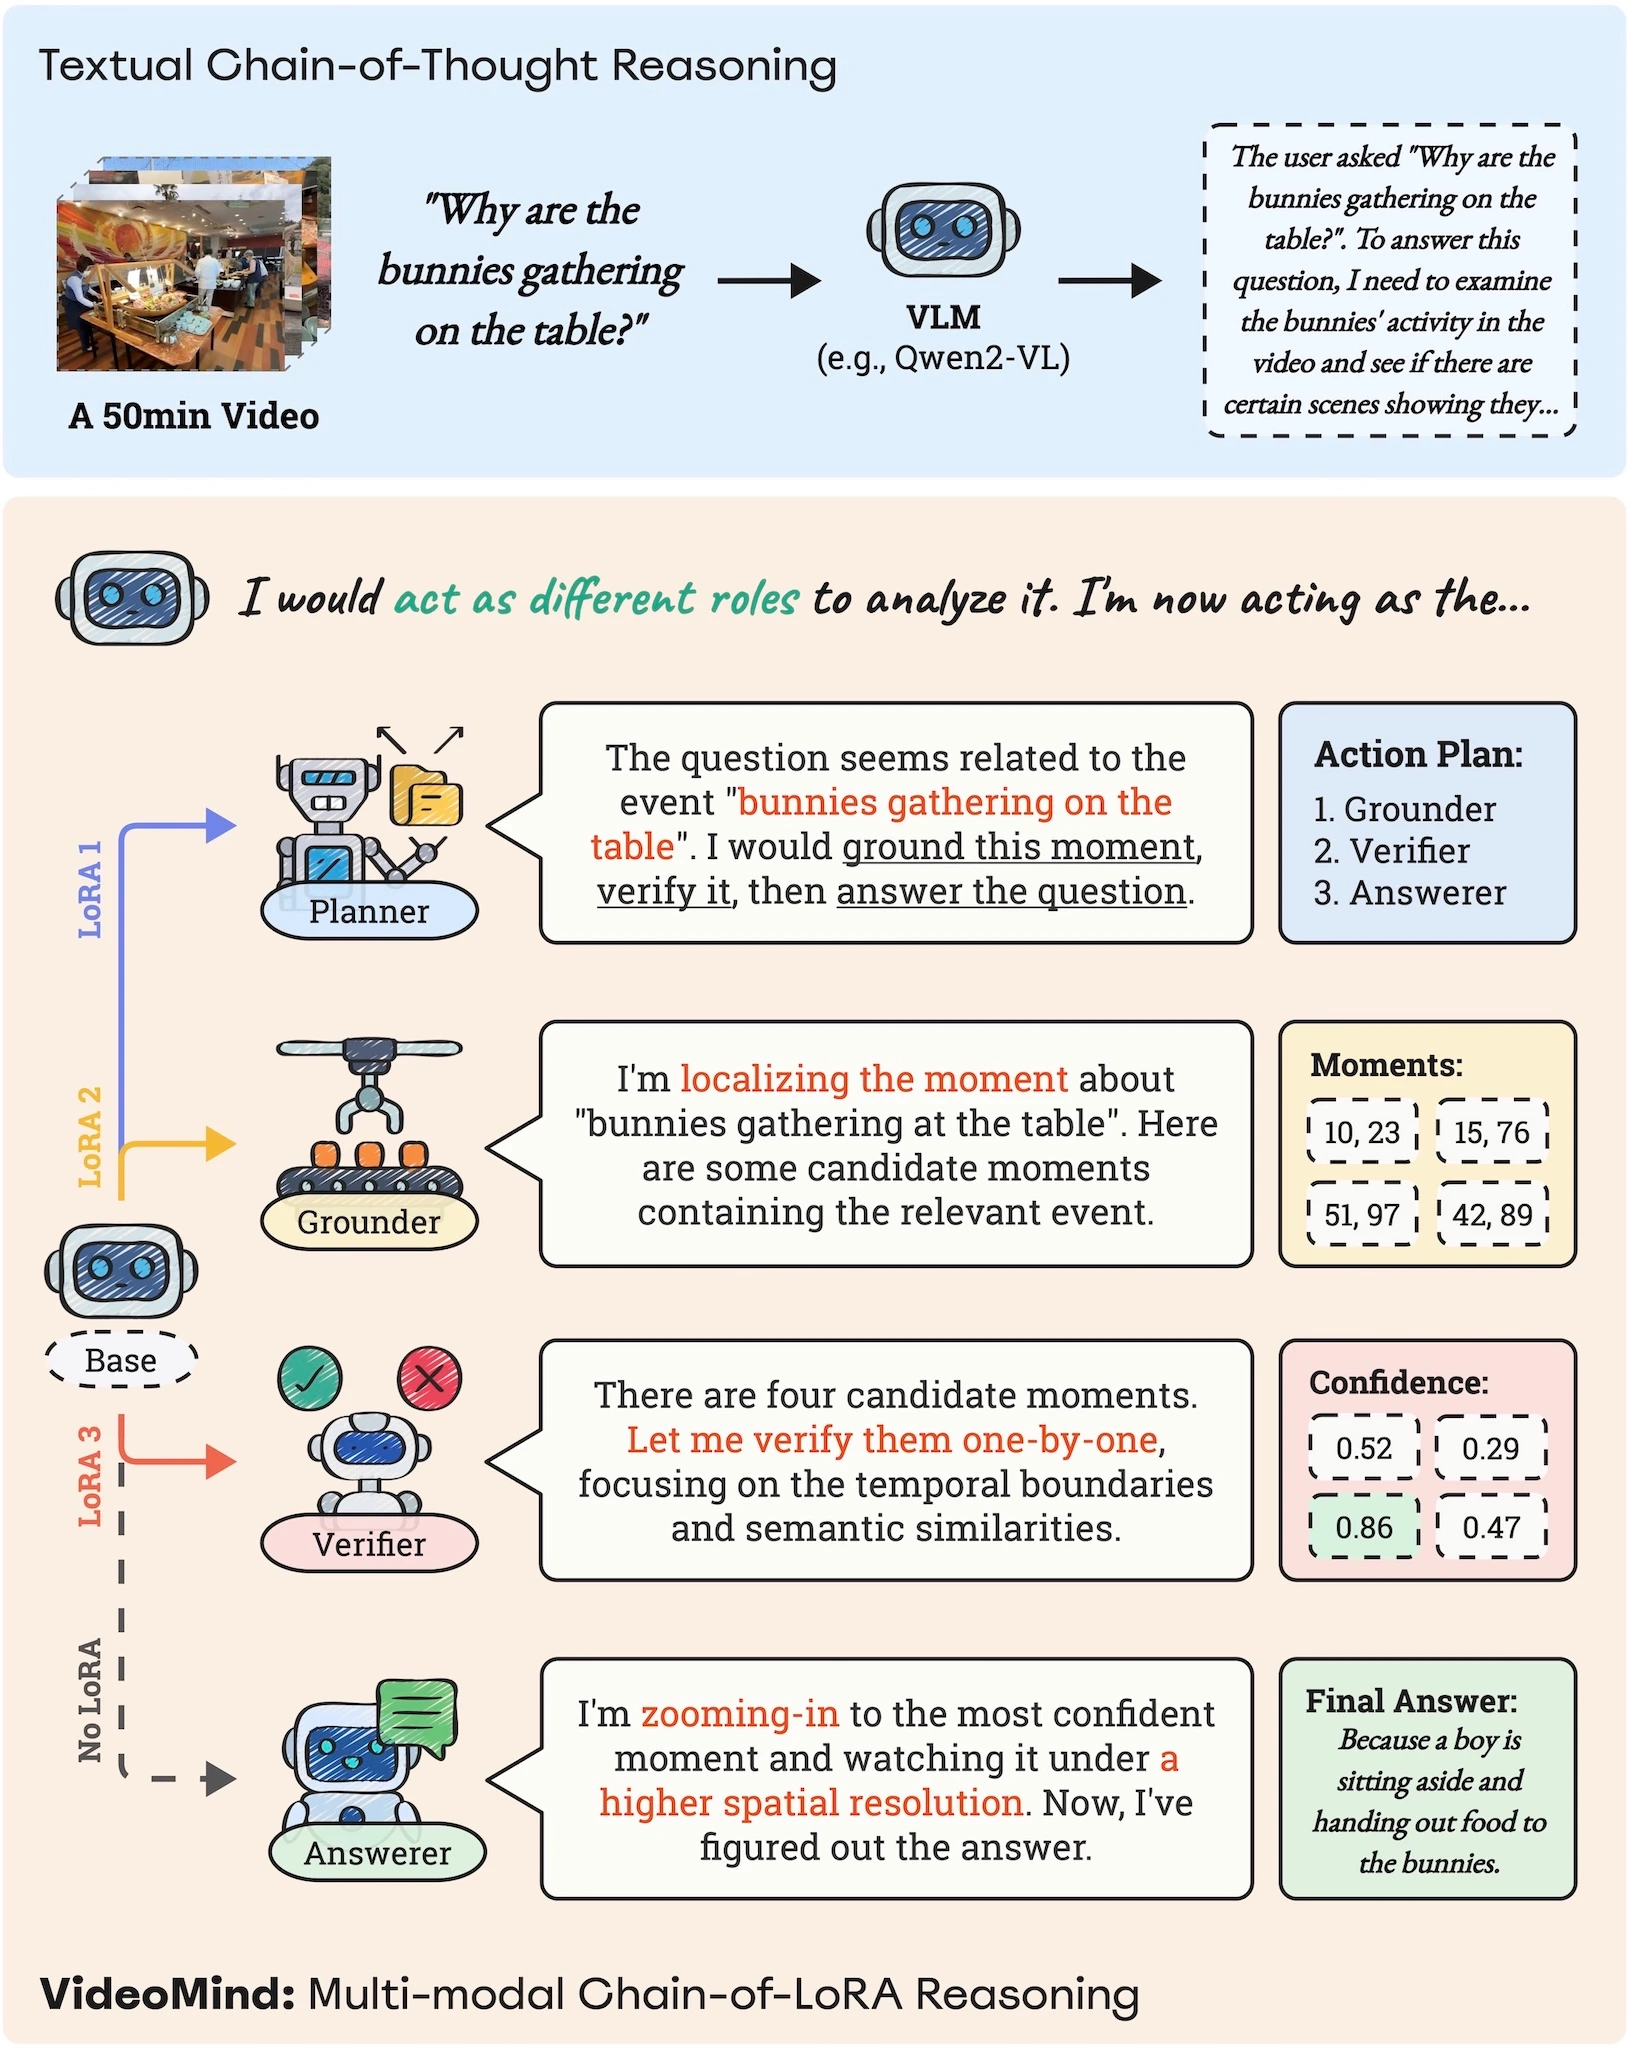
Capacidad de inferencia en vídeos largos: mediante un flujo de trabajo basado en roles (incluyendo planner, grounder, verifier y answerer) y la estrategia Chain-of-LoRA, logra una localización temporal precisa y razonamiento sobre vídeos largos, siendo capaz de manejar de forma eficiente tareas complejas de comprensión de vídeo.
Extracción rápida de información clave: ayuda a los usuarios a analizar y resumir de forma rápida y precisa la información clave de vídeos de YouTube, ahorrando tiempo y esfuerzo.
Agente Chain-of-LoRA para inferencia en vídeos largos
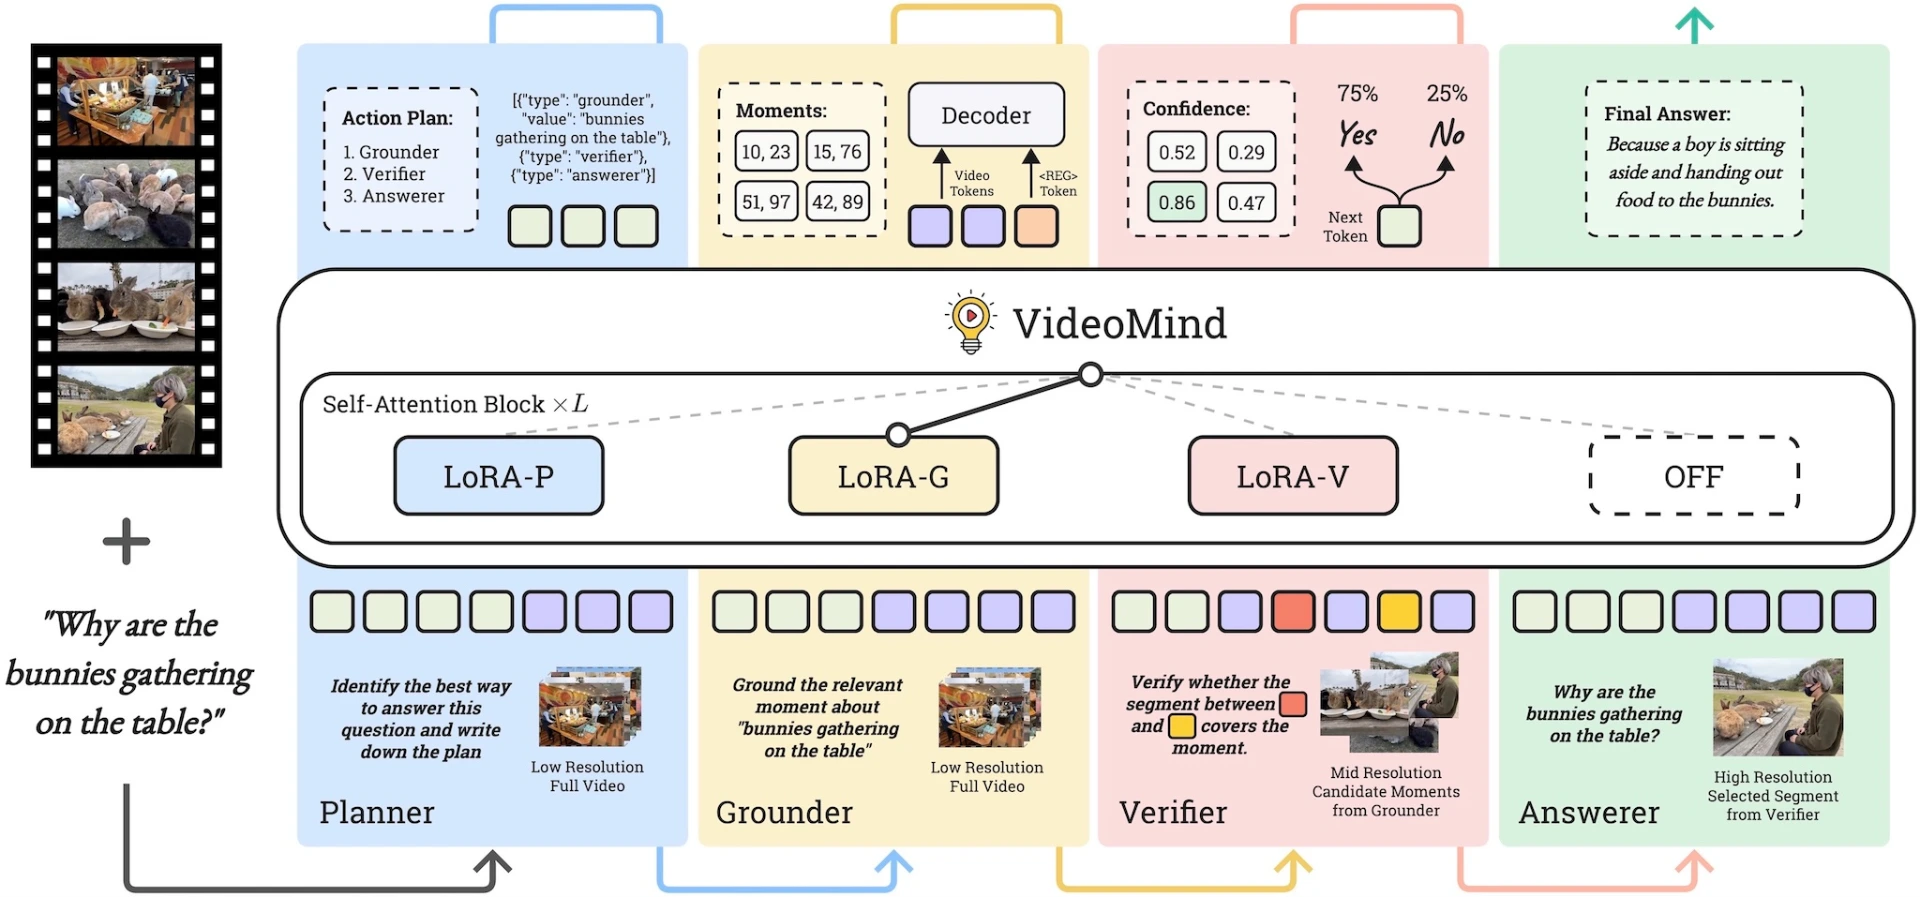
Flujo de trabajo basado en roles: define cuatro roles que colaboran entre sí para lograr la inferencia en vídeos largos: planner, grounder, verifier y answerer.
Planificador (Planner): se encarga de coordinar dinámicamente el orden de invocación de los demás roles según la consulta.
Localizador (Grounder): se encarga de localizar con precisión los momentos relevantes del vídeo a partir de una consulta de texto.
Verificador (Verifier): se encarga de verificar la precisión de los resultados del localizador.
Respondedor (Answerer): se encarga de generar la respuesta final en lenguaje natural.
Estrategia Chain-of-LoRA: tomando como base un modelo visión-lenguaje, activa dinámicamente durante la inferencia los adaptadores LoRA específicos de cada rol, integrando eficientemente los roles mencionados anteriormente.
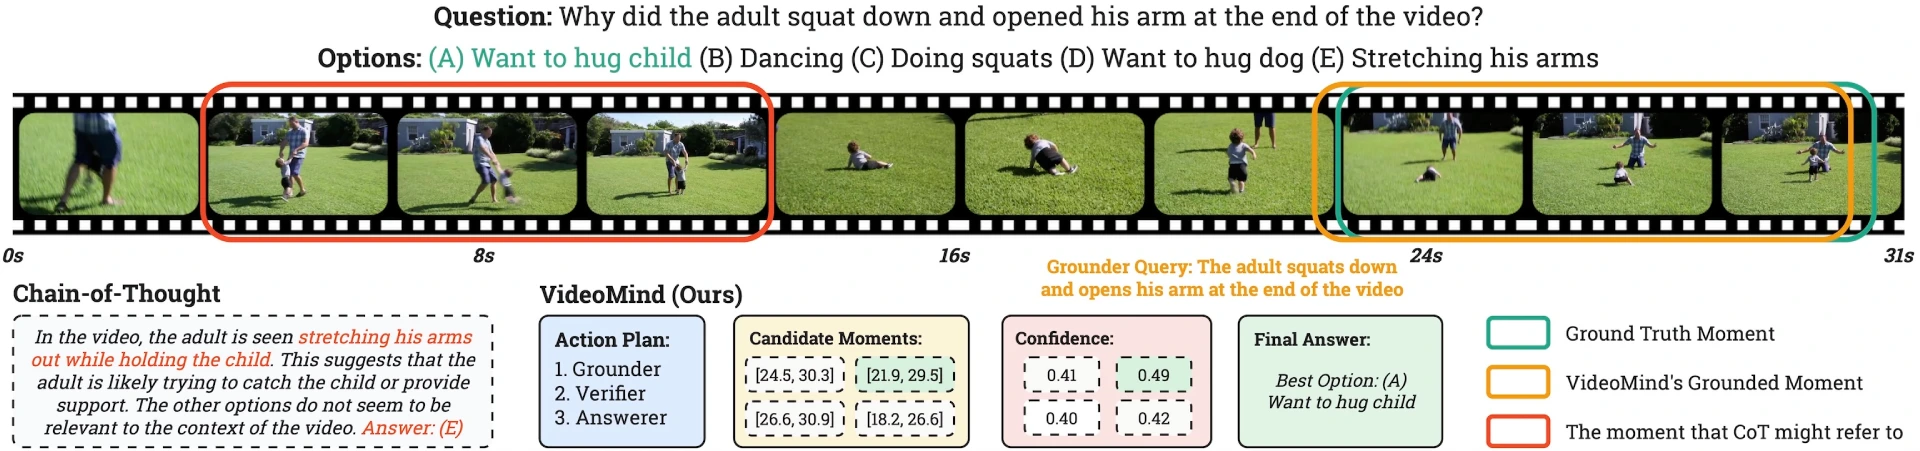
Rendimiento destacado: ofrece un rendimiento sobresaliente en múltiples benchmarks públicos, incluyendo tareas detalladas de preguntas y respuestas sobre vídeo, tareas de localización temporal en vídeo y tareas generales de preguntas y respuestas sobre vídeo.
Casos de uso de VideoMind
Ámbito educativo: los estudiantes pueden obtener rápidamente el contenido clave de los vídeos de sus cursos, facilitando el estudio y la revisión.
Análisis empresarial: las empresas pueden generar resúmenes de vídeos de investigación de mercado, obteniendo rápidamente tendencias del sector e información sobre la competencia.
Creación de contenidos: los creadores de vídeo pueden extraer la esencia de sus propios vídeos para elaborar material promocional o contenido para redes sociales.
Entretenimiento y consumo: al ver vídeos largos, los usuarios pueden conocer rápidamente el contenido principal del vídeo, lo que les ayuda a decidir si ven el vídeo completo.
Redes sociales: en las plataformas de vídeos cortos, los usuarios pueden extraer los momentos más destacados de los vídeos para crear contenido atractivo en formato corto.
Enlaces relacionados
Página del proyecto:https://videomind.github.io/
Repositorio en Github:https://github.com/yeliudev/VideoMind
Demo:https://huggingface.co/spaces/yeliudev/VideoMind-2B
Paper:https://arxiv.org/abs/2503.13444









