
 Asistente de guiones▸
 Apps AI
 Noticias AI
MegaTTS 3: sistema de síntesis de texto a voz zero-shot de ByteDance
小编 ·

MegaTTS 3: sistema de síntesis de texto a voz zero-shot de ByteDance
¿Qué es MegaTTS 3?
MegaTTS 3 es un sistema de síntesis de texto a voz de cero disparos lanzado por ByteDance. Utiliza un modelo de difusión ligero que descompone la voz en atributos como contenido, timbre y prosodia para su modelado, y admite funciones como clonación de voz de ultra alta calidad, síntesis bilingüe y control de intensidad de acento, aplicables a escenarios de síntesis de voz y edición de voz.
Arquitectura principal y tecnología
Modelo de difusión ligero y eficiente: el núcleo de MegaTTS 3 es el TTS Diffusion Transformer, con solo 0.45B de parámetros, que garantiza eficiencia y, al mismo tiempo, genera voz de alta calidad.
Descomposición y modelado de voz: la voz se descompone en diferentes atributos como contenido, timbre y prosodia, y se diseñan módulos específicos para modelar cada atributo. Por ejemplo, se utilizan vectores globales para modelar el timbre, ya que es un atributo global que cambia lentamente con el tiempo; se emplea un modelo acústico basado en VQGAN para generar espectrogramas, y un modelo de lenguaje basado en códigos latentes para ajustar la distribución de la prosodia, ya que esta cambia rápidamente dentro de una oración y el modelo de lenguaje puede capturar dependencias locales y de largo alcance.
Vocoder: se utiliza un vocoder basado en GAN para construir adecuadamente la fase, sin necesidad de que el modelo de lenguaje la modele.
Características y funciones de MegaTTS 3
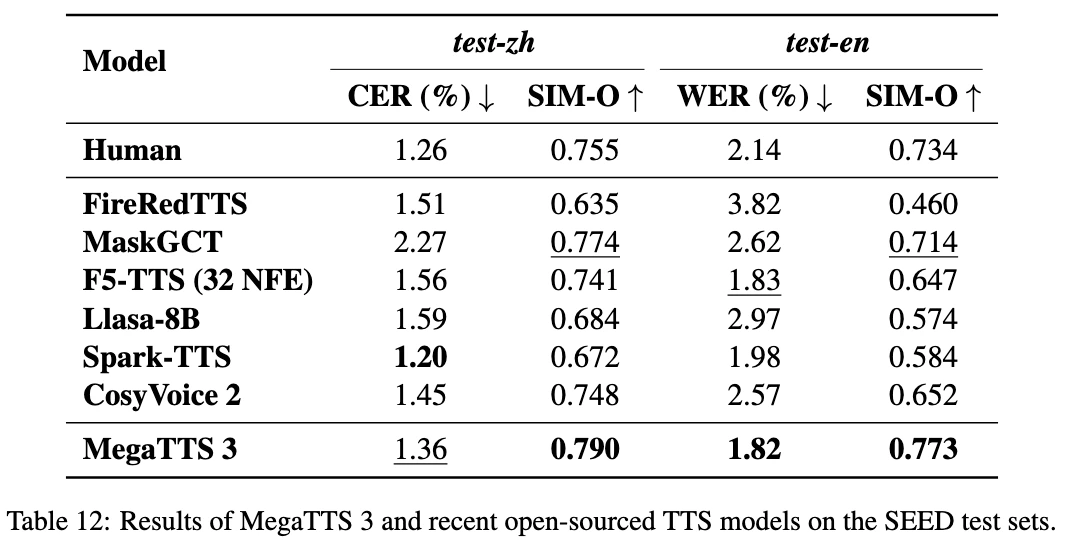
Clonación de voz de ultra alta calidad: capaz de generar voz altamente similar a la del hablante objetivo.
Soporte bilingüe: compatible con chino e inglés, así como con síntesis de voz mixta chino-inglés.
Controlabilidad: admite control de la intensidad del acento y, en el futuro, soportará ajustes más precisos de pronunciación/duración.
Síntesis de voz de cero disparos: capaz de generar la voz de un hablante objetivo sin necesidad de datos de voz específicos de dicho hablante.
Escenarios de aplicación de MegaTTS 3
Síntesis de voz: se puede utilizar en diversos escenarios que requieren convertir texto en voz, como audiolibros, anuncios de voz, etc.
Edición de voz: permite editar y modificar la voz para satisfacer diferentes necesidades.
Síntesis de voz multilingüe: admite tareas de síntesis de voz entre diferentes idiomas.
Tutorial de uso de MegaTTS 3
Herramienta de línea de comandos: proporciona una interfaz de línea de comandos que permite a los usuarios generar voz sintética especificando el archivo de提示 de voz de entrada y el contenido de texto. Por ejemplo:
Comando estándar de síntesis de voz:
CUDA_VISIBLE_DEVICES=0 python tts/infer_cli.py --input_wav 'assets/Chinese_prompt.wav' --input_text "另一边的桌上,一位读书人嗤之以鼻道,'佛子三藏,神子燕小鱼是什么样的人物,李家的那个李子夜如何与他们相提并论?'" --output_dir ./gen
Comando de síntesis de voz con control de acento:
CUDA_VISIBLE_DEVICES=0 python tts/infer_cli.py --input_wav 'assets/English_prompt.wav' --input_text '这是一条有口音的音频。' --output_dir ./gen --p_w 1.0 --t_w 3.0
Interfaz web (Web UI): también admite la síntesis de voz a través de una interfaz web.
Instalación de MegaTTS 3
Requisitos del entorno: se necesita un entorno de Python 3.9.
Descarga del modelo: los checkpoints del modelo preentrenado se pueden descargar desde Google Drive o Hugging Face y colocarse en el directorio especificado.
Pasos de instalación:
# 创建 Python 3.9 的 conda 环境
conda create -n megatts3-env python=3.9
conda activate megatts3-env
# 安装依赖
pip install -r requirements.txt
Proyecto de GitHub:https://github.com/bytedance/MegaTTS3









