
 Asistente de guiones▸
 Apps AI
 Noticias AI
QVQ-Max: el modelo de razonamiento visual de Alibaba que entiende imágenes y videos
小编 ·

QVQ-Max: el modelo de razonamiento visual de Alibaba que entiende imágenes y videos
¿Qué es QVQ-Max?
QVQ-Max es un modelo de razonamiento visual con la capacidad de comprender el contenido de imágenes y vídeos, capaz de analizar, razonar y ofrecer soluciones basadas en la información relacionada. El modelo QVQ-Max tiene un rendimiento excelente en múltiples campos, como la resolución de problemas matemáticos, el manejo de problemas cotidianos, la asistencia en programación y la creación artística.
Propósito de diseño
Los modelos de IA tradicionales suelen depender de la entrada de texto; sin embargo, en la realidad mucha información se presenta en forma de imágenes, gráficos o vídeos. QVQ-Max tiene como objetivo crear un asistente que sea bueno tanto capturando información visual como analizando rápidamente, ayudando a los usuarios a resolver diversos problemas prácticos.
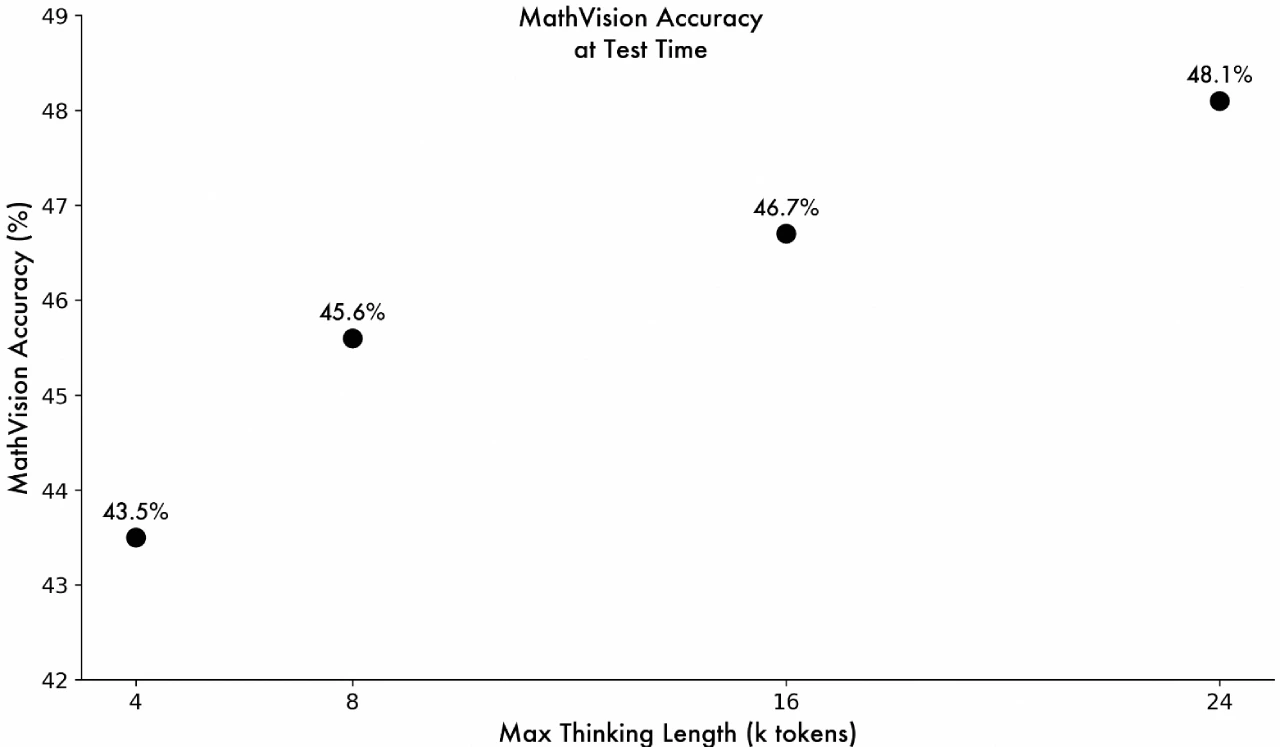
Capacidades principales de QVQ-Max
Observación detallada: QVQ-Max puede identificar rápidamente los elementos clave de una imagen, capturando detalles tanto de gráficos complejos como de fotos cotidianas.
Razonamiento profundo: El modelo no solo identifica el contenido, sino que también razona combinando conocimientos previos. Por ejemplo, puede analizar las figuras de un problema de geometría y deducir la respuesta.
Aplicación flexible: Además de analizar y razonar, QVQ-Max también puede usarse para la creación, como diseñar ilustraciones, generar guiones de vídeos cortos e incluso crear contenido de roleplay según las necesidades del usuario.
Escenarios de aplicación de QVQ-Max
Aplicaciones en el trabajo: Asistir en análisis de datos, organización de información y programación.
Apoyo al aprendizaje: Ayudar a resolver problemas difíciles de materias como matemáticas y física, especialmente los que contienen gráficos.
Asistencia en la vida diaria: Ofrecer consejos de outfits a partir de fotos del armario o guiar la cocina a partir de imágenes de recetas.
Tutorial de uso de QVQ-Max
1. Accede a https://chat.qwen.ai/
2. Selecciona el modelo QWQ-32B
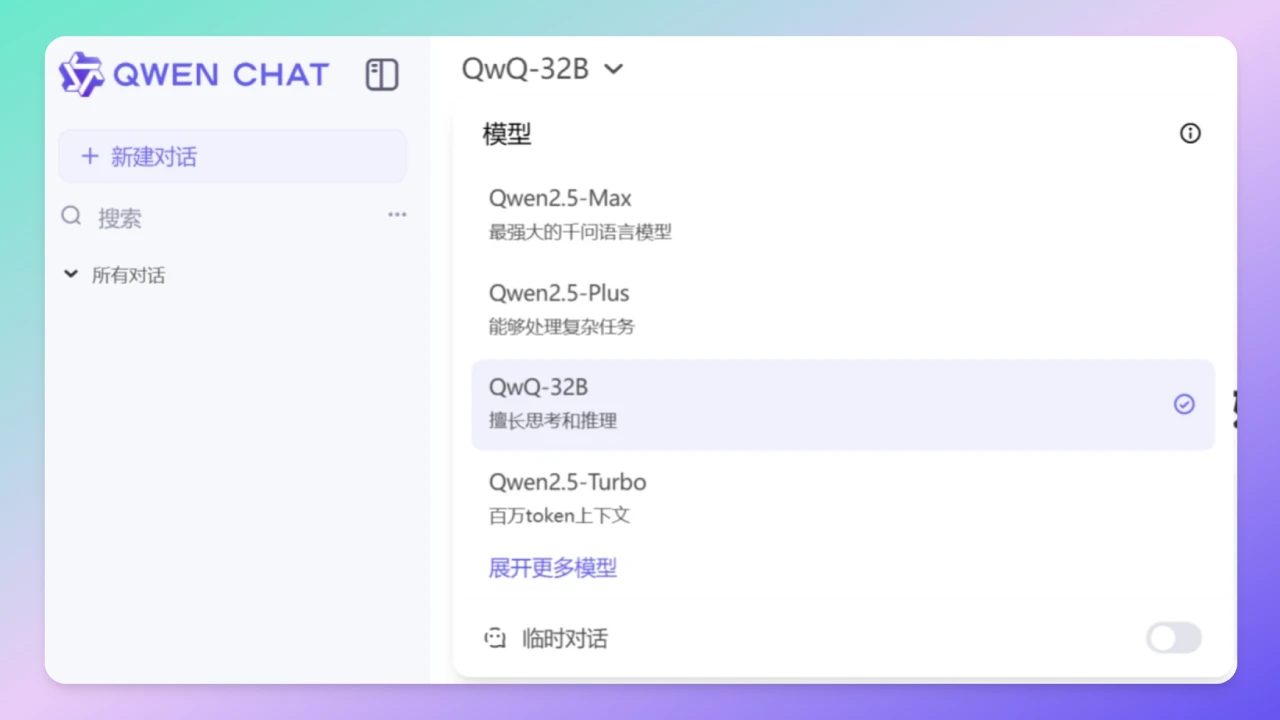
3. Pulsa el signo "+" del cuadro de entrada para subir una imagen o vídeo.
4. Pregunta sobre el contenido de la imagen.
Direcciones de desarrollo futuras
Mejorar la capacidad de observación: Mediante tecnologías de verificación de contenido visual (como grounding), aumentar la precisión del reconocimiento.
Reforzar la capacidad de manejo de tareas: Desarrollar agentes visuales que mejoren la capacidad de procesar tareas multipaso y complejas, como operar teléfonos, ordenadores o jugar.
Optimizar la experiencia de interacción: Ampliar las modalidades de interacción, incluyendo la verificación de herramientas y la generación visual.
QVQ-Max, como modelo de razonamiento visual, tiene un enorme potencial. No solo puede identificar el contenido de las imágenes, sino que también puede analizarlas y razonar combinando la información, e incluso realizar algunas tareas creativas. Aunque actualmente se trata solo de la primera versión, ya muestra un gran potencial y se espera que en el futuro se convierta en un agente visual práctico que brinde un sólido apoyo a los usuarios para resolver problemas reales.
Introducción detallada: https://qwenlm.github.io/zh/blog/qvq-max-preview/
Dirección de uso: https://chat.qwen.ai/









