
 Asistente de guiones▸
 Apps AI
 Noticias AI
KDTalker: genera expresiones faciales realistas y vídeo de movimiento a partir de audio
小编 ·

KDTalker: genera expresiones faciales realistas y vídeo de movimiento a partir de audio
¿Qué es KDTalker?
KDTalker es una herramienta de generación de retratos dinámicos impulsada por audio, capaz de generar expresiones faciales y movimientos realistas a partir de señales de audio de entrada. KDTalker cuenta con tecnología de puntos clave implícitos, un modelo de difusión espacio-temporal y diversidad de posturas. Es adecuada para diversos escenarios como realidad virtual, redes sociales y videoconferencias. Con una sencilla preparación del entorno y operaciones de línea de comandos, los usuarios pueden generar rápidamente vídeos de retratos dinámicos de alta calidad.
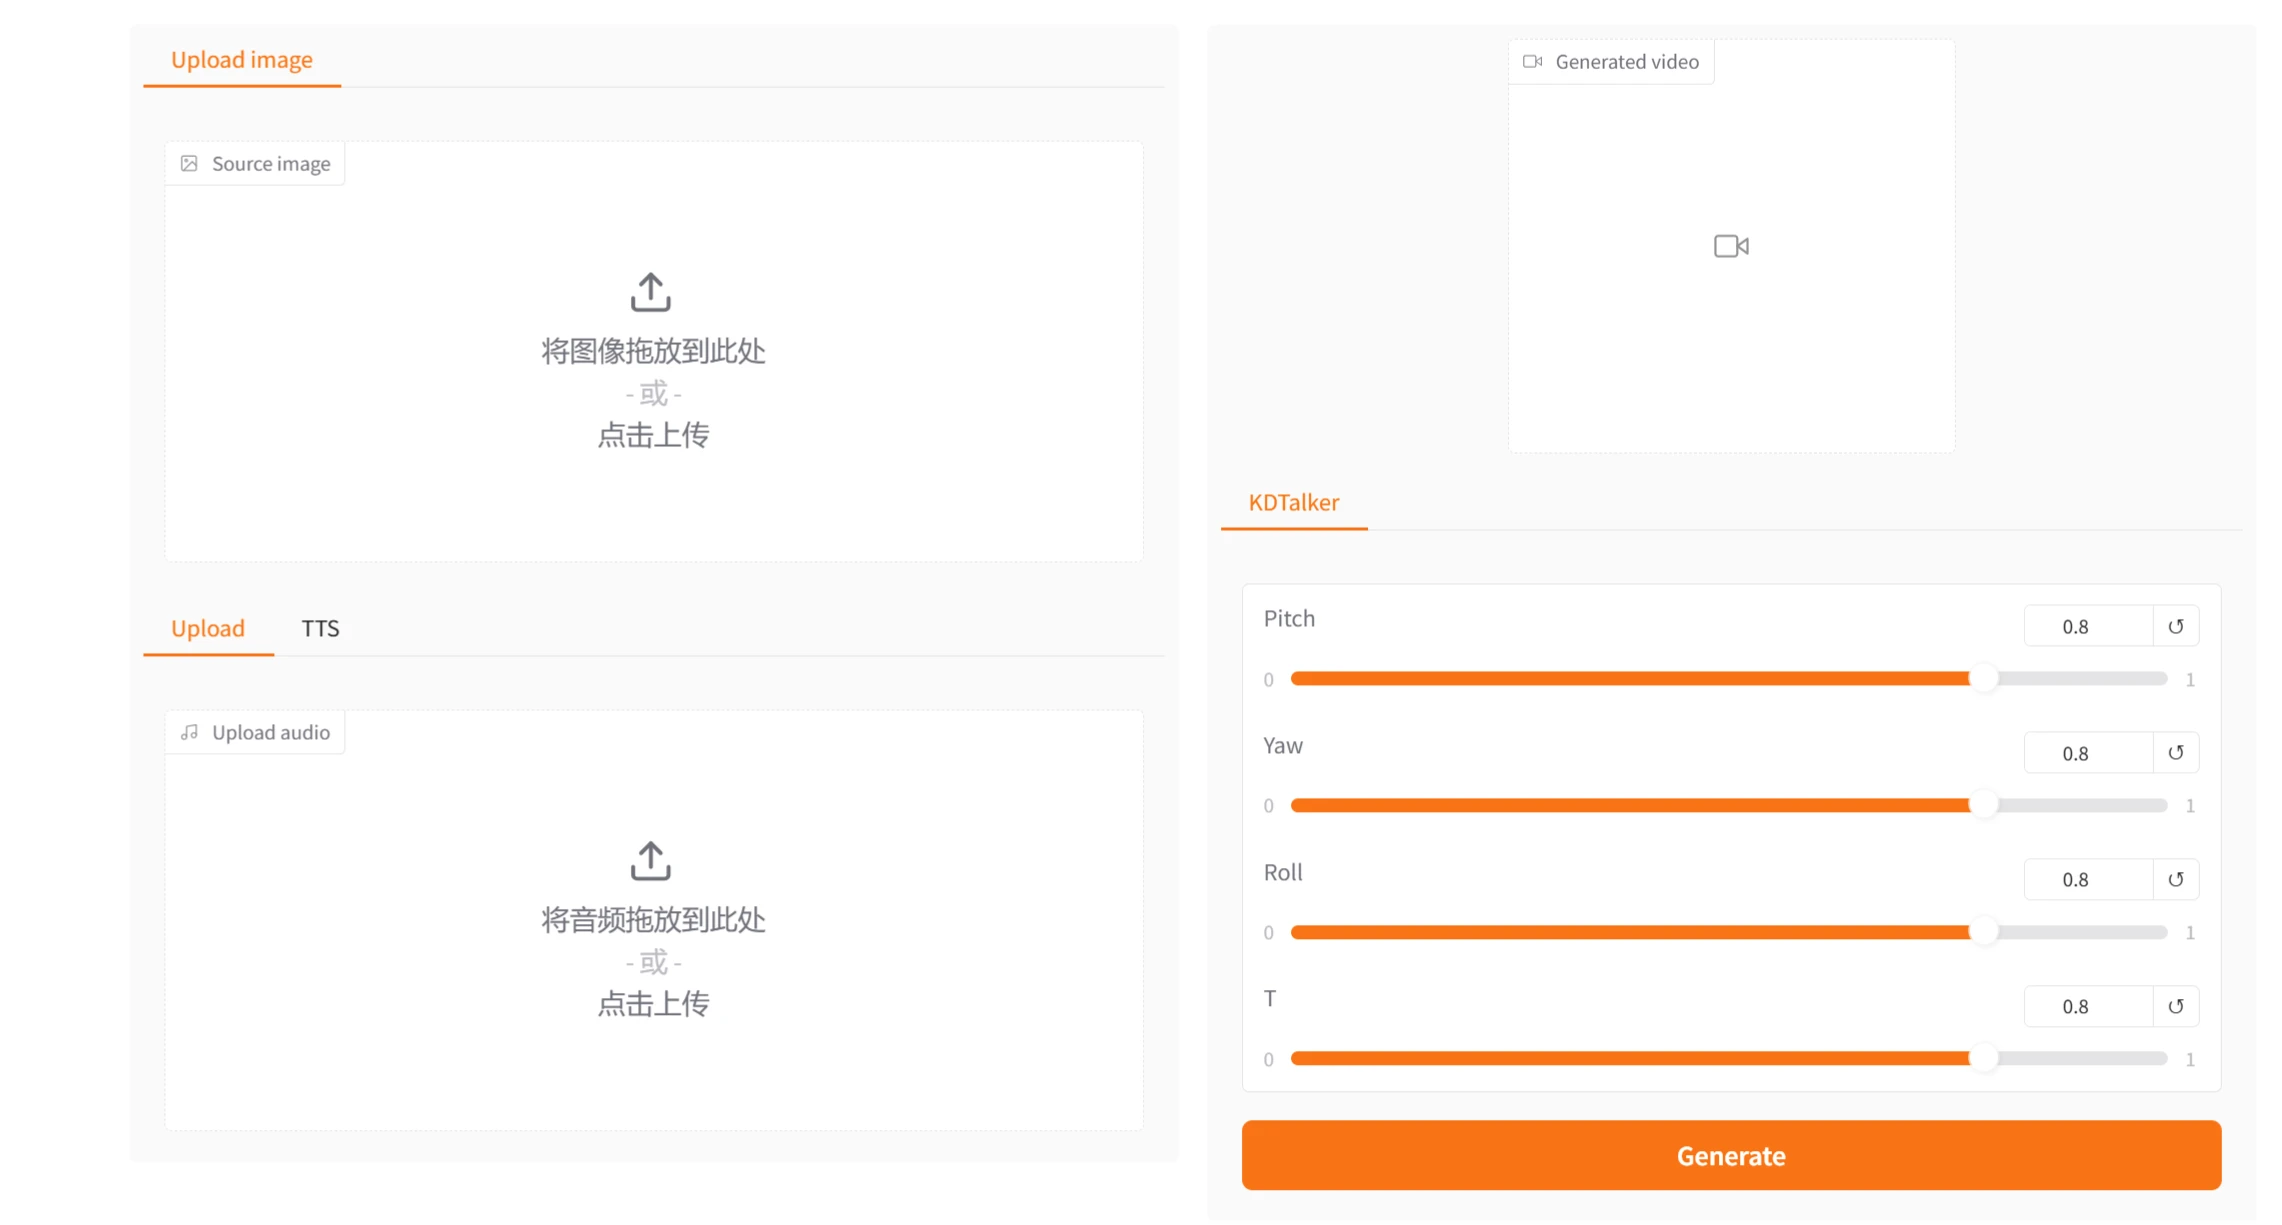
Características de KDTalker
Tecnología de puntos clave implícitos:
Utiliza puntos clave implícitos para captar los sutiles cambios en las expresiones y movimientos faciales, lo que permite reflejar de forma más natural la relación entre el audio y los movimientos faciales.
En comparación con los métodos tradicionales de puntos clave explícitos, los puntos clave implícitos evitan la complejidad y los errores asociados al etiquetado explícito.
Modelo de difusión espacio-temporal:
Combinado con un modelo de difusión espacio-temporal, genera efectos dinámicos más suaves y coherentes, manteniendo al mismo tiempo la calidad y la estabilidad de la imagen.
Gracias al modelo de difusión espacio-temporal, se gestiona mejor la continuidad temporal en las secuencias de vídeo.
Diversidad de posturas:
Admite la generación de múltiples posturas, capaz de ajustar dinámicamente la pose del personaje según el contenido del audio, aumentando la diversidad y naturalidad del resultado generado.
Los usuarios pueden especificar diferentes estilos de postura para generar retratos dinámicos más personalizados.
Alta eficiencia:
El diseño optimizado del modelo y el flujo de cálculo eficiente permiten que esta tecnología se ejecute en una sola tarjeta gráfica RTX4090 o RTX3090, con alta practicidad y escalabilidad.
Adecuada para su uso en dispositivos con recursos limitados, manteniendo al mismo tiempo una alta velocidad de generación.
Generación de alta calidad:
Los retratos dinámicos generados tienen alta resolución y realismo, capaces de satisfacer las necesidades de generación de vídeo de alta calidad.
Mediante modelos preentrenados y un flujo de inferencia optimizado, se garantiza la estabilidad y la coherencia de los resultados generados.
Escenarios de aplicación de KDTalker
Realidad virtual (VR) y realidad aumentada (AR):
En aplicaciones de VR y AR, KDTalker puede generar retratos dinámicos realistas de personajes virtuales, mejorando la experiencia del usuario.
Por ejemplo, en reuniones virtuales, los usuarios pueden generar sus propios retratos dinámicos impulsados por audio, haciendo que la comunicación remota sea más natural.
Redes sociales y creación de contenido en vídeo:
Los usuarios pueden introducir sus fotos y audio en KDTalker para generar vídeos de retratos dinámicos personalizados, ideales para compartir en redes sociales.
Los creadores de contenido pueden utilizar esta tecnología para generar contenido de vídeo atractivo, aumentando así el atractivo de sus vídeos.
Videoconferencias:
En las videoconferencias, una red inestable puede provocar cortes o imágenes borrosas en el vídeo. KDTalker puede generar retratos dinámicos fluidos impulsados por audio, manteniendo una buena calidad visual incluso en entornos de bajo ancho de banda.
Entretenimiento y juegos:
En aplicaciones de juegos y entretenimiento, KDTalker puede generar expresiones y movimientos dinámicos de personajes virtuales, mejorando la inmersión en el juego.
Por ejemplo, en juegos de rol, los jugadores pueden generar retratos dinámicos de sus personajes impulsados por audio.
Educación y formación:
En escenarios de educación y formación, KDTalker puede generar retratos dinámicos de profesores o formadores, para su uso en cursos online o vídeos de formación.
Los retratos dinámicos generados a partir del audio pueden hacer que el contenido educativo sea más vívido, mejorando así el aprendizaje.
Cómo usar KDTalker
1. Preparación del entorno
Requisitos de hardware: se recomienda utilizar una tarjeta gráfica RTX4090 o RTX3090.
Dependencias de software:
Instalar git, conda y FFmpeg.
Clonar el código y crear el entorno de Python:
git clone https://github.com/chaolongy/KDTalker
cd KDTalker
# 创建并激活conda环境
conda create -n KDTalker python=3.9
conda activate KDTalker
# 安装PyTorch和其他依赖
conda install pytorch==2.3.0 torchvision==0.18.0 torchaudio==2.3.0 pytorch-cuda=11.8 -c pytorch -c nvidia
pip install -r requirements.txt
2. Descargar los pesos preentrenados
Descarga los archivos de pesos preentrenados desde Google Drive o Hugging Face, y colócalos en los directorios ./pretrained_weights y ./ckpts.
Asegúrate de que la estructura de directorios sea la siguiente:
pretrained_weights
├── insightface
│   └── models
│       └── buffalo_l
│           ├── 2d106det.onnx
│           └── det_10g.onnx
└── liveportrait
    ├── base_models
    │   ├── appearance_feature_extractor.pth
    │   ├── motion_extractor.pth
    │   ├── spade_generator.pth
    │   └── warping_module.pth
    ├── landmark.onnx
    └── retargeting_models
        └── stitching_retargeting_module.pth
3. Ejecutar la inferencia
Utiliza el siguiente comando para ejecutar el script de inferencia y generar el vídeo de retrato dinámico:
python inference.py -source_image ./example/source_image/WDA_BenCardin1_000.png -driven_audio ./example/driven_audio/WDA_BenCardin1_000.wav -output ./results/output.mp4
-source_image: especifica la ruta de la imagen fuente de entrada.
-driven_audio: especifica la ruta del audio impulsor de entrada.
-output: especifica la ruta donde se guardará el vídeo de salida.
Dirección del proyecto: https://github.com/chaolongy/KDTalker
DEMO: https://kdtalker.com/









