
 Asistente de guiones▸
 Apps AI
 Noticias AI
Características, precios y casos de uso de los modelos de voz de OpenAI GPT-4o-transcribe, GPT-4o-mini-transcribe y GPT-4o-mini-tts
小编 ·

Características, precios y casos de uso de los modelos de voz de OpenAI GPT-4o-transcribe, GPT-4o-mini-transcribe y GPT-4o-mini-tts
Openai ha lanzado una nueva generación de modelos de voz que ofrecen a los desarrolladores capacidades de interacción por voz más potentes y permiten el desarrollo de agentes de voz inteligentes. Estos modelos incluyen dos modelos de voz a texto (gpt-4o-transcribe y gpt-4o-mini-transcribe) y un modelo de texto a voz (gpt-4o-mini-tts). ¿Cuáles son sus características respectivas?
1. GPT-4o-transcribe (modelo de voz a texto)
Características:
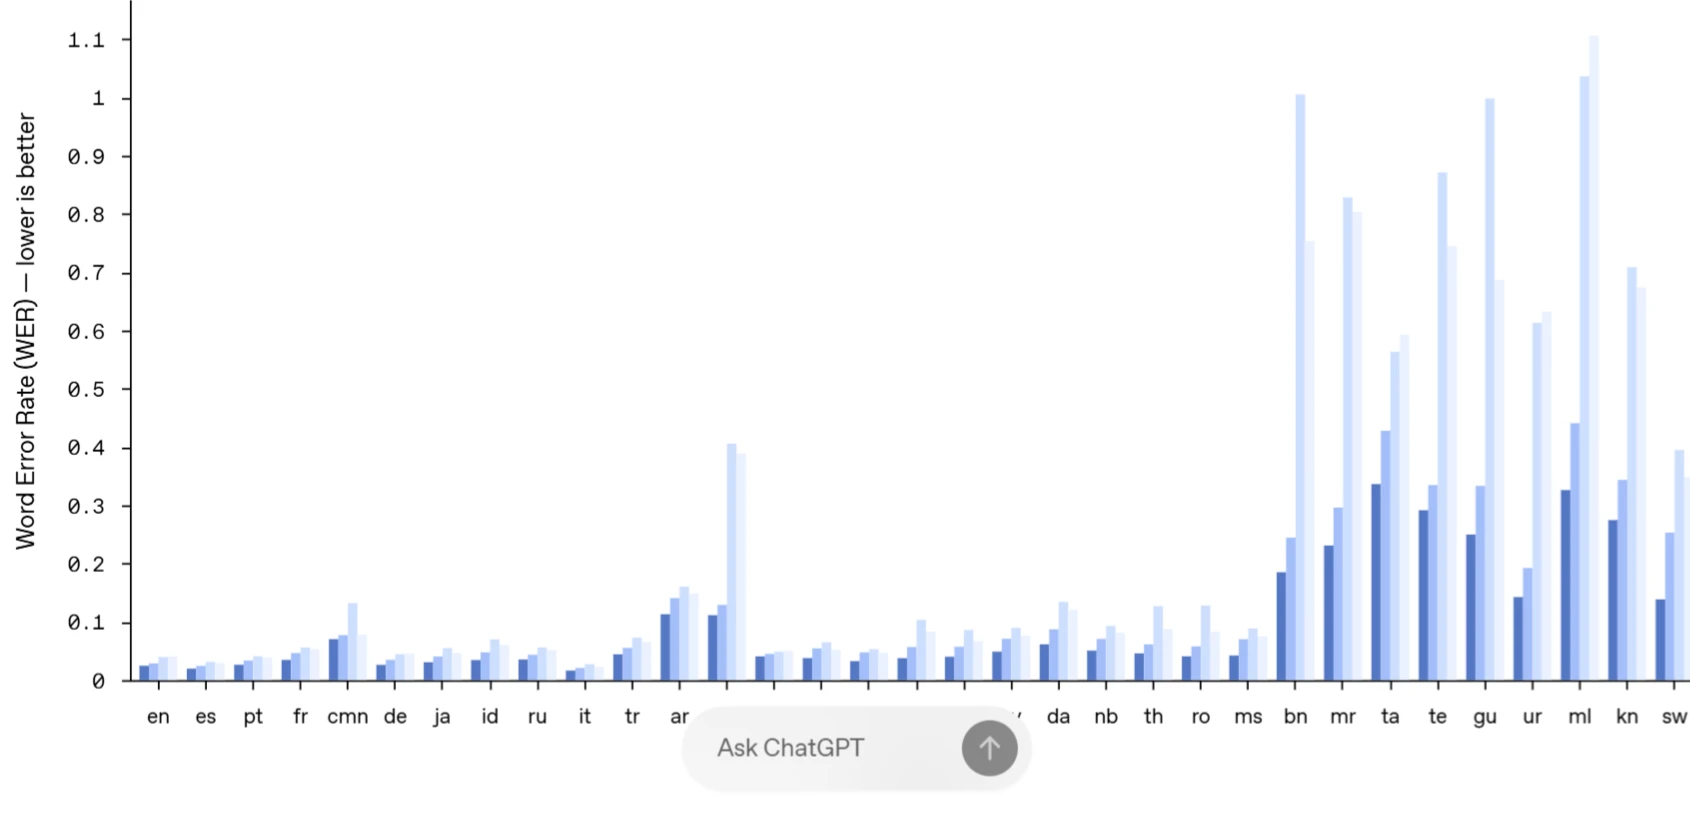
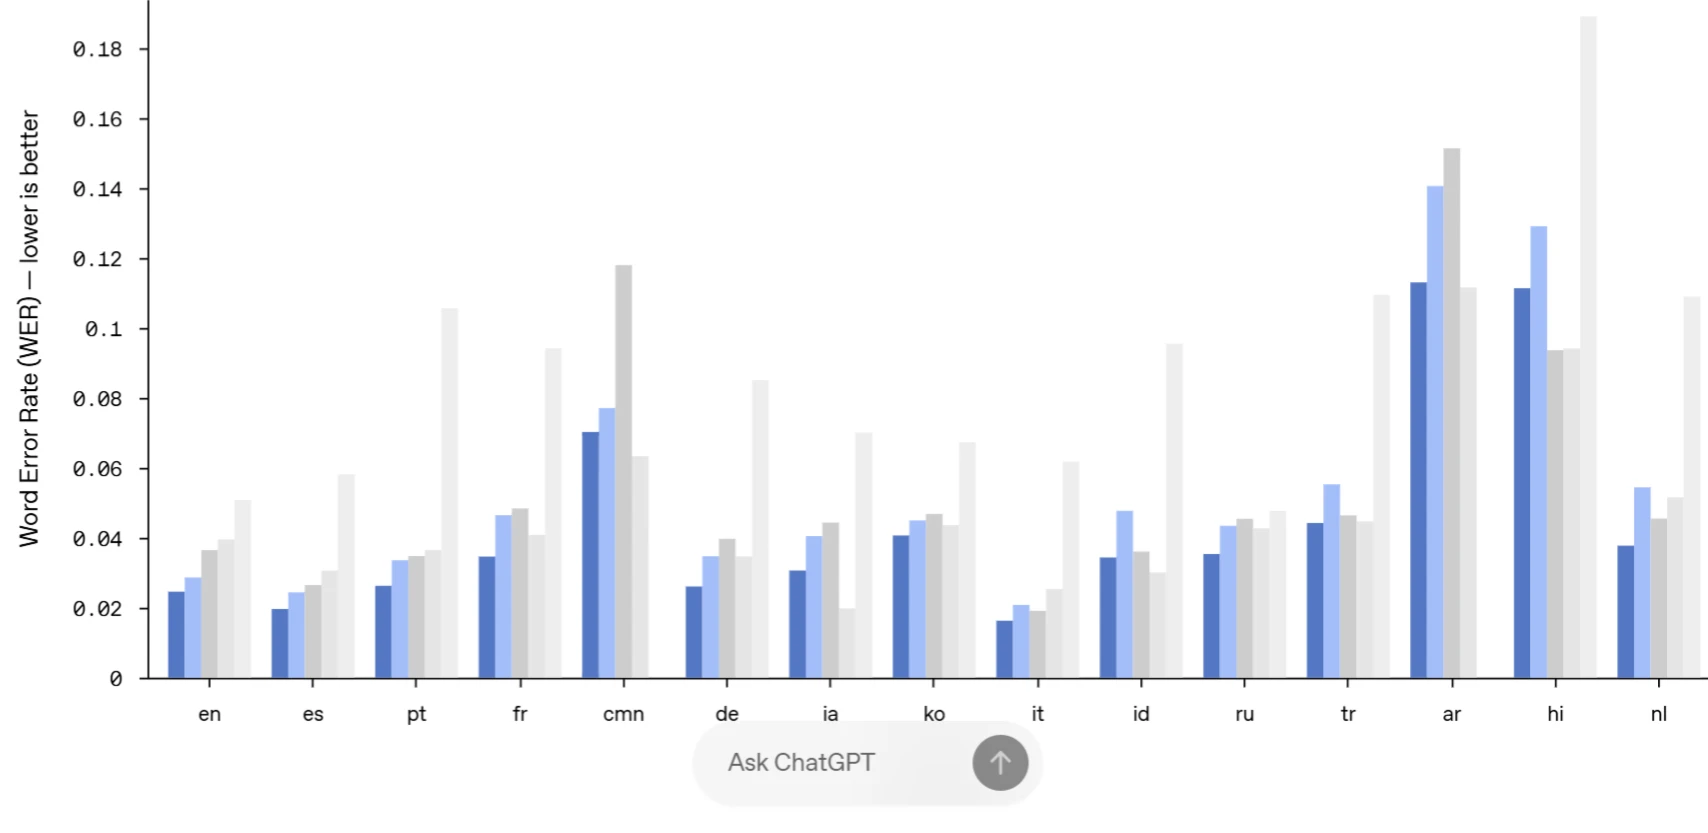
Transcripción de alta precisión: Tras un entrenamiento prolongado con grandes conjuntos de datos de audio diversos y de alta calidad, es capaz de captar mejor los matices del habla, reducir los reconocimientos erróneos y mejorar notablemente la fiabilidad de la transcripción.
Adaptación a escenarios complejos: Posee una gran adaptabilidad a acentos, velocidades de habla y ruido ambiental, e identifica y transcribe con precisión el contenido de voz incluso en entornos con mucho ruido de fondo, hablantes con acentos marcados o velocidades de habla rápidas.
Capacidad de procesamiento de voz larga: Es capaz de procesar entradas de voz prolongadas, lo que resulta adecuado para escenarios que requieren transcripción continua de voz durante largos periodos.
Escenarios de uso:
Actas de reuniones: Transcribe el contenido de voz de las reuniones a texto en tiempo real o posteriormente, facilitando la organización y revisión posterior y mejorando la eficiencia del trabajo.
Transcripción de entrevistas: En escenarios como entrevistas periodísticas o de personajes, transcribe rápida y con precisión el contenido de voz del entrevistado a texto, facilitando la edición y publicación posterior.
Notas de voz: Transcribe las notas de voz del usuario a texto, para que este pueda consultarlas y organizarlas en cualquier momento.
Centros de atención al cliente: Reconoce con precisión la voz del cliente y la transcribe a texto, facilitando que el personal de atención al cliente comprenda rápidamente las necesidades del cliente y las gestione adecuadamente.
Precios:
El precio es de $6.00 por cada millón de tokens de audio de entrada, aproximadamente $0.006 por minuto.
2. GPT-4o-mini-transcribe (versión精简 del modelo de voz a texto)
Características:
Eficiente y rápido: El modelo es más pequeño y la velocidad de procesamiento es mayor, capaz de completar tareas de transcripción de voz en poco tiempo.
Bajo consumo de recursos: Los requisitos de recursos de hardware son relativamente bajos, lo que lo hace adecuado para ejecutarse en dispositivos con recursos limitados.
Alta relación calidad-precio: Aunque la tasa de error de palabras (WER) es ligeramente superior a la del modelo completo, sigue siendo mejor que la del modelo Whisper original.
Escenarios de uso:
Entrada de voz en dispositivos móviles: En teléfonos inteligentes, tabletas y otros dispositivos móviles, ofrece a los usuarios una función rápida de transcripción de entrada de voz, como por ejemplo dictar mensajes de texto.
Aplicaciones de voz pequeñas: Adecuado para algunas aplicaciones de voz pequeñas que no requieren una precisión de transcripción especialmente alta pero necesitan una respuesta rápida, como el reconocimiento de comandos de voz o notas de voz sencillas.
Entornos con recursos limitados: En escenarios con recursos computacionales limitados, como proyectos de pequeñas empresas o desarrolladores individuales, ofrece una solución de transcripción de voz eficiente y de bajo coste.
Precios:
El precio es de $3.00 por cada millón de tokens de audio de entrada, aproximadamente $0.003 por minuto.
3. GPT-4o-mini-tts (modelo de texto a voz)
Características:
Guidance (Orientabilidad): Por primera vez es compatible con la "orientabilidad", lo que permite a los desarrolladores no solo especificar "qué decir" al modelo, sino también controlar "cómo decirlo". Por ejemplo, se puede preestablecer el estilo de voz como "tranquilo", "surfista", "profesional", "caballero medieval", etc., y también ajustar el estilo de voz mediante instrucciones, como "habla como un agente de atención al cliente empático".
Voz natural y fluida: La voz generada es natural, fluida y expresiva, capaz de realizar la expresión vocal correspondiente según el contenido del texto y el estilo preestablecido.
Soporte multilingüe: Admite texto a voz en múltiples idiomas, satisfaciendo las necesidades de usuarios de distintos idiomas.
Escenarios de uso:
Audiolibros: Convierte libros de texto, artículos, etc., en contenido audible, ofreciendo a los usuarios una experiencia de lectura más vívida e interesante.
Atención al cliente inteligente: Proporciona funciones de síntesis de voz para sistemas de atención al cliente inteligente, permitiendo que los robots de atención al cliente se comuniquen con los usuarios con una voz natural y expresiva, mejorando la experiencia del usuario.
Locución de voz: En escenarios como locución de noticias, pronósticos meteorológicos o boletines de tráfico, convierte el contenido de texto en voz para su difusión.
Creación de contenido creativo: En áreas como la narración creativa de historias, la producción publicitaria, el doblaje de vídeos, etc., genera voz con estilos y emociones específicas según las diferentes necesidades creativas.
Precios:
El precio es de $0.60 por cada millón de tokens de texto de entrada y de $12.00 por cada millón de tokens de audio de salida, aproximadamente $0.015 por minuto.
Modelos como GPT-4o-transcribe ya están disponibles para los desarrolladores a través de la interfaz API de OpenAI, y su integración en aplicaciones resulta muy cómoda, requiriendo solo unas pocas líneas de código. Los desarrolladores pueden elegir el modelo que mejor se adapte a sus necesidades en función de la funcionalidad y el entorno, y también pueden probarlo en el sitio web oficial.
Sitio web oficial:http://open ai.fm/
Blog:https://openai.com/index/introducing-our-next-generation-audio-models/









