
 Asistente de guiones▸
 Apps AI
 Noticias AI
OpenAI lanzó tres nuevos modelos de voz: dos de voz a texto y uno de texto a voz
小编 ·

OpenAI lanzó tres nuevos modelos de voz: dos de voz a texto y uno de texto a voz
El 20 de marzo de 2025, OpenAI lanzó tres nuevos modelos de voz, incluidos dos modelos de conversión de voz a texto (GPT-4o-transcribe y GPT-4o-mini-transcribe) y un modelo de texto a voz (GPT-4o-mini-tts).
Modelos de conversión de voz a texto
GPT-4o-transcribe: Este modelo ha sido entrenado durante largo tiempo con conjuntos de datos de audio diversificados y de alta calidad, lo que le permite captar mejor los matices del habla, reducir los errores de reconocimiento y mejorar significativamente la fiabilidad de la transcripción. Es adecuado para escenarios complejos como centros de atención al cliente y transcripción de actas de reuniones, donde se enfrentan acentos diversos, entornos ruidosos y variaciones en la velocidad del habla.
GPT-4o-mini-transcribe: Esta es una versión reducida de GPT-4o-transcribe, con mayor velocidad y eficiencia. Aunque su tasa de error por palabra (WER) es ligeramente superior a la del modelo completo, sigue siendo mejor que la del modelo Whisper original, lo que lo hace más adecuado para escenarios de aplicación con recursos limitados que requieren reconocimiento de voz de alta calidad.
Modelo de texto a voz
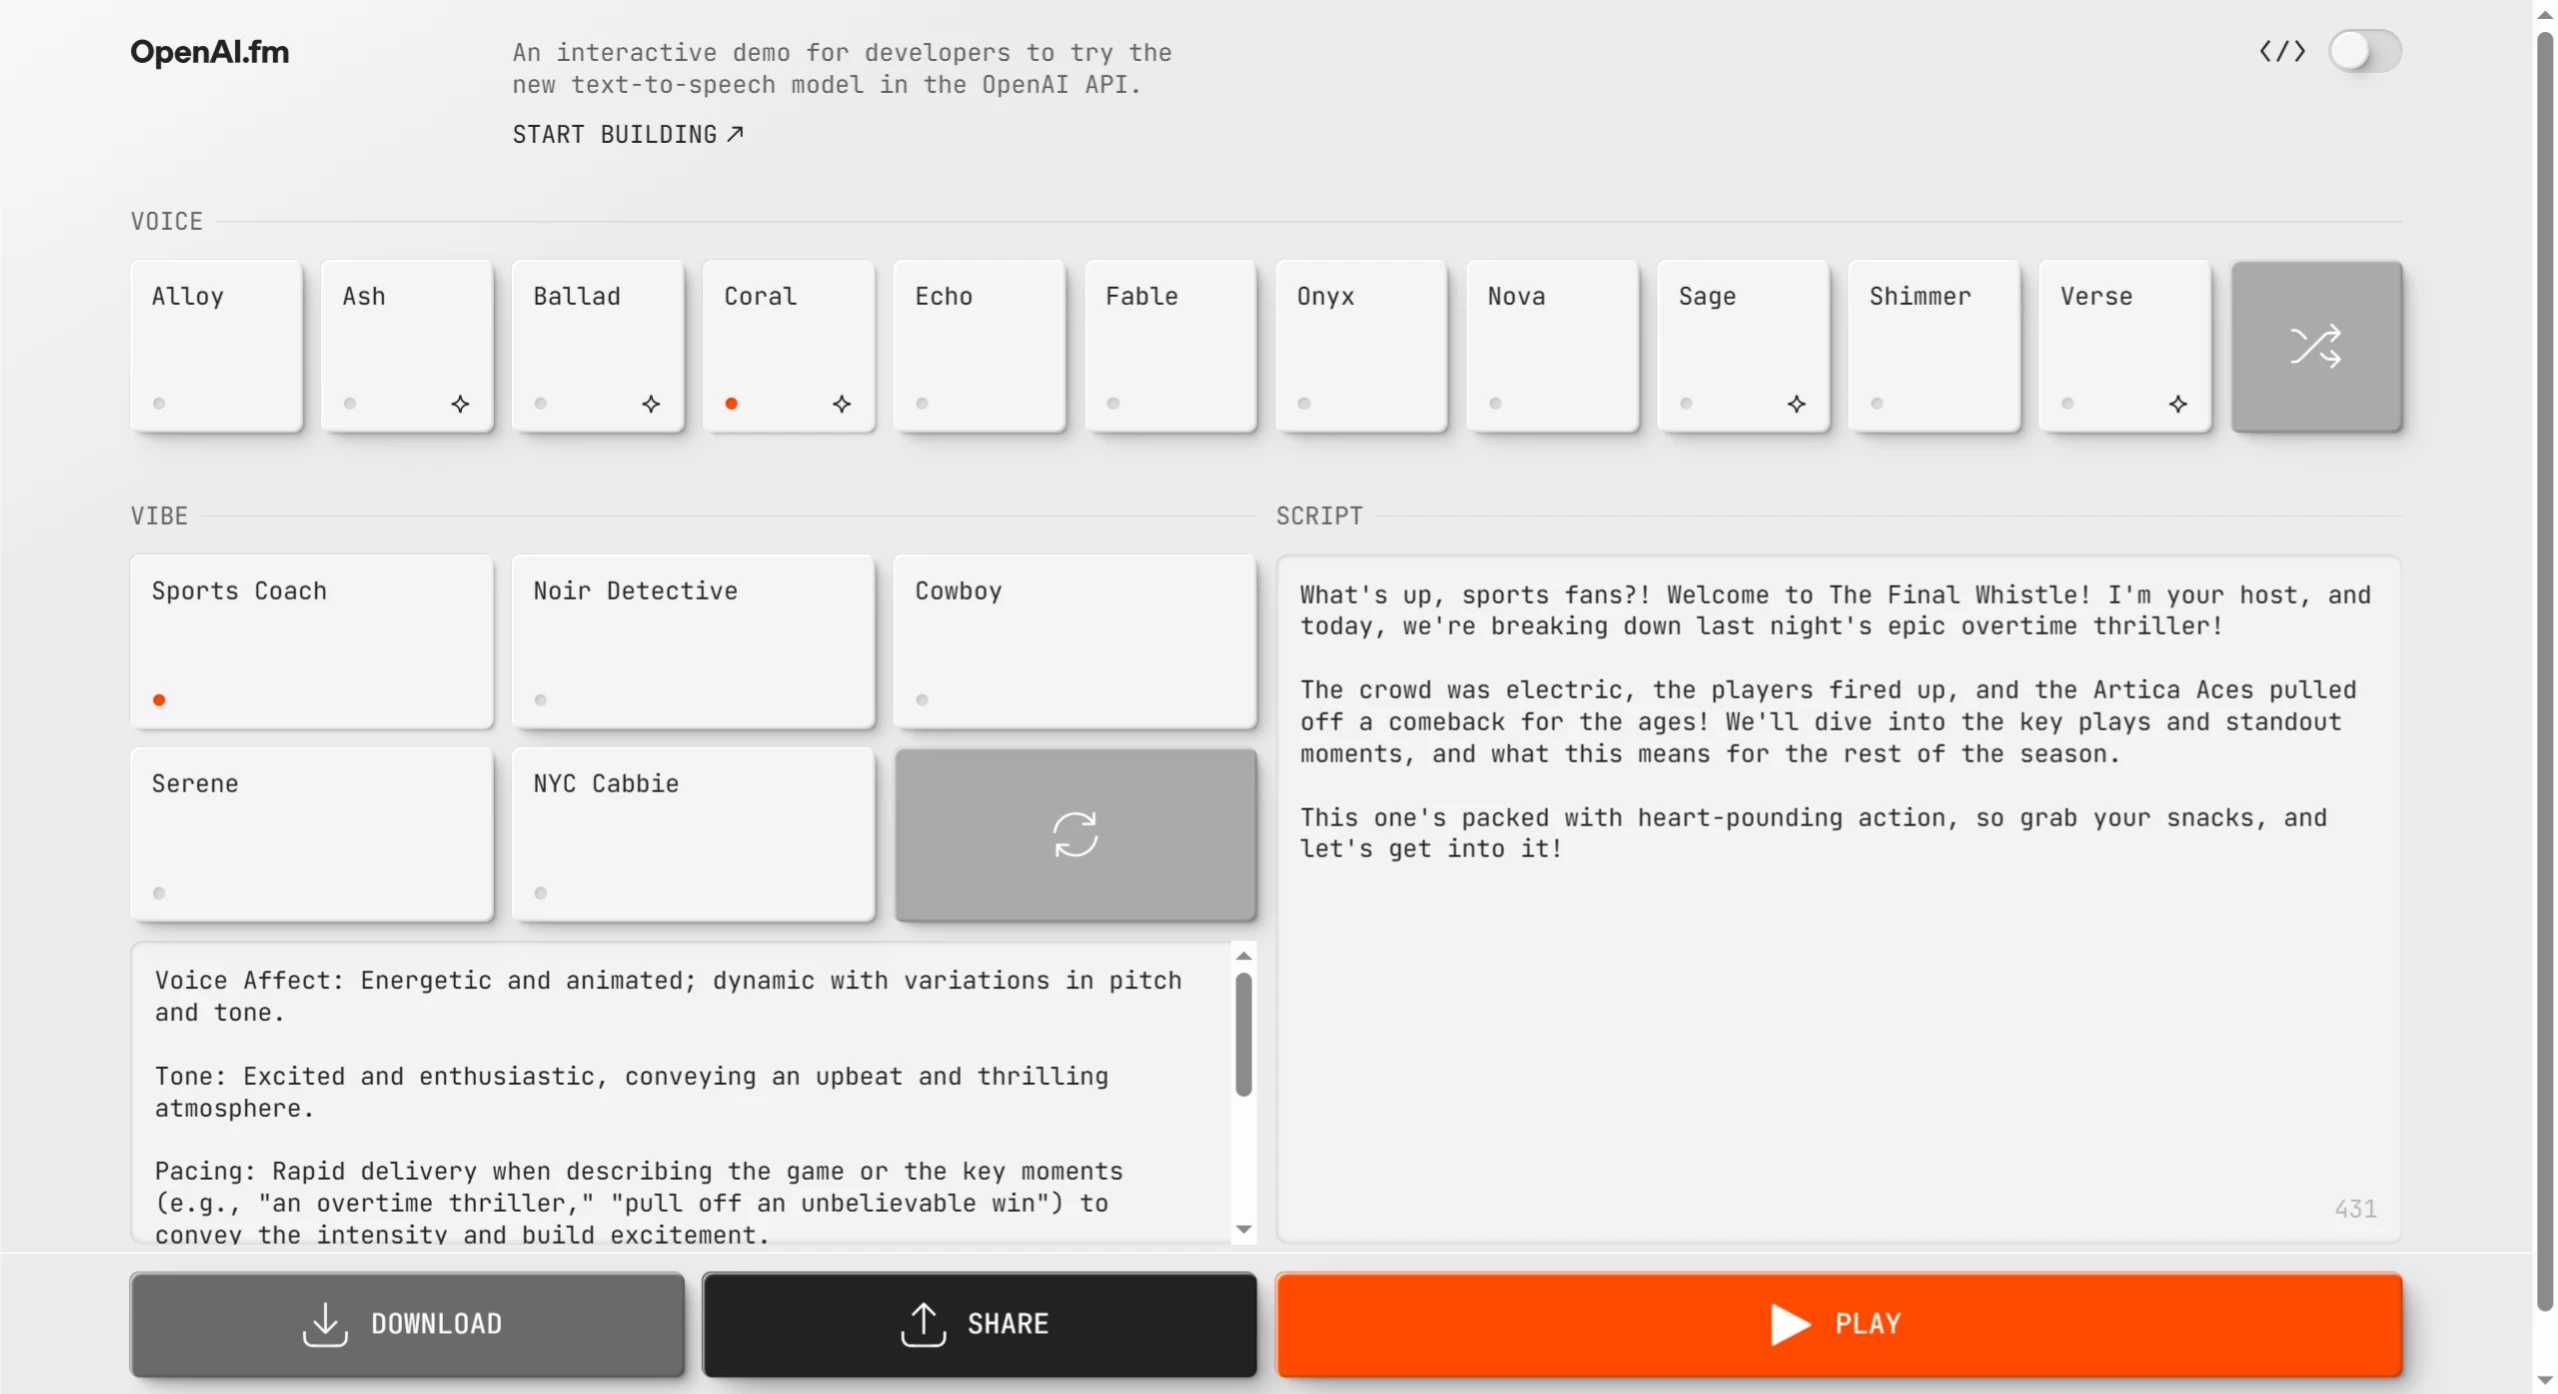
GPT-4o-mini-tts: Este modelo incorpora por primera vez la "guiabilidad" (steerability), lo que permite a los desarrolladores no solo especificar "qué decir" al modelo, sino también controlar "cómo decirlo". Por ejemplo, pueden preestablecer estilos de voz como "tranquilo", "surfista", "profesional" o "caballero medieval", y también ajustar el estilo de voz según las instrucciones, como "habla como un agente de atención al cliente empático".
Innovaciones técnicas
Preentrenamiento con conjuntos de datos de audio reales para optimizar el rendimiento del modelo.
Métodos de destilación mejorados para lograr la transferencia de conocimiento del modelo grande al modelo pequeño.
Aprendizaje por refuerzo para mejorar la precisión de la transcripción y reducir las "alucinaciones".
Escenarios de aplicación
Centros de atención al cliente: proporcionan reconocimiento de voz más preciso y síntesis de voz más natural, mejorando la experiencia del servicio al cliente.
Actas de reuniones: transcriben rápida y con precisión el contenido de voz de las reuniones a texto.
Atención al cliente personalizada: ofrece experiencias de voz más cálidas y expresivas mediante la personalización del estilo de voz.
Narración creativa de historias: añade efectos de voz vívidos a las historias.
Precios
El precio de GPT-4o-transcribe es el mismo que el del modelo Whisper anterior, 0.006 dólares por minuto.
El precio de GPT-4o-mini-transcribe es de 0.003 dólares por minuto.
El precio de GPT-4o-mini-tts es de 1 centavo por minuto.
Sitio web de los modelos de voz de OpenAI: OpenAI.fm, donde se ofrecen abundantes plantillas preestablecidas, incluidos ajustes de personalidad, tono, dialecto y pronunciación. Los usuarios pueden probar y crear aquí audios relacionados con GPT-4o-mini-tts. Además, OpenAI también ofrece una versión mejorada del Agent SDK, que ayuda a los desarrolladores a construir agentes de voz de manera más cómoda.
Sitio web oficial:http://openai.fm/
Blog oficial:https://openai.com/index/introducing-our-next-generation-audio-models/









