
 Asistente de guiones▸
 Apps AI
 Noticias AI
Chitu: framework de inferencia LLM de alto rendimiento de código abierto del equipo de Tsinghua
小编 ·

Chitu: framework de inferencia LLM de alto rendimiento de código abierto del equipo de Tsinghua
¿Qué es 赤兔 (Chitu)?
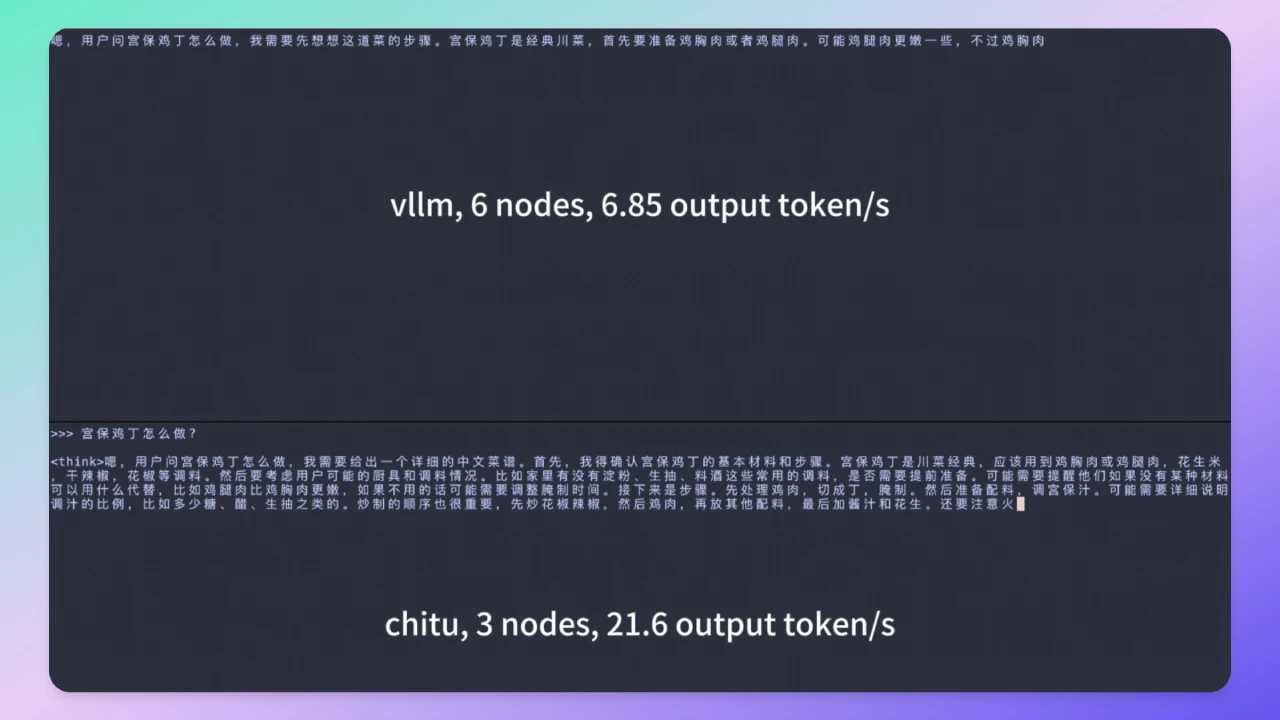
赤兔 (Chitu) es un framework de inferencia de modelos de lenguaje de gran tamaño (LLM) de alto rendimiento, de código abierto, desarrollado por el equipo de la Universidad de Tsinghua. Está enfocado en mejorar la eficiencia de la inferencia, reducir costes y soportar múltiples plataformas de hardware y escenarios de despliegue. Permite reducir a la mitad el coste de inferencia de DeepSeek y duplicar su rendimiento. El objetivo de 赤兔 (Chitu) es proporcionar a empresas y desarrolladores un motor de inferencia eficiente, flexible y fácil de desplegar, acelerando la implementación práctica de los modelos de lenguaje de gran tamaño (LLM).
Características y funcionalidades de 赤兔 (Chitu)
Adaptación a múltiples capacidades de cómputo: soporta múltiples productos de NVIDIA, desde los últimos modelos insignia hasta los más antiguos, y ofrece soporte optimizado para chips nacionales.
Escalabilidad para todos los escenarios: desde despliegue solo con CPU, un único GPU hasta clusters a gran escala, proporcionando soluciones escalables y flexibles.
Funcionamiento estable a largo plazo: apto para entornos de producción reales, capaz de soportar de forma estable tráfico de negocio concurrente.
Alto rendimiento de inferencia: en pruebas con cluster A800, en comparación con algunos frameworks extranjeros de código abierto, se logra una reducción del 50% en el uso de GPU mientras la velocidad de inferencia se multiplica por 3,15.
Reducción de costes: mediante la optimización del uso de recursos de hardware, se reduce la barrera y el coste de despliegue de modelos de ai para las empresas.
Casos de uso de 赤兔 (Chitu)
Aplicaciones de IA a nivel empresarial: servicios de inferencia que requieren alto rendimiento, baja latencia y alto rendimiento (throughput).
Despliegue en clusters a gran escala: escenarios que requieren un funcionamiento eficiente en entornos con múltiples GPU o múltiples nodos.
Entornos con recursos limitados: escenarios en los que se necesita realizar inferencia eficiente con recursos de hardware limitados.
Adaptación a chips nacionales: escenarios en los que se necesita ejecutar modelos de lenguaje de gran tamaño sobre plataformas de hardware nacionales.
Cómo usar 赤兔 (Chitu)
1. Instalación desde el código fuente
git clone --recursive https://github.com/thu-pacman/chitu && cd chitu
pip install -r requirements-build.txt
pip install -U torch --index-url https://download.pytorch.org/whl/cu124  # 根据 CUDA 版本调整
TORCH_CUDA_ARCH_LIST=8.6 CHITU_SETUP_JOBS=4 MAX_JOBS=4 pip install --no-build-isolation
2. Inferencia con un único GPU
torchrun --nproc_per_node 8 test/single_req_test.py request.max_new_tokens=64 models=DeepSeek-R1 models.ckpt_dir=/data/DeepSeek-R1 infer.pp_size=1 infer.tp_size=8
3. Paralelismo híbrido (TP+PP)
torchrun --nnodes 2 --nproc_per_node 8 test/single_req_test.py request.max_new_tokens=64 infer.pp_size=2 infer.tp_size=8 models=DeepSeek-R1 models.ckpt_dir=/data/DeepSeek-R1
4. Iniciar el servicio
export WORLD_SIZE=8
torchrun --nnodes 1 \
--nproc_per_node 8 \
--master_port=22525 \
example/serve.py \
serve.port=21002 \
infer.stop_with_eos=False \
infer.cache_type=paged \
infer.pp_size=1 \
infer.tp_size=8 \
models=DeepSeek-R1 \
models.ckpt_dir=/data/DeepSeek-R1 \
keep_dtype_in_checkpoint=True \
infer.mla_absorb=absorb-without-precomp \
infer.soft_fp8=True \
infer.do_load=True \
infer.max_reqs=1 \
scheduler.prefill_first.num_tasks=100 \
infer.max_seq_len=4096 \
request.max_new_tokens=100 \
infer.use_cuda_graph=True
5. Pruebas de rendimiento
python benchmarks/benchmark_serving.py \
--model "deepseek-r1" \
--iterations 10 \
--seq-len 10 \
--warmup 3 \
--base-url http://localhost:21002
Repositorio en GitHub:https://github.com/thu-pacman/chitu









