
 Asistente de guiones▸
 Apps AI
 Noticias AI
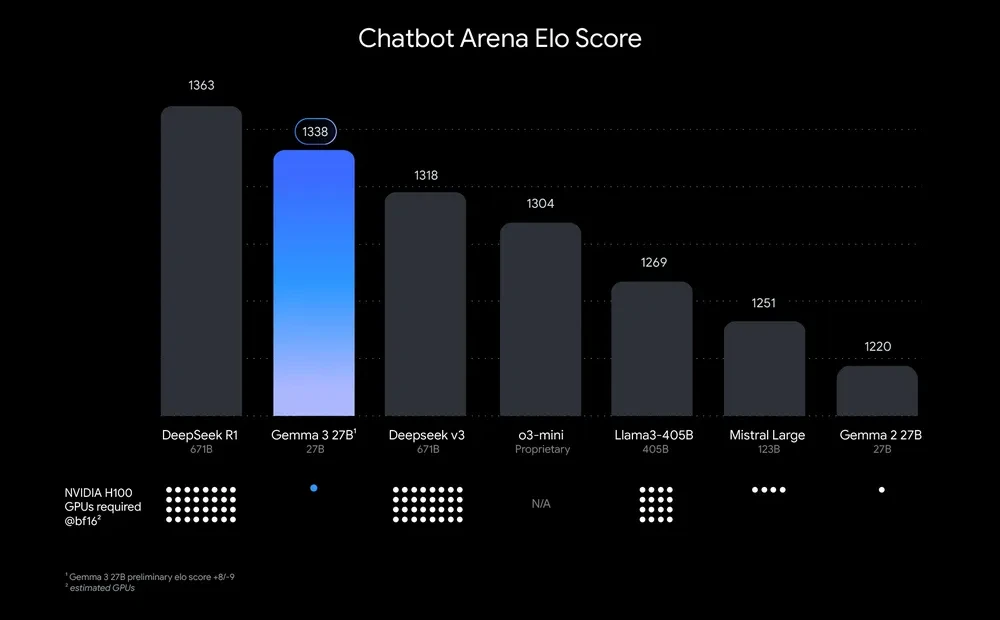
Google lanza Gemma 3: supera a DeepSeek V3 y o3-mini y se convierte en el segundo mejor modelo open del mundo
小编 ·

Google lanza Gemma 3: supera a DeepSeek V3 y o3-mini y se convierte en el segundo mejor modelo open del mundo
¿Qué es Gemma 3?
Gemma 3 es el último modelo de código abierto publicado por Google, que supera a DeepSeek V3 y o3mini, convirtiéndose en el segundo modelo de código abierto más potente del mundo. Gemma 3 cuenta con sólidas capacidades multimodales, capaces de comprender texto, imágenes y vídeos cortos, y además ofrece preentrenamiento en más de 140 idiomas, con soporte directo para más de 35 idiomas. Dispone de una ventana de contexto de 128K tokens, lo que le permite procesar grandes volúmenes de información, y admite llamadas a funciones y desarrollo de agentes de ia, posibilitando la automatización de tareas complejas. Gemma 3 ofrece cuatro modelos de diferentes tamaños (1B, 4B, 12B y 27B) para satisfacer distintas necesidades de hardware y rendimiento, y puede ejecutarse de forma eficiente en una amplia variedad de dispositivos, desde teléfonos móviles hasta ordenadores, admitiendo un despliegue que abarca desde dispositivos móviles hasta estaciones de trabajo.
Características de Gemma 3
Capacidad multimodal: admite entradas combinadas de texto, imágenes y vídeos cortos, capaz de manejar tareas multimodales complejas.
Amplio soporte de idiomas: preentrenamiento en más de 140 idiomas, con soporte directo para más de 35 idiomas.
Gran ventana de contexto: admite una ventana de contexto de 128k tokens, capaz de procesar grandes volúmenes de información, como 30 imágenes de alta resolución o 1 hora de vídeo.
Alto rendimiento: supera a otros modelos de su categoría, como Llama, DeepSeek y el o3-mini de OpenAI, en una sola GPU o TPU.
Optimización y cuantificación: ofrece versiones cuantificadas oficiales que reducen el tamaño del modelo y los requisitos computacionales, manteniendo una alta precisión.
Seguridad: incorpora el clasificador de seguridad de imágenes ShieldGemma 2, capaz de detectar y etiquetar contenido peligroso.
Características de los cuatro tamaños de modelo de Gemma 3
1B: ligero, adecuado para ejecutarse en dispositivos con recursos limitados, como teléfonos móviles o portátiles.
4B: ideal para tareas multimodales, con mayor capacidad de procesamiento de imágenes y texto.
12B: mayor rendimiento, adecuado para análisis complejos de imágenes y vídeo.
27B: la versión más grande, con el rendimiento más alto, adecuada para escenarios de computación de alto rendimiento.
Casos de uso de Gemma 3
Procesamiento de lenguaje natural: utilizado en chatbots, asistentes inteligentes, clasificación de texto, análisis de sentimiento y traducción automática.
Reconocimiento y análisis de imágenes: admite reconocimiento facial, detección de objetos, preguntas y respuestas sobre imágenes, y comparación de imágenes.
Análisis de vídeo: capaz de procesar contenido de vídeo corto, aplicable al análisis y generación de contenido de vídeo.
Atención al cliente inteligente: combina entradas multimodales para ofrecer un servicio de atención al cliente más inteligente.
Control de calidad industrial: utiliza la capacidad de análisis de imágenes para detectar problemas de calidad en los productos.
Generación de código y asistencia en programación: admite la generación de código y la reparación automática de código.
Cómo usar Gemma 3
Experimentación rápida: utiliza Gemma 3 directamente en el navegador a través de Google AI Studio, sin necesidad de configuración.
Descarga y ajuste fino: descarga el modelo desde Hugging Face, Ollama o Kaggle, y ajústalo utilizando Hugging Face Transformers u otras herramientas.
Opciones de despliegue: admite múltiples formas de despliegue, incluyendo Vertex AI, Cloud Run, la API de Google GenAI, entornos locales y GPUs NVIDIA.
Soporte de herramientas de desarrollo: compatible con diversas herramientas de desarrollo como Hugging Face Transformers, Ollama, JAX, Keras, PyTorch, entre otras.
Tecnología de Gemma 3
Arquitectura base: basada en la misma arquitectura técnica que Gemini.
Entrenamiento y optimización: emplea técnicas como destilación de conocimiento, aprendizaje por refuerzo (incluyendo retroalimentación humana y de máquina) y fusión de modelos para mejorar el rendimiento.
Procesamiento visual: utiliza tecnología de segmentación dinámica de imágenes y una solución combinada de muestreo de fotogramas y análisis de flujo óptico, admitiendo imágenes de alta resolución y no cuadradas.
Optimización de hardware: profundamente optimizado para GPUs NVIDIA y TPUs de Google Cloud, garantizando una ejecución eficiente.
¿Qué mejoras tiene Gemma 3 respecto a Gemma 2?
Capacidad multimodal: nuevo soporte para entradas combinadas de texto, imágenes y vídeos cortos, capaz de manejar tareas complejas como preguntas y respuestas sobre imágenes y análisis de vídeo.
Mejora de rendimiento: mayor rendimiento en una sola GPU, con un aumento del 47% en la velocidad de inferencia.
Soporte de idiomas: preentrenamiento en más de 140 idiomas, con soporte directo para 35 idiomas, mejorando la capacidad de procesamiento lingüístico.
Ampliación de la ventana de contexto: admite 128k tokens, capaz de procesar información a mayor escala.
Capacidad de procesamiento visual: admite análisis de imágenes de alta resolución y vídeo, reduciendo a 20 segundos el tiempo de extracción de fotogramas clave de 1 hora de vídeo.
Mayor seguridad: incorpora el clasificador de seguridad de imágenes ShieldGemma 2, capaz de detectar contenido peligroso.
Optimización de hardware: profundamente optimizado para GPUs y TPUs, admitiendo múltiples opciones de despliegue.
Entrenamiento y ajuste fino: emplea técnicas como aprendizaje por refuerzo y ofrece herramientas de ajuste fino más flexibles.
Lectura detallada:https://blog.google/technology/developers/gemma-3/









