
 Asistente de guiones▸
 Apps AI
 Noticias AI
OpenManus-RL: Proyecto de código abierto para mejorar el razonamiento y la toma de decisiones de agentes LLM
小编 ·

OpenManus-RL: Proyecto de código abierto para mejorar el razonamiento y la toma de decisiones de agentes LLM
¿Qué es OpenManus-RL?
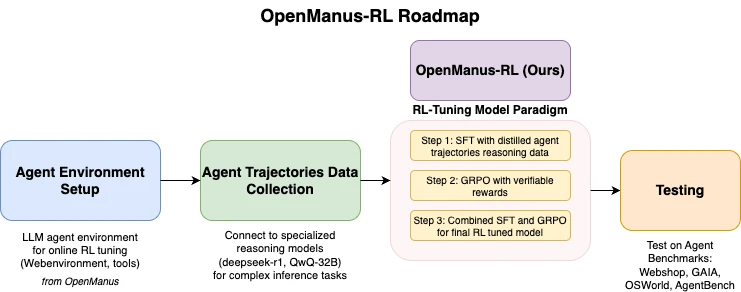
OpenManus-RL es un proyecto de código abierto desarrollado conjuntamente por UIUC-Ulab y el equipo de MetaGPT de la comunidad OpenManus, que mejora las capacidades de razonamiento y toma de decisiones de los agentes de modelos de lenguaje grandes (LLM) mediante la tecnología de aprendizaje por refuerzo (RL). El proyecto se basa en las experiencias de modelos avanzados como Deepseek-R1 y QwQ-32B, explorando nuevos métodos de ajuste para mejorar el rendimiento de los agentes en tareas complejas. Las funcionalidades principales de OpenManus-RL incluyen la construcción de entornos para agentes, la recopilación de datos de trayectorias, el soporte para el ajuste por aprendizaje por refuerzo y la integración de pruebas de referencia. También integra múltiples estrategias de aprendizaje por refuerzo, como Tree-of-Thoughts y Monte Carlo Tree Search, para mejorar la capacidad de razonamiento de los agentes.
Características de OpenManus-RL
Construcción del entorno del agente: proporciona herramientas de configuración del entorno del agente para el ajuste por aprendizaje por refuerzo (RL) en línea, lo que permite a los usuarios personalizar el entorno del agente para tareas específicas.
Recopilación de datos de trayectorias: capaz de conectarse a modelos como Deepseek-R1 y QwQ-32B, recopilando datos de comportamiento en tareas complejas para proporcionar soporte de datos para el ajuste posterior.
Soporte para ajuste por RL: admite métodos de aprendizaje por refuerzo para personalizar el comportamiento del agente, permitiendo a los usuarios optimizar el comportamiento del agente especificando funciones de recompensa, entre otras formas.
Integración de pruebas de referencia: incorpora entornos de prueba como WebShop, GaiA, OSWorld y AgentBench, lo que facilita a los usuarios la evaluación cuantitativa del rendimiento de los agentes.
Estrategias diversificadas: integra estrategias de aprendizaje por refuerzo como Tree-of-Thoughts y Monte Carlo Tree Search, mejorando la capacidad de razonamiento de los agentes en tareas de planificación a largo plazo.
Colaboración comunitaria: permite a los usuarios enviar código, conjuntos de datos, etc., y los contribuyentes importantes pueden convertirse en coautores de artículos, promoviendo el desarrollo conjunto de la comunidad.
Compartir el progreso en tiempo real: muestra dinámicamente el proceso y los resultados del ajuste por RL, lo que facilita a los usuarios conocer los últimos avances del proyecto.
Escenarios de aplicación de OpenManus-RL
Decisiones de compra: mediante la personalización del entorno del agente, se optimiza el rendimiento del agente en tareas de decisiones de compra, por ejemplo, mejorando la tasa de éxito de compra en WebShop.
Análisis de tareas complejas: analizar el rendimiento de los agentes en tareas complejas, como la tasa de éxito, el tiempo de respuesta y otros indicadores en pruebas de referencia como GAIA y OSWorld, ayudando a los desarrolladores a comparar el rendimiento de los modelos.
Optimización de tareas multimodales: en entornos de tareas multimodales como OSWorld, optimizar el comportamiento del agente para mejorar su rendimiento en tareas multimodales.
Tareas de planificación a largo plazo: utilizando estrategias diversificadas integradas, mejorar la capacidad de razonamiento del agente en tareas de planificación a largo plazo, por ejemplo, optimizando el comportamiento del agente mediante la estrategia Tree-of-Thoughts.
Instalación deOpenManus-RL
1. Crear un entorno Conda: para evitar conflictos de dependencias, se recomienda utilizar Conda para crear el entorno, con los siguientes comandos:
conda create -n openmanus-rl python=3.10
conda activate openmanus-rl
2. Clonar el proyecto: asegúrese de que Git esté instalado, luego clone el proyecto y acceda al directorio del proyecto con los siguientes comandos:
git clone https://github.com/OpenManus/OpenManus-RL.git
cd OpenManus-RL
3. Instalar dependencias: ejecute los siguientes comandos en el directorio raíz del proyecto para instalar las dependencias. Si la descarga es lenta, puede utilizar un espejo nacional:
pip install -r requirements.txt
o
pip install -r requirements.txt -i https://pypi.tuna.tsinghua.edu.cn/simple
Las herramientas de visualización requieren una instalación adicional:
pip install matplotlib numpy
4. Configurar el modelo y el conjunto de datos:
Ajuste fino supervisado (SFT): especifique el modelo y el conjunto de datos, con los siguientes comandos:
python -m openmanus_rl.sft --model_name_or_path Qwen/Qwen2.5-1.5B-Instruct --dataset_name CharlieDreemur/OpenManus-RL
Ajuste por aprendizaje por refuerzo (GRPO): configure la función de recompensa, con los siguientes comandos:
python -m openmanus_rl.grpo --model_name_or_path Qwen/Qwen2.5-1.5B-Instruct --dataset_name CharlieDreemur/OpenManus-RL-GRPO --reward_funcs accuracy format tag_count
El conjunto de datos se puede obtener desde Huggingface.
5. Ejecutar el proyecto:
Ejecutar SFT con una sola GPU:
python -m openmanus_rl.sft --output_dir data/sft-output
Ejecutar GRPO con varias GPU (es necesario configurar zero3.yaml):
accelerate launch --config_file=configs/accelerate_configs/zero3.yaml openmanus_rl/grpo.py --output_dir data/grpo-output
Uso de OpenManus-RL
1. Construcción del entorno del agente:
Ejecute python -m openmanus_rl.sft para generar el entorno base.
Modifique el archivo de configuración (como el objetivo de la tarea o la función de recompensa).
Ejecute python -m openmanus_rl.grpo para comenzar el ajuste.
2. Recopilación de datos y pruebas:
Configurar el modelo (como Deepseek-R1): python -m openmanus_rl.grpo --model_name_or_path Deepseek-R1
Ejecutar la prueba: --benchmark GAIA, los resultados se guardan en el directorio data/.
3. Operaciones de ajuste por RL:
Ejecutar el modo GRPO: python -m openmanus_rl.grpo --reward_funcs accuracy
Consultar los registros de entrenamiento, el modelo se guarda en data/grpo-output.
Dirección del repositorio en GitHub: https://github.com/OpenManus/OpenManus-RL









