
 Asistente de guiones▸
 Apps AI
 Noticias AI
SpeakerKit: identifica de forma rápida y precisa a los distintos interlocutores en el audio
小编 ·

SpeakerKit: identifica de forma rápida y precisa a los distintos interlocutores en el audio
¿Qué es SpeakerKit?
SpeakerKit es una herramienta de diarización (reconocimiento de hablantes) en el dispositivo desarrollada por Argmax, capaz de identificar de forma rápida y eficiente a los distintos hablantes en un audio. Funciona junto con WhisperKit (una herramienta de transcripción de audio) para generar transcripciones con etiquetas de hablante. Es adecuada para aplicaciones que requieren una identificación rápida y precisa de los hablantes en audio.
Características principales de SpeakerKit
Velocidad:
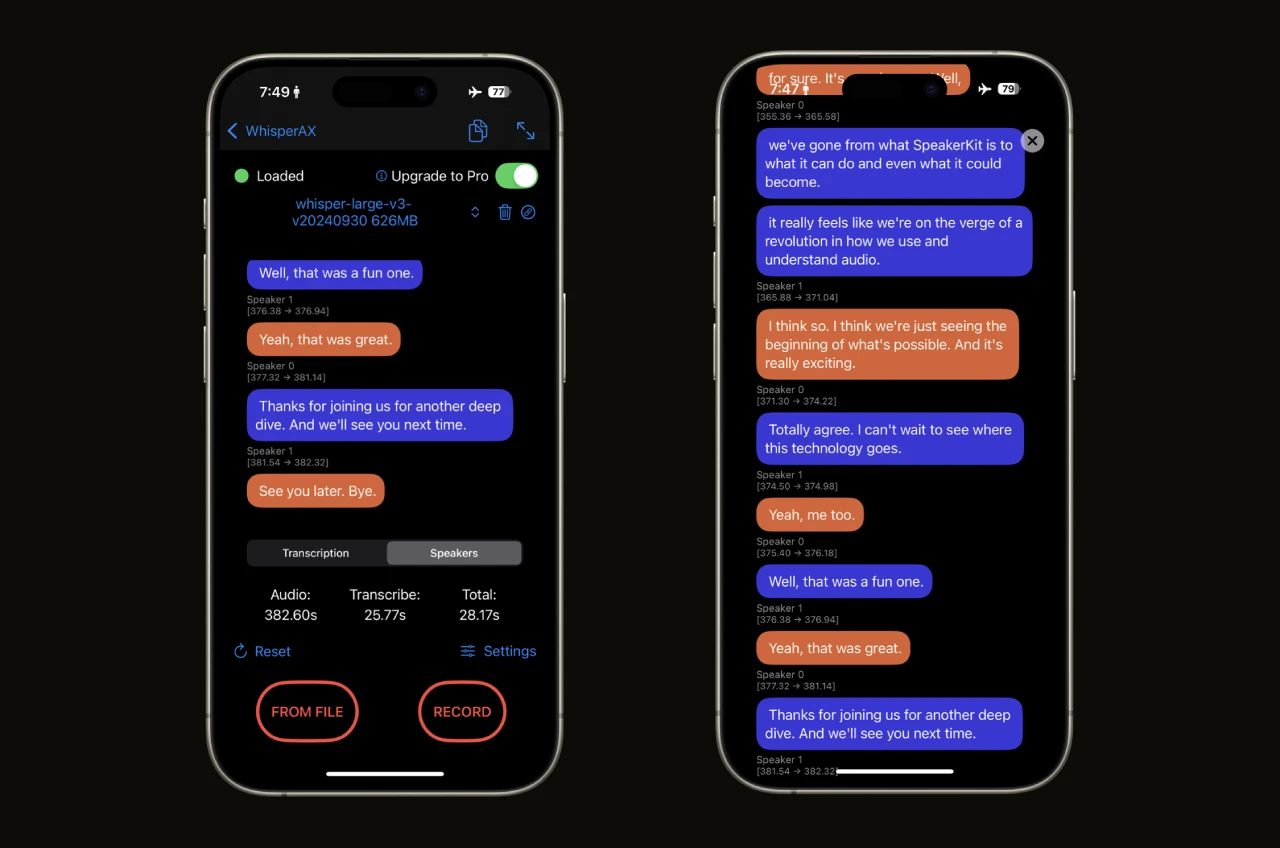
Al procesar 4 minutos de audio en un iPhone, SpeakerKit completa el reconocimiento de hablantes en aproximadamente 1 segundo, superando con creces la velocidad de otros sistemas similares.
Cuando se utiliza junto con WhisperKit, el tiempo total de transcripción e identificación es de solo 25 segundos.
Calidad:
La tasa de error de SpeakerKit es comparable a la de sistemas líderes del sector (como Pyannote), a pesar de ser varias veces más rápido.
Tamaño:
Con un tamaño total de aproximadamente 10 MB, resulta fácil de integrar en aplicaciones o de descargar rápidamente.
Compatibilidad:
Compatible con dispositivos con iOS 16 y macOS 13 o versiones posteriores.
La compatibilidad con Android está actualmente en desarrollo.
Modularidad:
SpeakerKit puede usarse junto con WhisperKit para generar transcripciones con etiquetas de hablante, y también puede integrarse con otros motores de transcripción, ofreciendo una mayor flexibilidad que las API del lado del servidor.
Benchmark
Argmax ha desarrollado un kit de herramientas de Python llamado SDBench para probar de forma estandarizada el rendimiento de los sistemas de reconocimiento de hablantes en 13 conjuntos de datos ampliamente utilizados. El código de SDBench será de código abierto y el artículo de investigación asociado se publicará en abril de 2025.
Planificación futura
Optimización de la calidad de la transcripción:Actualmente, la calidad de reconocimiento de hablantes independiente de SpeakerKit ya ha alcanzado un nivel líder en el sector (medido mediante DER). El siguiente paso del equipo será optimizar el uso conjunto con WhisperKit para mejorar la calidad de las transcripciones con etiquetas de hablante (medida mediante WDER).
Función de reconocimiento de hablantes:SpeakerKit lanzará una nueva función capaz de extraer las huellas vocales de los hablantes e identificarlos en nuevos contextos.
Lectura detallada:https://www.argmaxinc.com/blog/speakerkit
HuggingFace:https://huggingface.co/argmaxinc/speakerkit-pro









