
 Asistente de guiones▸
 Apps AI
 Noticias AI
ViDoRAG: sistema de Generación Aumentada por Recuperación (RAG) para la comprensión de documentos visuales
小编 ·

ViDoRAG: sistema de Generación Aumentada por Recuperación (RAG) para la comprensión de documentos visuales
¿Qué es ViDoRAG?
ViDoRAG es un sistema de Generación Aumentada por Recuperación (RAG) para la comprensión visual de documentos, presentado por el laboratorio Tongyi de Alibaba en colaboración con la Universidad de Ciencia y Tecnología de China y la Universidad de Shanghai Jiao Tong. Aprovecha la recuperación multimodal híbrida y un mecanismo de razonamiento iterativo multiagente, lo que mejora significativamente tanto la precisión como la eficiencia en el procesamiento de documentos visuales. En palabras sencillas, admite la recuperación en documentos que contienen imágenes, permitiéndote buscar entre documentos con imágenes cosas como "¿de qué color es este producto?" o "¿de qué trata este artículo?".
Marco de ViDoRAG
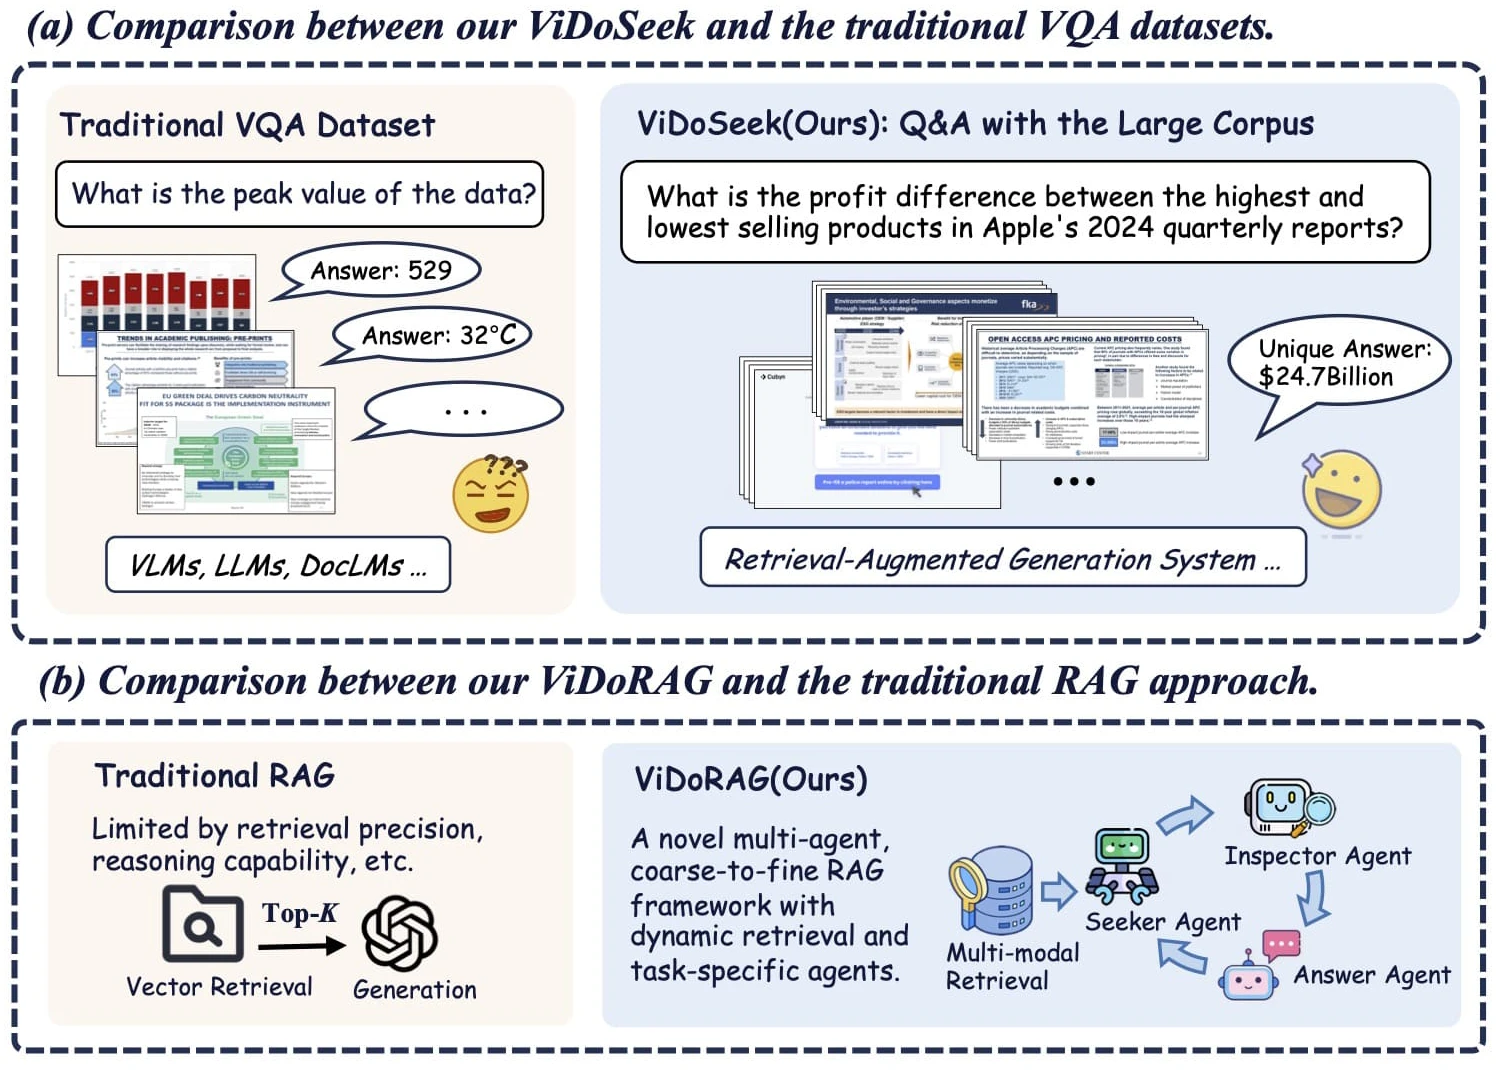
El marco de ViDoRAG se centra en la colaboración multiagente y el razonamiento iterativo dinámico, e incluye principalmente estos componentes clave:
Recuperación multimodal híbrida: combina características visuales y textuales, ajustando dinámicamente la estrategia de recuperación mediante un Modelo de Mezcla de Gausianas (GMM), para encontrar la información clave con mayor precisión.
Colaboración multiagente:
Seeker Agent: filtra rápidamente imágenes o fragmentos de documentos relevantes, proporcionando pistas globales.
Inspector Agent: examina en detalle los resultados filtrados y genera una respuesta preliminar.
Answer Agent: integra las respuestas preliminares, verifica su precisión y coherencia, y genera la respuesta final.
Estrategia de recuperación dinámica: utiliza GMM para ajustar dinámicamente la cantidad de resultados de recuperación, reduciendo el coste computacional y mejorando la eficiencia de recuperación.
Características funcionales
1. Recuperación multimodal híbrida:
Recuperación de doble canal visual y textual: ViDoRAG puede procesar simultáneamente información visual (imágenes) y textual para la recuperación, logrando una comprensión más completa del contenido del documento.
Fusión mediante Modelo de Mezcla de Gausianas (GMM): utiliza GMM para ajustar dinámicamente los pesos de los resultados de recuperación visual y textual, eligiendo la estrategia óptima según las características de la consulta, reduciendo el ruido y el coste computacional.
2. Razonamiento colaborativo multiagente:
Seeker Agent: filtra rápidamente documentos o fragmentos de imágenes relevantes, reduciendo el ámbito de búsqueda.
Inspector Agent: examina en detalle los fragmentos filtrados, extrayendo información clave para generar una respuesta preliminar.
Answer Agent: integra y valida las respuestas preliminares, generando la respuesta final.
Razonamiento iterativo dinámico: los múltiples agentes colaboran e iteran continuamente, mejorando progresivamente la calidad de las respuestas.
3. Estrategia de recuperación dinámica:
Cantidad de recuperación adaptativa: ViDoRAG ajusta dinámicamente la cantidad de resultados de recuperación mediante GMM, evitando los problemas derivados de una cantidad fija de resultados.
Flujo de recuperación eficiente: capaz de optimizar automáticamente la estrategia de recuperación según la distribución de similitud entre la consulta y el conjunto de documentos, mejorando la eficiencia de recuperación.
4. Capacidad de comprensión de documentos complejos:
Soporte de documentos visualmente ricos: puede procesar documentos que contienen texto, gráficos, tablas y maquetaciones complejas.
Capacidad de razonamiento multi-hop: capaz de manejar tareas de razonamiento de uno y varios saltos, abordando consultas complejas que requieren comprensión entre documentos.
5. Alta precisión y rendimiento:
Alta precisión: alcanza una precisión del 79,4 % en el conjunto de datos de referencia ViDoSeek, superando con creces a otros métodos de referencia.
Robustez: la colaboración multiagente y la estrategia de recuperación dinámica permiten a ViDoRAG mantener un rendimiento estable ante datos con ruido y escenarios complejos.
Escenarios de aplicación
Procesamiento de documentos visuales: adecuado para escenarios que manejan documentos visualmente ricos como literatura académica, informes y manuales.
Sistemas de preguntas y respuestas: puede servir como módulo central de un sistema de preguntas y respuestas, proporcionando respuestas rápidas y precisas.
Oficina inteligente: ayuda a los usuarios a extraer rápidamente la información clave de los documentos, mejorando la eficiencia del trabajo.
Repositorio de GitHub:https://github.com/Alibaba-NLP/ViDoRAG









