
 Asistente de guiones▸
 Apps AI
 Noticias AI
UniTok: el tokenizador visual de código abierto de ByteDance para tareas de generación y comprensión
小编 ·

UniTok: el tokenizador visual de código abierto de ByteDance para tareas de generación y comprensión
¿Qué es UniTok?
UniTok es un tokenizador visual de código abierto de Byte que se utiliza tanto para tareas de generación como de comprensión. Es capaz de transformar de manera eficiente la información visual en tokens, siendo adecuado para diversos modelos autorregresivos de generación y modelos multimodales de comprensión. Mediante una innovadora técnica de tokenización visual, consigue generar contenido visual de alta calidad con un número muy reducido de tokens (por ejemplo, 256 tokens), como la reconstrucción de imágenes y vídeos.
Funciones principales de UniTok
Codificación visual eficiente: UniTok es capaz de descomponer información visual compleja (como imágenes y vídeos) en tokens discretos, facilitando su procesamiento por parte del modelo.
Soporte multimodal: no solo es aplicable a imágenes, sino que también puede procesar contenido de vídeo, admitiendo tokenización continua y discreta.
Bajos requisitos de recursos: UniTok mantiene una alta calidad de reconstrucción incluso con un número reducido de tokens; por ejemplo, con 256 tokens el error de reconstrucción es de solo 0,39.
Tasa de compresión flexible: los usuarios pueden ajustar el número de tokens según sus necesidades para equilibrar la calidad de generación y la eficiencia computacional.
Ámbitos de aplicación de UniTok
Tareas de generación visual: como la reconstrucción de imágenes y vídeos, y la síntesis visual impulsada por modelos de lenguaje.
Comprensión multimodal: combina información textual y visual para lograr un entrenamiento más eficiente de modelos multimodales.
Modelos de difusión: combinado con modelos de difusión como DiT y Latte, genera contenido visual de alta calidad.
Implementación técnica de UniTok
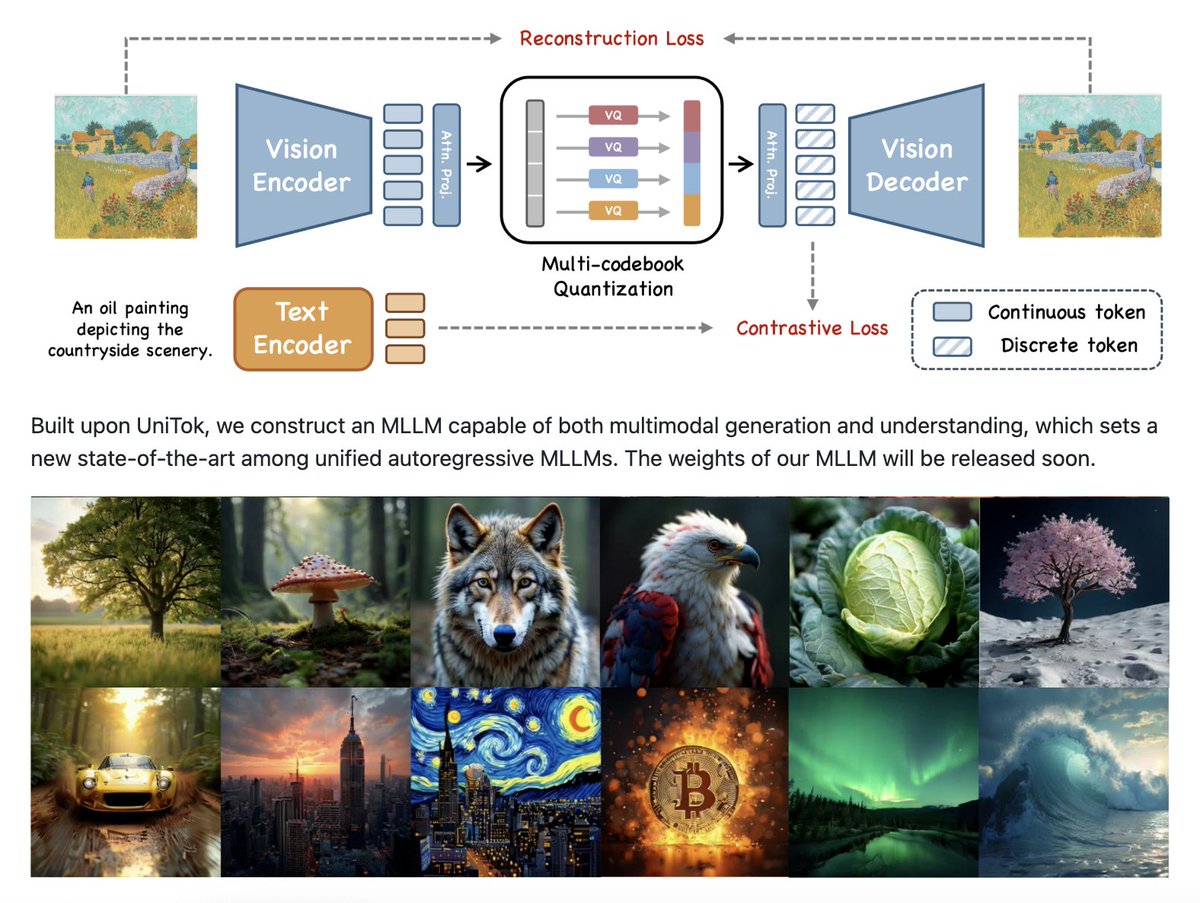
UniTok se basa en las tecnologías VQVAE (Variational Quantized Variational Autoencoder) y VAE (Variational Autoencoder), y logra una codificación visual eficiente mediante un entrenamiento en dos fases. Su proceso de entrenamiento incluye:
Entrenamiento de imágenes con una única resolución: entrenamiento de imágenes a una resolución fija.
Entrenamiento conjunto de imágenes y vídeos con múltiples resoluciones: entrenamiento conjunto de imágenes y vídeos en múltiples resoluciones.
Ajuste fino de VAE: ajuste fino del modelo VQVAE mediante la pérdida KL para obtener el modelo VAE.
Ventajas de UniTok
Modelo y pesos unificados: UniTok procesa la tokenización de imágenes y vídeos mediante un único modelo y pesos, lo que simplifica la gestión y el despliegue del modelo.
Alta adaptabilidad: admite entradas de alta resolución y vídeos largos, adaptándose a múltiples escenarios de aplicación.
Gran compatibilidad: es compatible con modelos de lenguaje y modelos de difusión, permitiendo una generación visual diversificada.
UniTok, mediante la técnica de cuantización con múltiples codebooks, resuelve el cuello de botella de los tokenizadores tradicionales en tareas de generación y comprensión, ofreciendo una solución más eficiente para los modelos de lenguaje grandes multimodales (MLLMs).
Dirección del proyecto: https://foundationvision.github.io/UniTok/
Repositorio de GitHub: https://github.com/FoundationVision/UniTok









