
 Asistente de guiones▸
 Apps AI
 Noticias AI
CSM: el modelo de síntesis de voz de Sesame, como hablar con una persona real
小编 ·

CSM: el modelo de síntesis de voz de Sesame, como hablar con una persona real
¿Qué es CSM?
CSM (Conversational Speech Model) es un modelo de síntesis de voz conversacional desarrollado por la empresa Sesame. Se basa en la arquitectura Transformer, adopta un método de aprendizaje multimodal de extremo a extremo, y es capaz de combinar el contexto y el trasfondo emocional para sintetizar una voz humana extremadamente realista, con un rendimiento destacado en el campo de la síntesis de voz.
Características y funcionalidades de CSM
Expresión de voz natural: imita el tono, el ritmo y el timbre de la voz humana real, resolviendo el problema de la monotonía tonal de los sistemas tradicionales de síntesis de voz, haciendo que la voz sintetizada suene como una persona real.
Expresión emocional sutil: puede incorporar elementos naturales como emociones, pausas y énfasis, transmitiendo rabia, tristeza, entusiasmo y muchas otras emociones, haciendo las conversaciones más emotivas.
Respuesta de baja latencia: gracias a métodos computacionales optimizados, garantiza conversaciones fluidas, con un tiempo de respuesta de la ia extremadamente corto, cercano a la reacción inmediata humana.
Interacción multimodal: puede recibir simultáneamente texto e historial de voz como entrada, posee capacidad de comprensión del contexto, entiende el trasfondo y la emoción de la conversación, haciendo la voz más natural y la interacción más rica.
Consistencia de la personalidad: mantiene características de voz estables, evitando incoherencias en distintos contextos y eliminando el tono robótico típico de los sistemas TTS tradicionales.
Modelado dinámico del diálogo: simula las pausas naturales, la velocidad del habla y el énfasis propios de la conversación humana, aumentando el realismo y la interactividad de la interacción por voz.
Aspectos técnicos destacados de CSM
Arquitectura Transformer multimodal de extremo a extremo: genera voz de alta calidad directamente a partir de texto, sin pasos intermedios de procesamiento. Basada en Transformer como núcleo, permite que la voz de IA tenga conciencia del contexto. El texto se procesa con LLaMA Tokenizer, la voz se codifica con Mimi Tokenizer, y se emplea la técnica de cuantización RVQ.
Codificación de audio basada en Residual Vector Quantization (RVQ): utiliza dos tipos de tokens de audio: tokens semánticos, que representan la semántica y las características de pronunciación de la voz, y tokens acústicos, que representan detalles como el tono, el timbre y la prosodia. Mediante un entrenamiento RVQ jerárquico, las distintas capas predicen las características principales y de detalle, evitando la pérdida de información y mejorando la naturalidad de la voz.
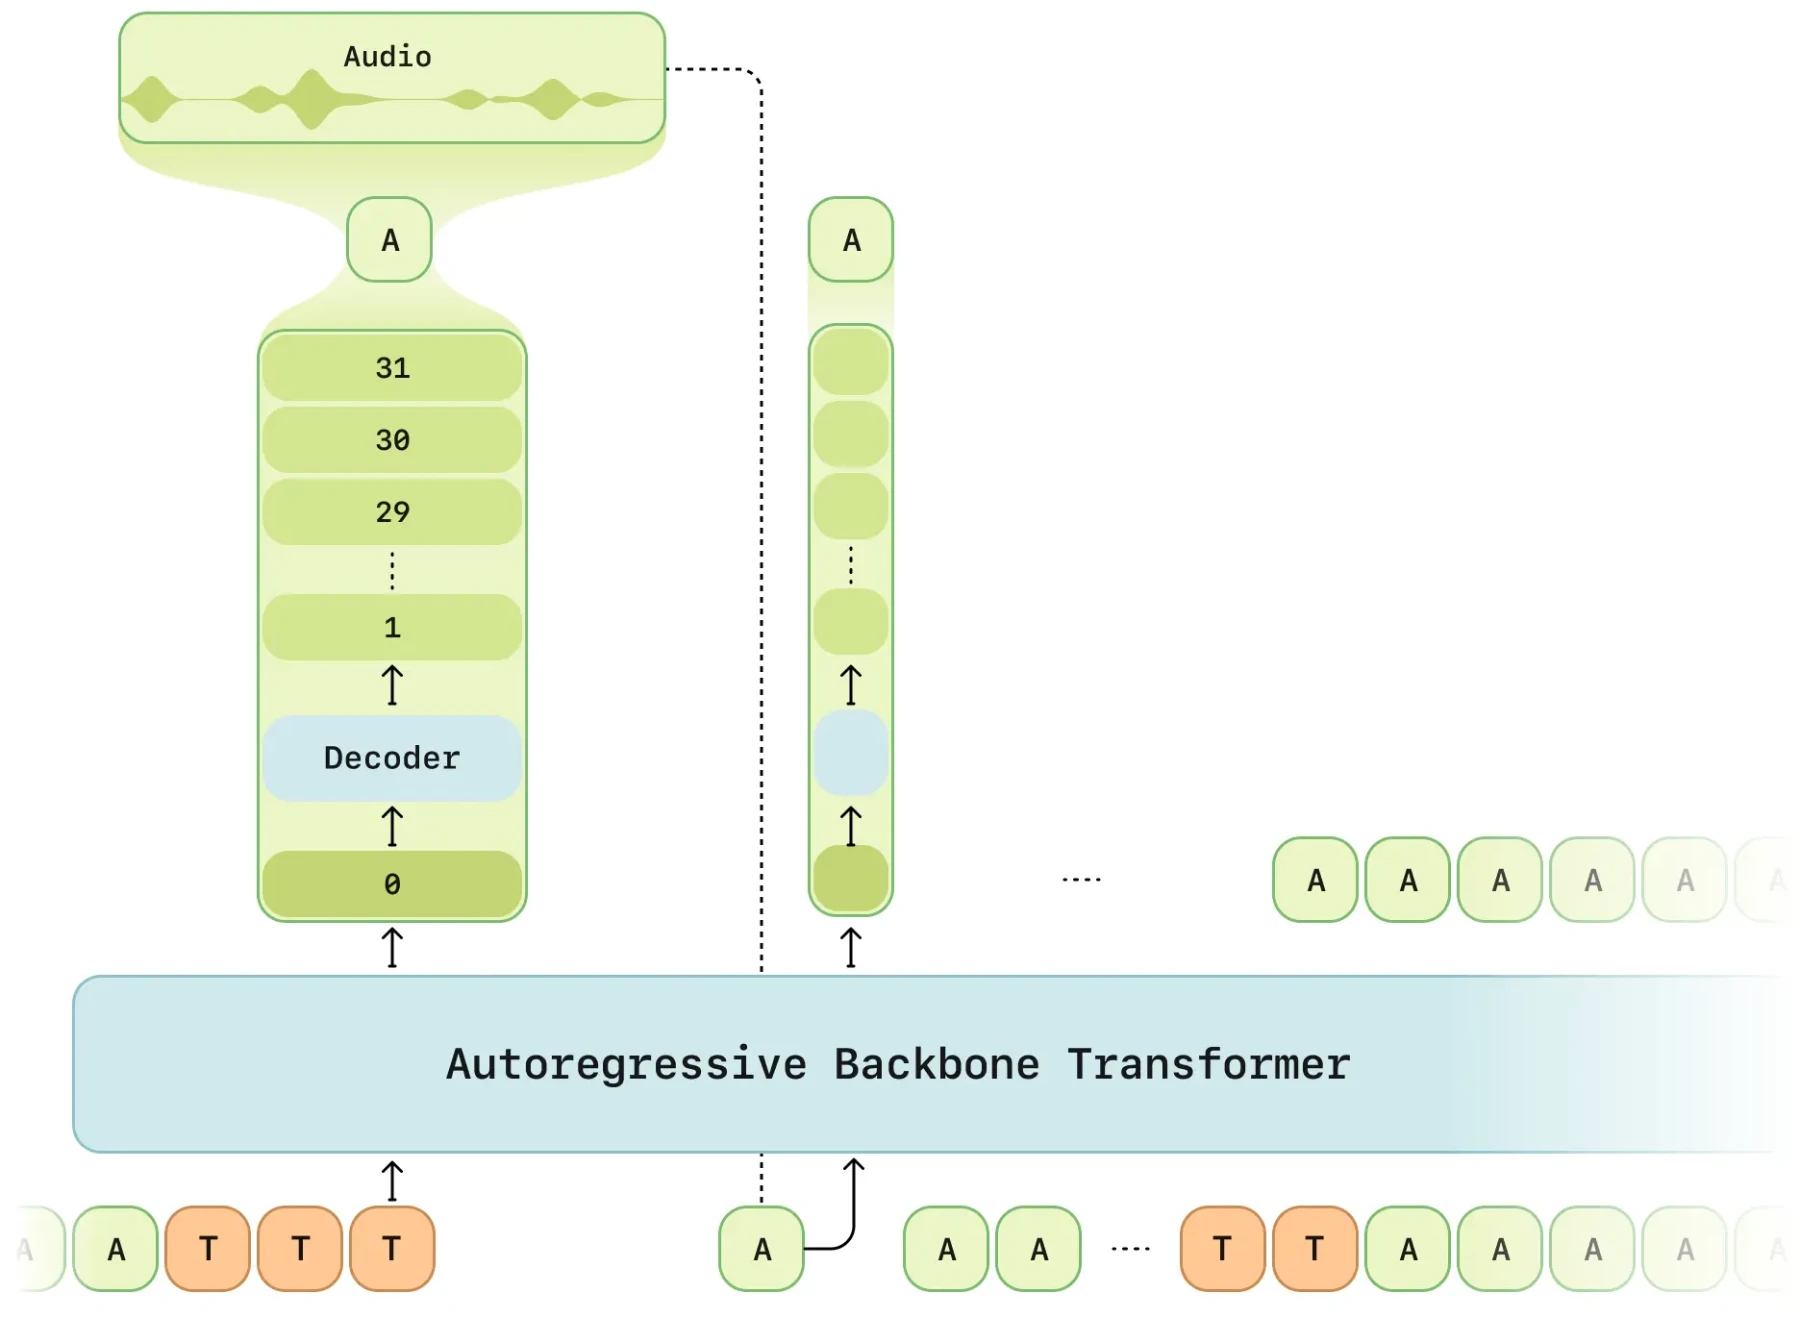
Optimización computacional e inferencia de baja latencia
Optimización del modo de latencia: primero se calculan las capas RVQ de nivel inferior y, sucesivamente, las características de detalle de los niveles superiores, acelerando la velocidad de inferencia.
Amortización del cálculo: durante la fase de entrenamiento se muestrean aleatoriamente 1/16 de los fotogramas de audio para optimizar, reduciendo las necesidades de cálculo sin afectar a la calidad del audio.
Estructura Transformer de dos etapas: un Transformer principal procesa la información de texto y audio y predice la estructura básica; un decodificador ligero refina el audio, reduciendo la carga computacional y aumentando la velocidad de inferencia.
Aplicaciones generalizadas de CSM
Asistentes inteligentes: hace que la interacción por voz de altavoces inteligentes y asistentes virtuales sea más natural y cercana, como hablar con una persona real.
Atención al cliente: su aplicación en sistemas de servicio al cliente permite a los usuarios disfrutar de una experiencia de interacción más fluida y aumenta la satisfacción.
Educación y formación: crea entornos de conversación realistas en aplicaciones de aprendizaje de idiomas, ayudando a los estudiantes a comprender y practicar los conocimientos lingüísticos.
Industria del entretenimiento: dota a los personajes de juegos, animaciones y otros sectores con voces vivas y realistas, haciendo las historias más atractivas.
Creación de asistentes virtuales: crea asistentes virtuales con una voz más natural que ofrecen un servicio cercano y atento.
Optimización de herramientas de traducción: genera conversaciones naturales y fluidas en la traducción de voz en tiempo real, mejorando la experiencia de traducción.
Interacción en plataformas educativas: desempeña un papel en los diálogos de voz interactivos de plataformas educativas, aumentando la diversión y la eficacia del aprendizaje.
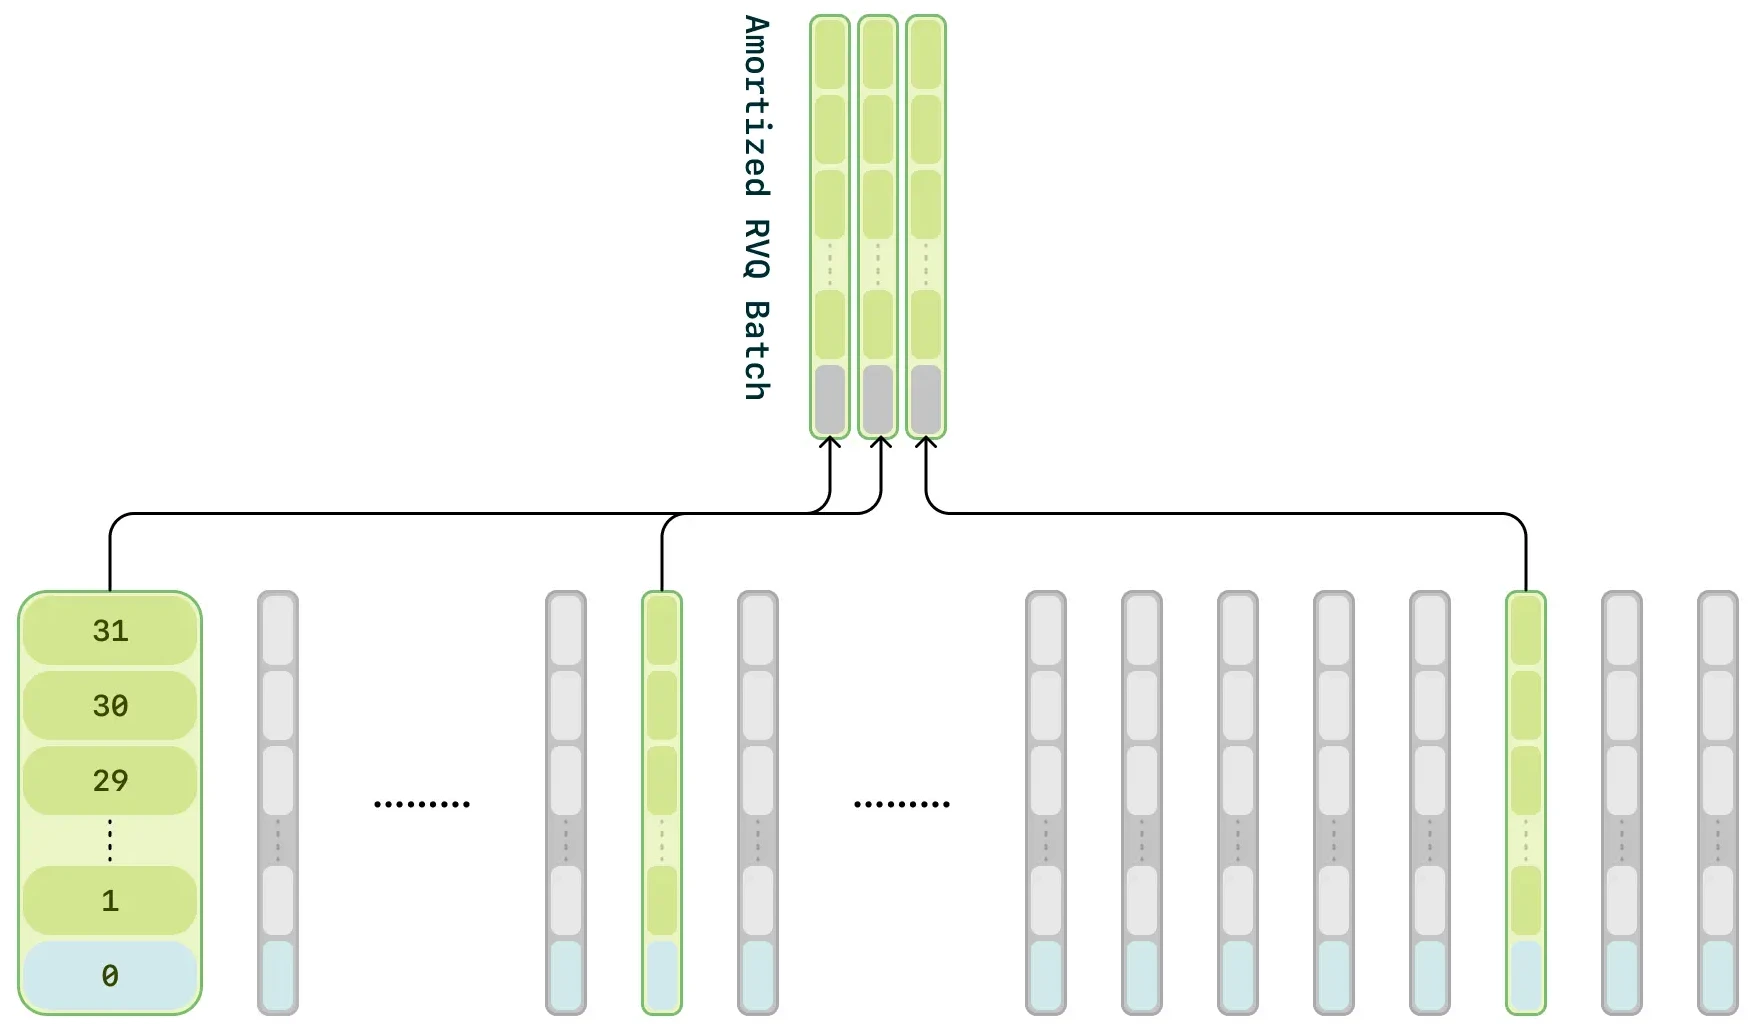
Cómo usar CSM
Experiencia en línea
Puedes visitar el sitio web oficial de Sesame (sesame.com/voicedemo) para experimentar los efectos de la tecnología de síntesis de voz.
Integración en productos
Los desarrolladores pueden integrar el modelo de voz de Sesame en productos o servicios como asistentes de voz, sistemas de atención al cliente inteligentes, etc., mejorando las capacidades de interacción por voz.
Investigación y desarrollo
La empresa Sesame tiene previsto ampliar la escala del modelo y aumentar el volumen del conjunto de datos. Los investigadores pueden seguir la presentación oficial y las demostraciones (https://www.sesame.com/research/crossing_the_uncanny_valley_of_voice ) para conocer los últimos resultados y avances técnicos.
Si quieres probarlo en línea, puedes visitar:https://www.sesame.com/research/crossing_the_uncanny_valley_of_voice#demo









