
 Asistente de guiones▸
 Apps AI
 Noticias AI
Migician: modelo multimodal de la Universidad de Tsinghua y colaboradores para la localización de objetos en múltiples imágenes en escenas complejas
小编 ·

Migician: modelo multimodal de la Universidad de Tsinghua y colaboradores para la localización de objetos en múltiples imágenes en escenas complejas
¿Qué es Migician?
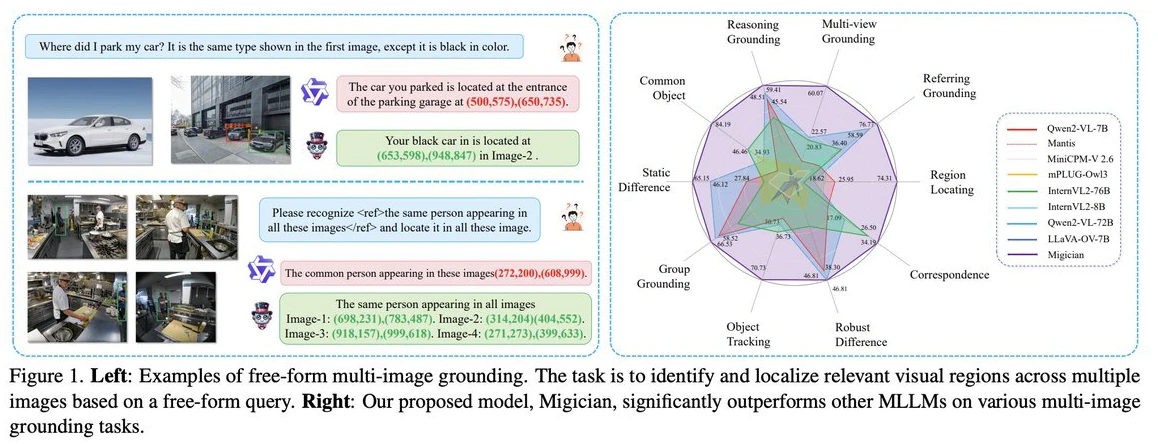
Migician es un modelo de lenguaje grande multimodal desarrollado conjuntamente por la Universidad de Tsinghua, la Universidad Jiaotong de Beijing y la Universidad de Ciencia y Tecnología de Huazhong, capaz de realizar localización de forma libre (free-form) y precisa en escenarios con múltiples imágenes. Admite la localización rápida de regiones objetivo en varias imágenes mediante descripciones de texto, imágenes o una combinación de ambas, mejorando la capacidad de localización en escenarios de múltiples imágenes.
Principales funciones de Migician
Localización entre imágenes: Migician admite varios métodos de localización entre imágenes, incluyendo la búsqueda por imagen y la consulta combinada de "texto + imagen". Por ejemplo, en vigilancia de seguridad, al introducir una descripción de texto como "un hombre con una camiseta negra, vaqueros azules y una gorra de béisbol blanca", el modelo puede localizar rápidamente entre las imágenes de vigilancia a la persona que coincide con esa descripción.
Fusión multimodal: mediante una arquitectura avanzada de redes neuronales, Migician integra eficazmente la información visual y lingüística, profundizando en las asociaciones semánticas entre imágenes. Por ejemplo, al realizar la tarea de "encontrar la imagen con un coche rojo en un conjunto de escenas urbanas", el modelo extrae características visuales como el color y la forma de las imágenes y, al mismo tiempo, analiza la información semántica de "coche rojo" en el texto, fusionando ambas para localizar el objetivo con mayor precisión.
Optimización del razonamiento CoT (Chain-of-Thought): Migician incorpora optimización del razonamiento CoT, descomponiendo problemas complejos en varios subproblemas sencillos para derivar paso a paso la respuesta final. Por ejemplo, al localizar un objeto en una habitación específica, el modelo primero determina la zona donde es probable que se encuentre esa habitación según la descripción de texto y, a continuación, localiza con precisión el objeto dentro de las imágenes de esa zona.
Marco de extremo a extremo: Migician adopta un marco de extremo a extremo que procesa directamente entradas de múltiples imágenes, evitando la acumulación de errores y la baja eficiencia de los métodos tradicionales de razonamiento por pasos.
Rendimiento del modelo
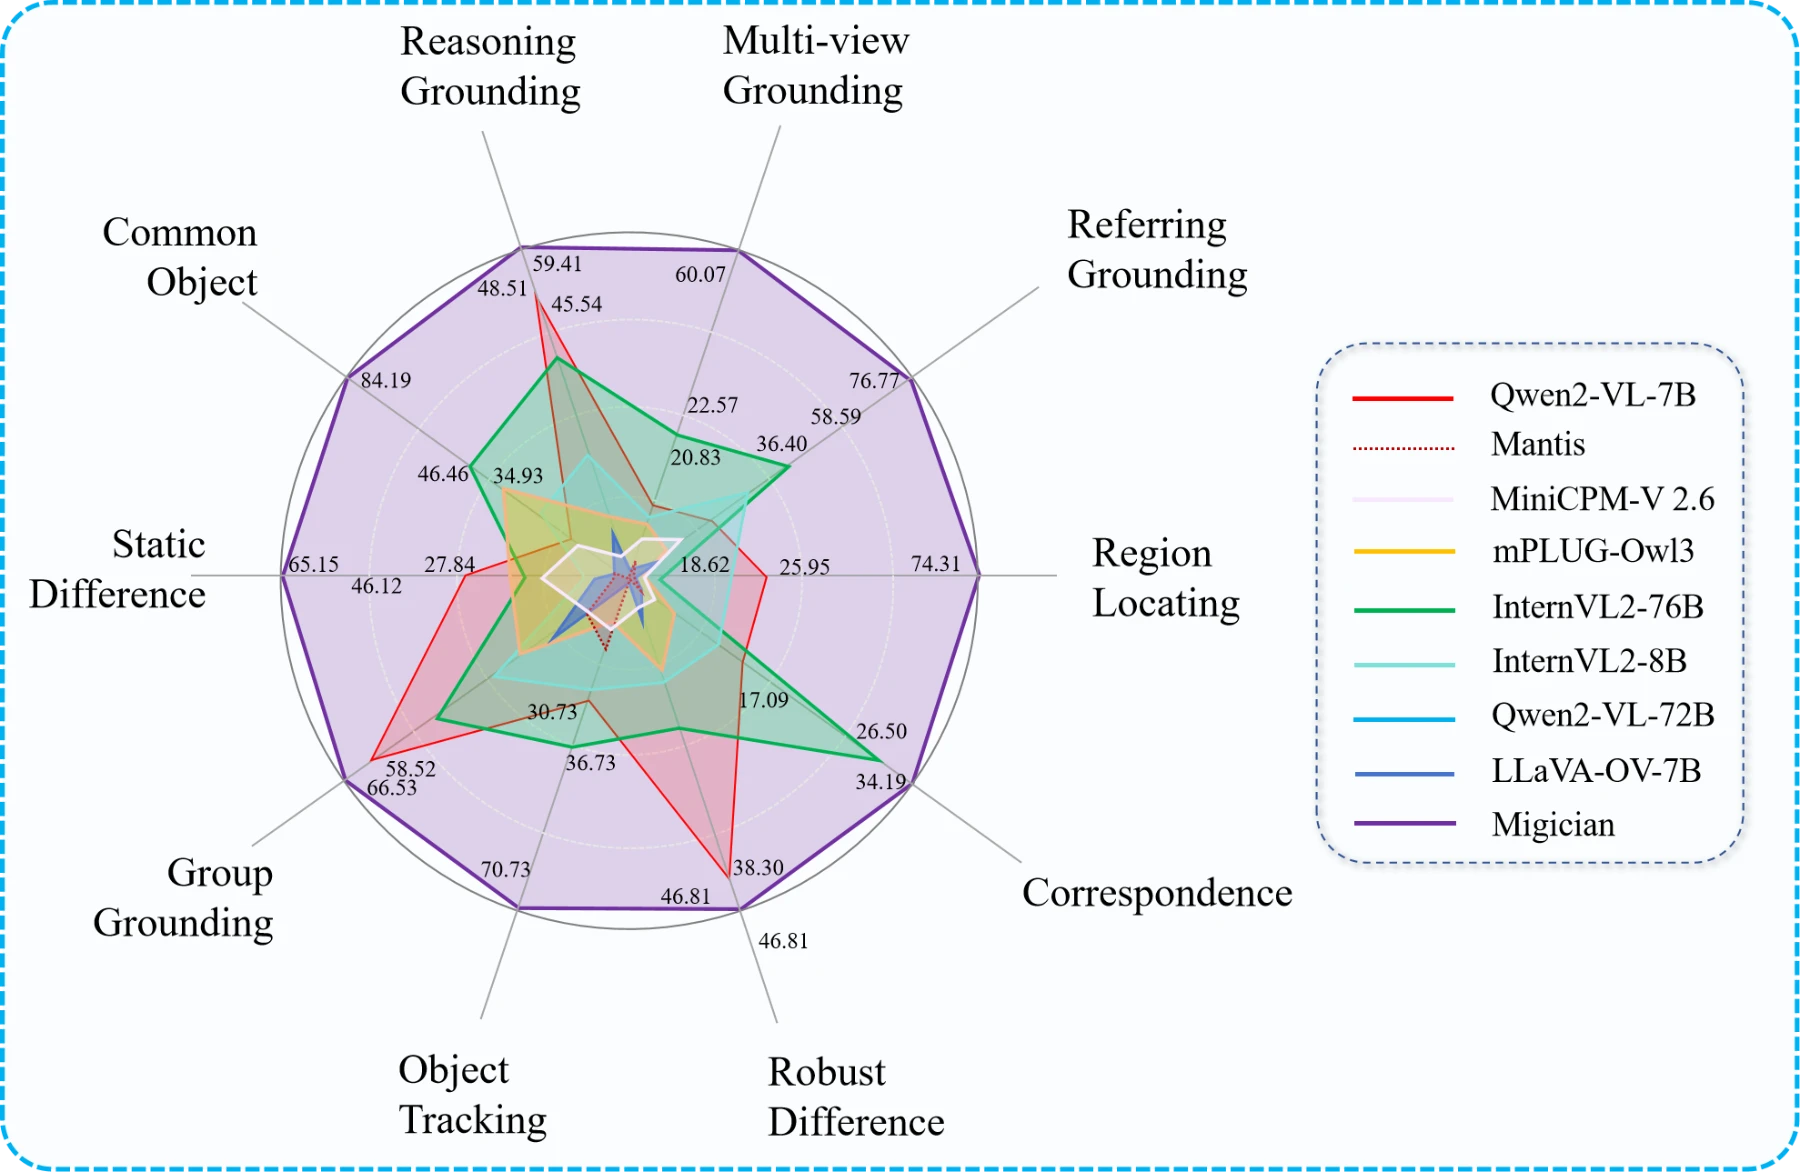
Resultados de rendimiento: Migician ofrece un rendimiento sobresaliente en tareas de localización en múltiples imágenes, superando significativamente a los MLLM actuales e incluso superando en varias tareas a modelos más grandes de 70B. En concreto, Migician supera al mejor MLLM existente en un 21,61 % en MIG-Bench.
Métricas de evaluación: MIG-Bench ofrece métricas de evaluación como IOU@0,7, IOU@0,5, IOU@0,3 e IOU promedio; los usuarios pueden realizar una evaluación con un solo clic ejecutando el script MIG_bench_eval.py.
Escenarios de aplicación de Migician
Vigilancia de seguridad: análisis en tiempo real de las imágenes de varias cámaras de vigilancia para localizar rápidamente personas sospechosas, vehículos o eventos anómalos.
Conducción autónoma: fusión de la información de imágenes procedente de varios sensores del vehículo, combinada con descripciones de texto sobre la carretera, obstáculos y señales de tráfico, para ayudar al vehículo a percibir su entorno con mayor precisión.
Diagnóstico por imagen médica: localización rápida de regiones con lesiones en múltiples imágenes médicas para ayudar en el diagnóstico de enfermedades.
Inteligencia corpórea en robots: ayuda a los robots a localizar rápidamente objetos objetivo en entornos complejos y a realizar tareas como agarrar y transportar.
Recursos del proyecto Migician
Repositorio de GitHub:https://github.com/thunlp/Migician
Enlace al artículo:https://arxiv.org/pdf/2501.05767
Migician es una potente herramienta diseñada específicamente para tareas de localización en múltiples imágenes. Gracias al conjunto de datos a gran escala MGrounding-630k y al referente de evaluación integral MIG-Bench, su capacidad de localización en escenarios con múltiples imágenes se ha mejorado significativamente.









