
 Asistente de guiones▸
 Apps AI
 Noticias AI
VLM-R1: modelo de visión-lenguaje estilo R1 con mayor estabilidad y generalización
小编 ·

VLM-R1: modelo de visión-lenguaje estilo R1 con mayor estabilidad y generalización
¿Qué es VLM-R1?
VLM-R1 (Visual Language Model - R1) es un nuevo modelo de lenguaje visual de código abierto desarrollado por el equipo de Om ai Lab. Su núcleo reside en trasladar con éxito el método DeepSeek R1 al ámbito de los modelos visión-lenguaje, logrando una mayor estabilidad y capacidad de generalización.
VLM-R1 se construye sobre Qwen2.5-VL y mejora la comprensión visual mediante aprendizaje por refuerzo. En tareas visuales, especialmente en la comprensión de datos entre dominios, su rendimiento supera al de los modelos SFT tradicionales, mostrando una sólida capacidad de comprensión de contenido visual, lo que representa uno de los avances importantes en el desarrollo de la IA multimodal.
Antecedentes técnicos de VLM-R1:
VLM-R1 se inspira en el método R1 que el equipo de DeepSeek abrió al código abierto el año pasado, el cual emplea la técnica de aprendizaje por refuerzo GRPO (Group Relative Policy Optimization) y取得了显著的效果 en grandes modelos de lenguaje de texto puro. El equipo de VLM-R1 aplicó este método a los modelos visión-lenguaje, abriendo con éxito una nueva etapa en el campo multimodal.
Características principales de VLM-R1:
Robustez entre dominios: incluso en entornos de aplicación complejos e impredecibles, VLM-R1 puede mantener un alto nivel de rendimiento.
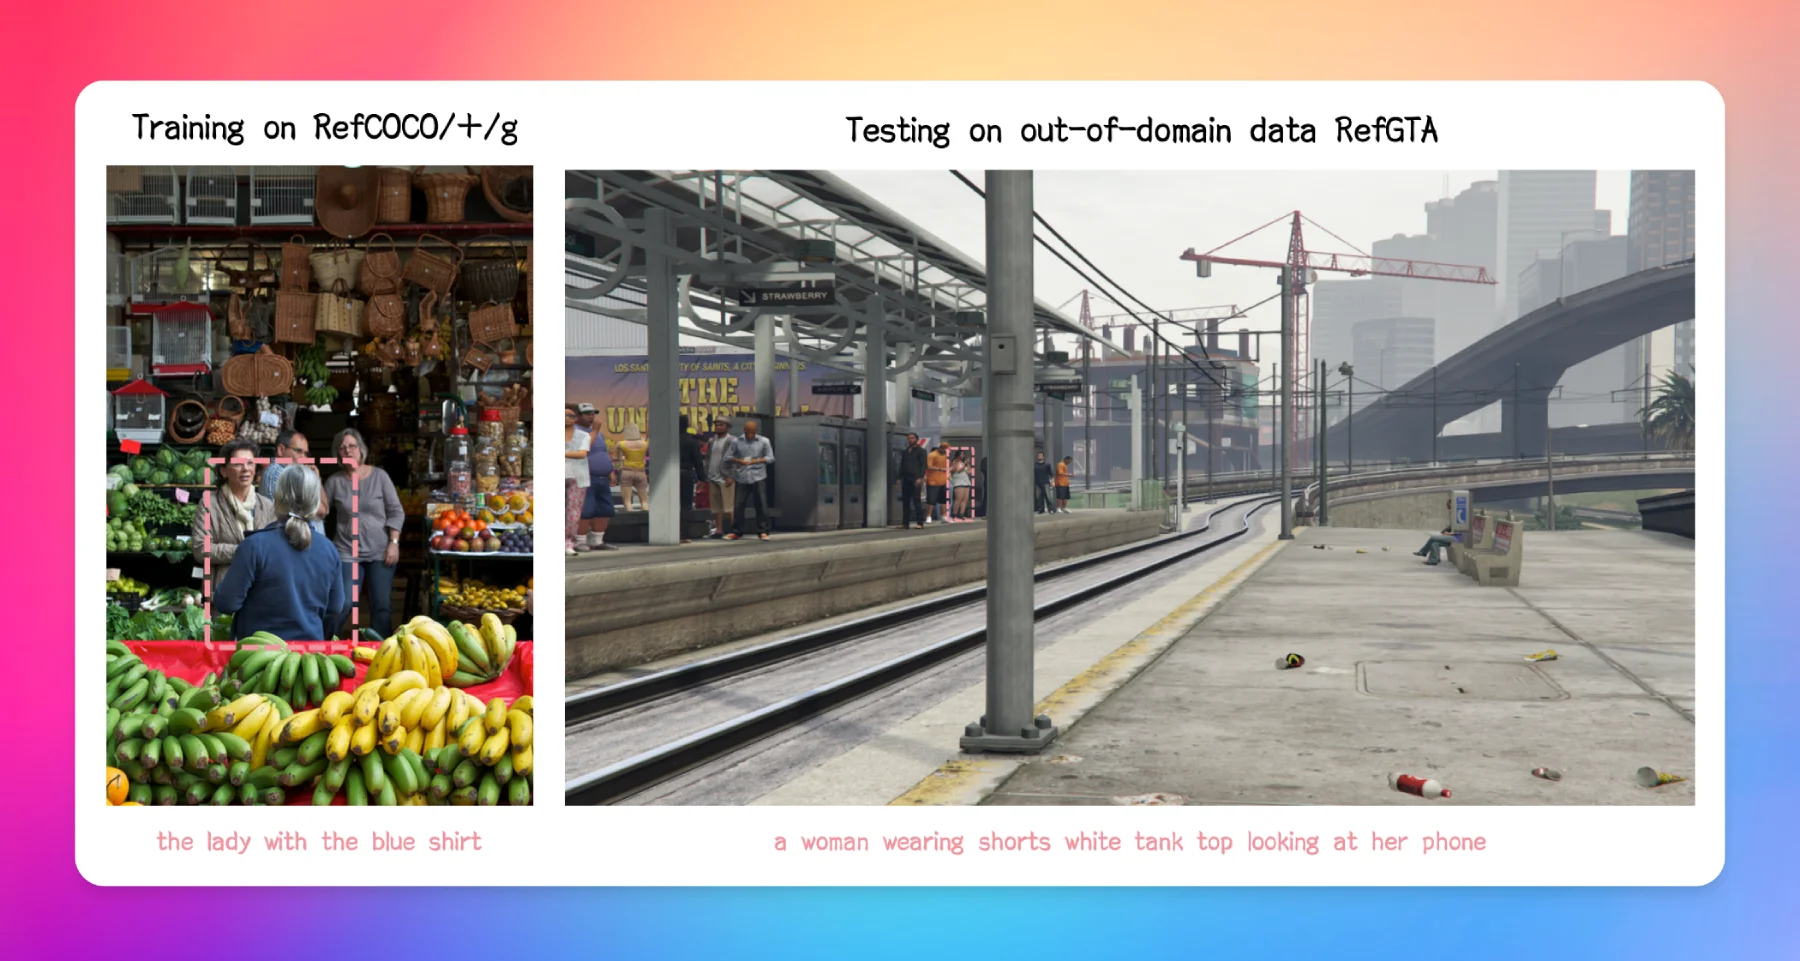
Excelente capacidad de generalización: a diferencia del ajuste fino supervisado (SFT) tradicional, VLM-R1, ante tareas o distribuciones de datos no vistos, sigue mejorando su rendimiento con el paso del tiempo, mostrando una gran adaptabilidad y flexibilidad.
Alta facilidad de uso: el flujo completo de entrenamiento y evaluación permite a los usuarios comenzar y llevar a cabo experimentos en pocos pasos, lo cual resulta extremadamente conveniente para investigadores e ingenieros que deseen aprovechar técnicas avanzadas de IA.
Uso eficiente de recursos: la técnica de optimización dinámica permite entrenar modelos con un gran número de parámetros (de hasta miles de millones) utilizando una sola GPU, reduciendo la barrera de coste de hardware y mejorando la eficiencia.
Implementación técnica de VLM-R1:
VLM-R1, sobre la base de Qwen2.5-VL, comparó el método R1 con el SFT tradicional. Los resultados muestran que el modelo R1 supera al modelo SFT tradicional en estabilidad, capacidad de generalización y profundidad de comprensión. Además, VLM-R1 demostró, mediante un caso práctico, su capacidad profesional en reconocimiento visual, razonamiento de conocimiento y expresión textual.
Escenarios de aplicación de VLM-R1:
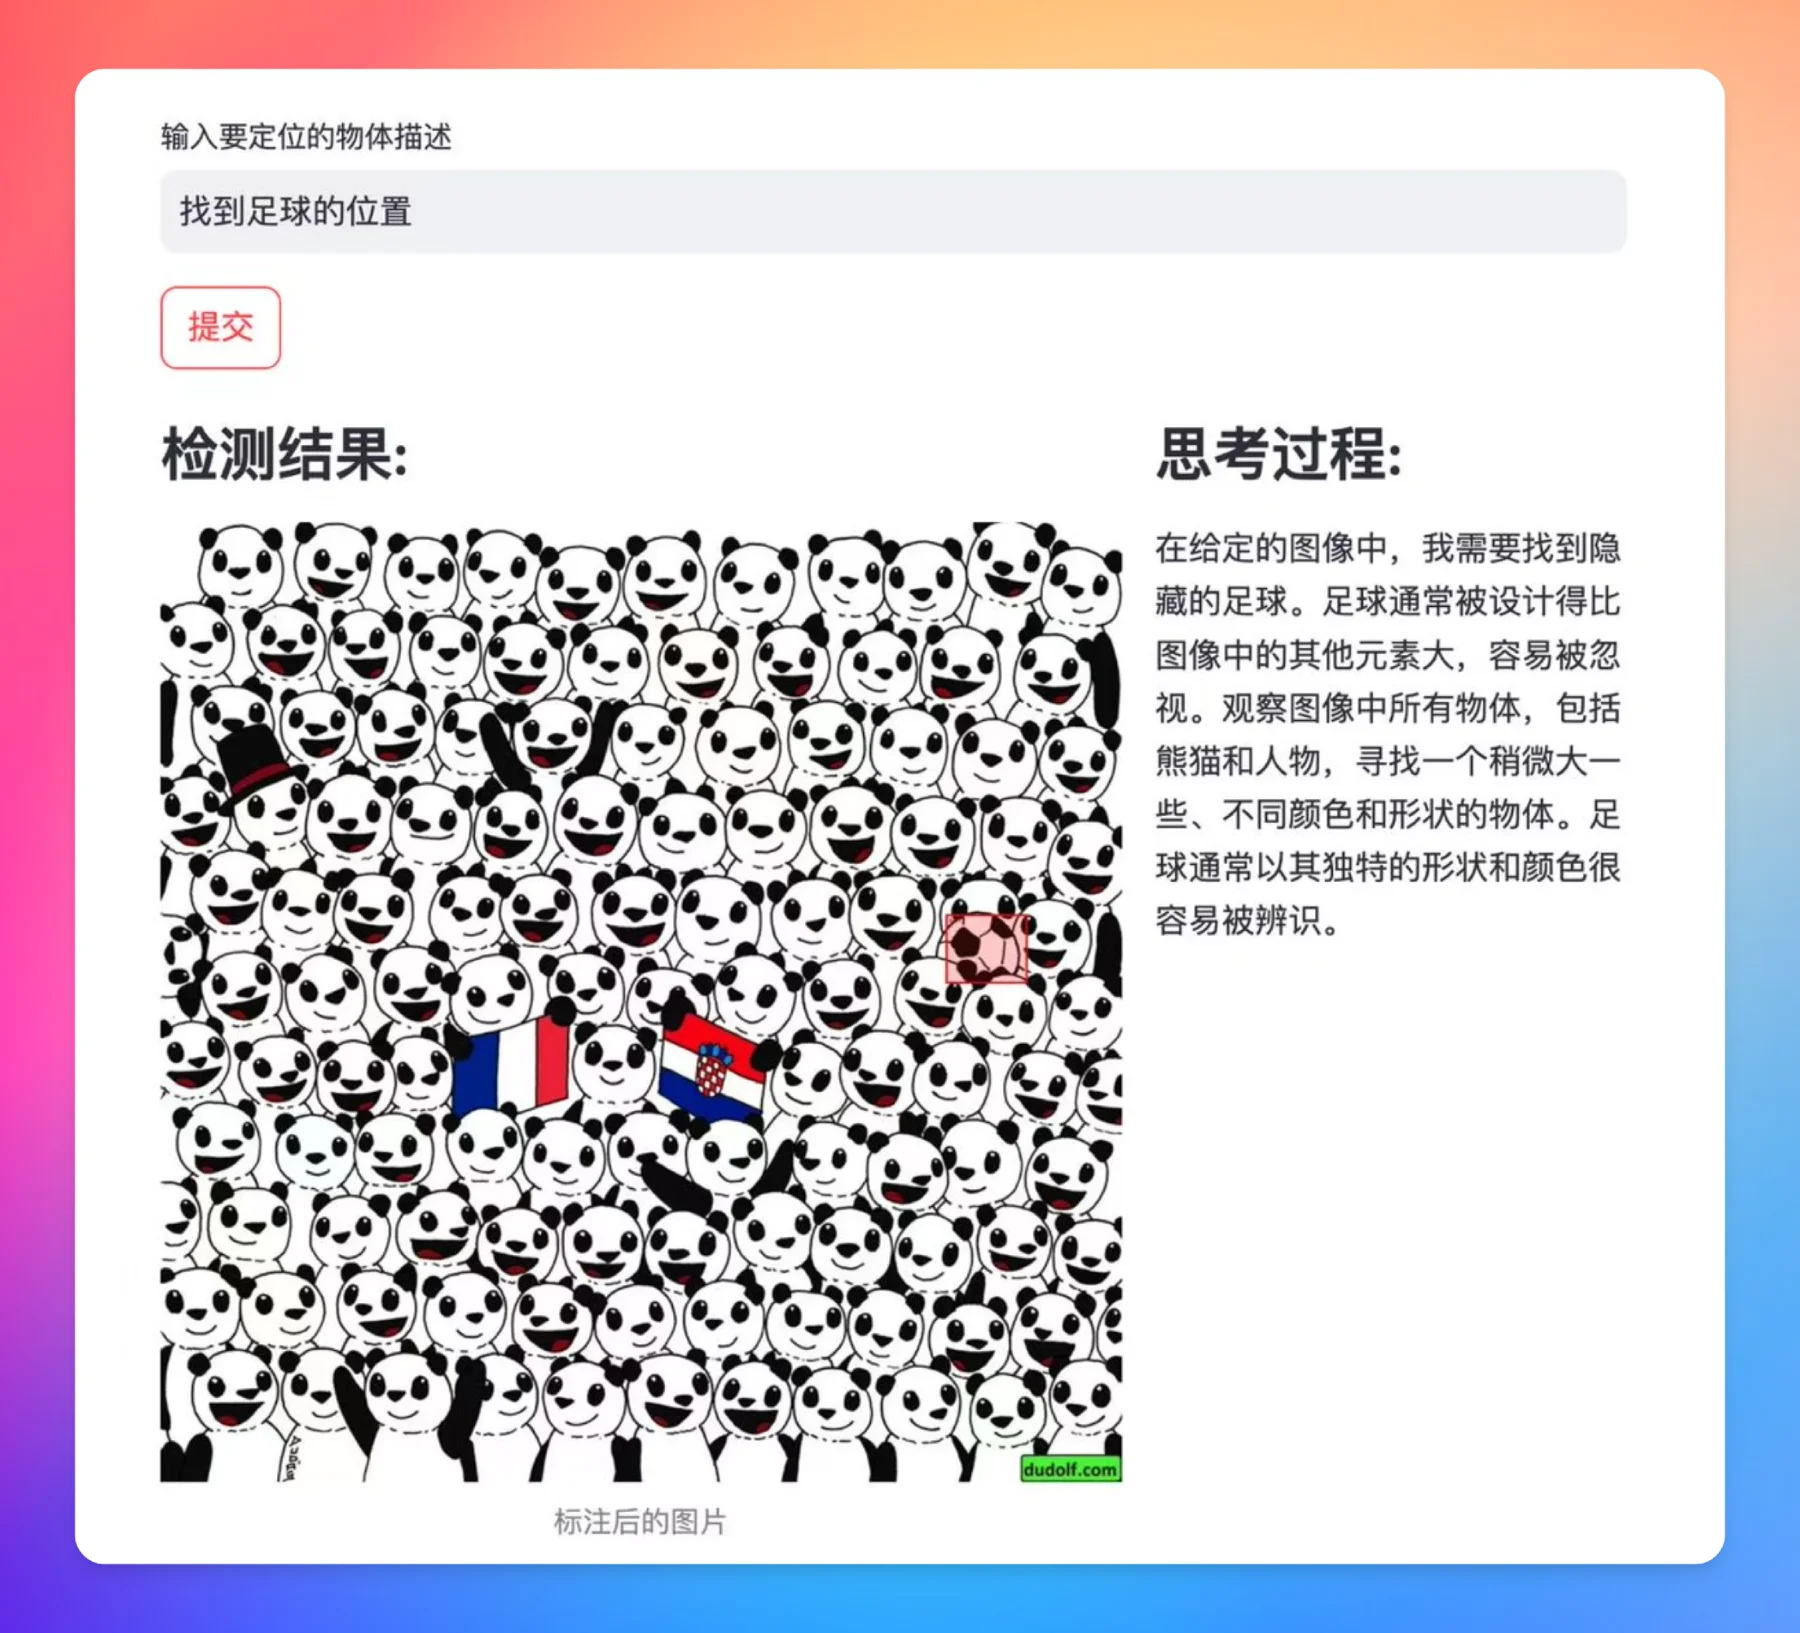
VLM-R1 ha mostrado un rendimiento excelente en múltiples aplicaciones reales. Por ejemplo, en asistentes inteligentes, sistemas de conducción autónoma y realidad virtual, su potente capacidad de procesamiento y flexibilidad le confieren un amplio potencial de aplicación en la interacción multimodal. En un caso de demostración concreto, al proporcionarle una foto con diversos ingredientes, VLM-R1 identificó con precisión el alimento con alto contenido en proteínas — la tortilla de huevo — y además explicó la razón. Asimismo, puede localizar con exactitud los objetos marcados en la imagen, lo que demuestra plenamente su sobresaliente capacidad integral de generación de texto, razonamiento lógico y percepción visual.
Enlaces relacionados de VLM-R1:
Repositorio en GitHub:https://github.com/om-ai-lab/VLM-R1
Demo:https://huggingface.co/spaces/omlab/VLM-R1-Referral-Expression









