
 Asistente de guiones▸
 Apps AI
 Noticias AI
La guía definitiva de entrenamiento de LLM: entrena modelos de lenguaje grandes en clústeres GPU masivos (edición china)
小编 ·

La guía definitiva de entrenamiento de LLM: entrena modelos de lenguaje grandes en clústeres GPU masivos (edición china)
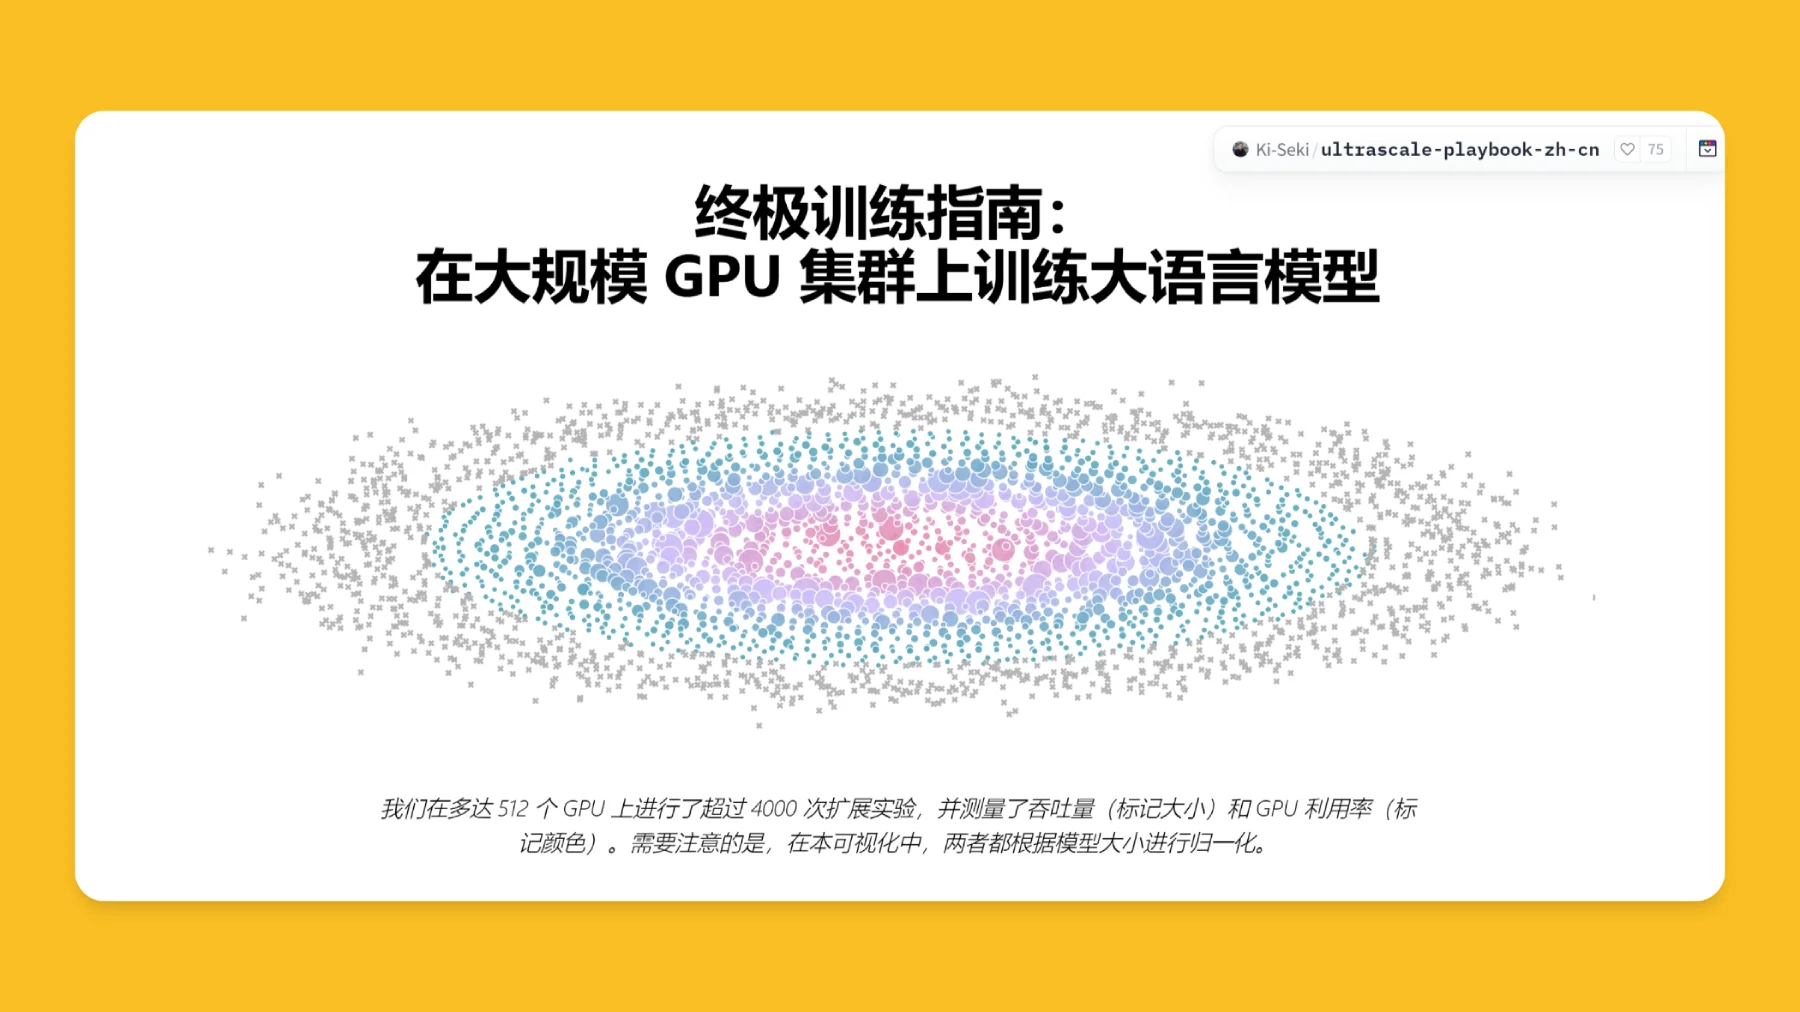
Hugging Face ha lanzado la guía Ultra-Scale Playbook, cuyo nombre en chino es 终极训练指南 (Guía definitiva de entrenamiento) sobre el entrenamiento de ai grandes modelos de lenguaje (LLMs) en clústeres de GPU a gran escala. Parte de lo más básico para orientar a los usuarios en la escalabilidad del entrenamiento de grandes modelos de lenguaje (LLM) en clústeres de GPU a gran escala. Esta guía ofrece orientación completa para entrenar en clústeres de entre 1 y más de 1000 GPUs, y además muestra los resultados de experimentos de escalado realizados en hasta 512 GPUs, analizando en detalle métricas como el rendimiento (throughput) y la utilización de las GPUs.
Texto original: The Ultra-Scale Playbook: Training LLMs on GPU Clusters
Herramienta de traducción: o1, o3-mini
Revisor: @Ki_Seki_here
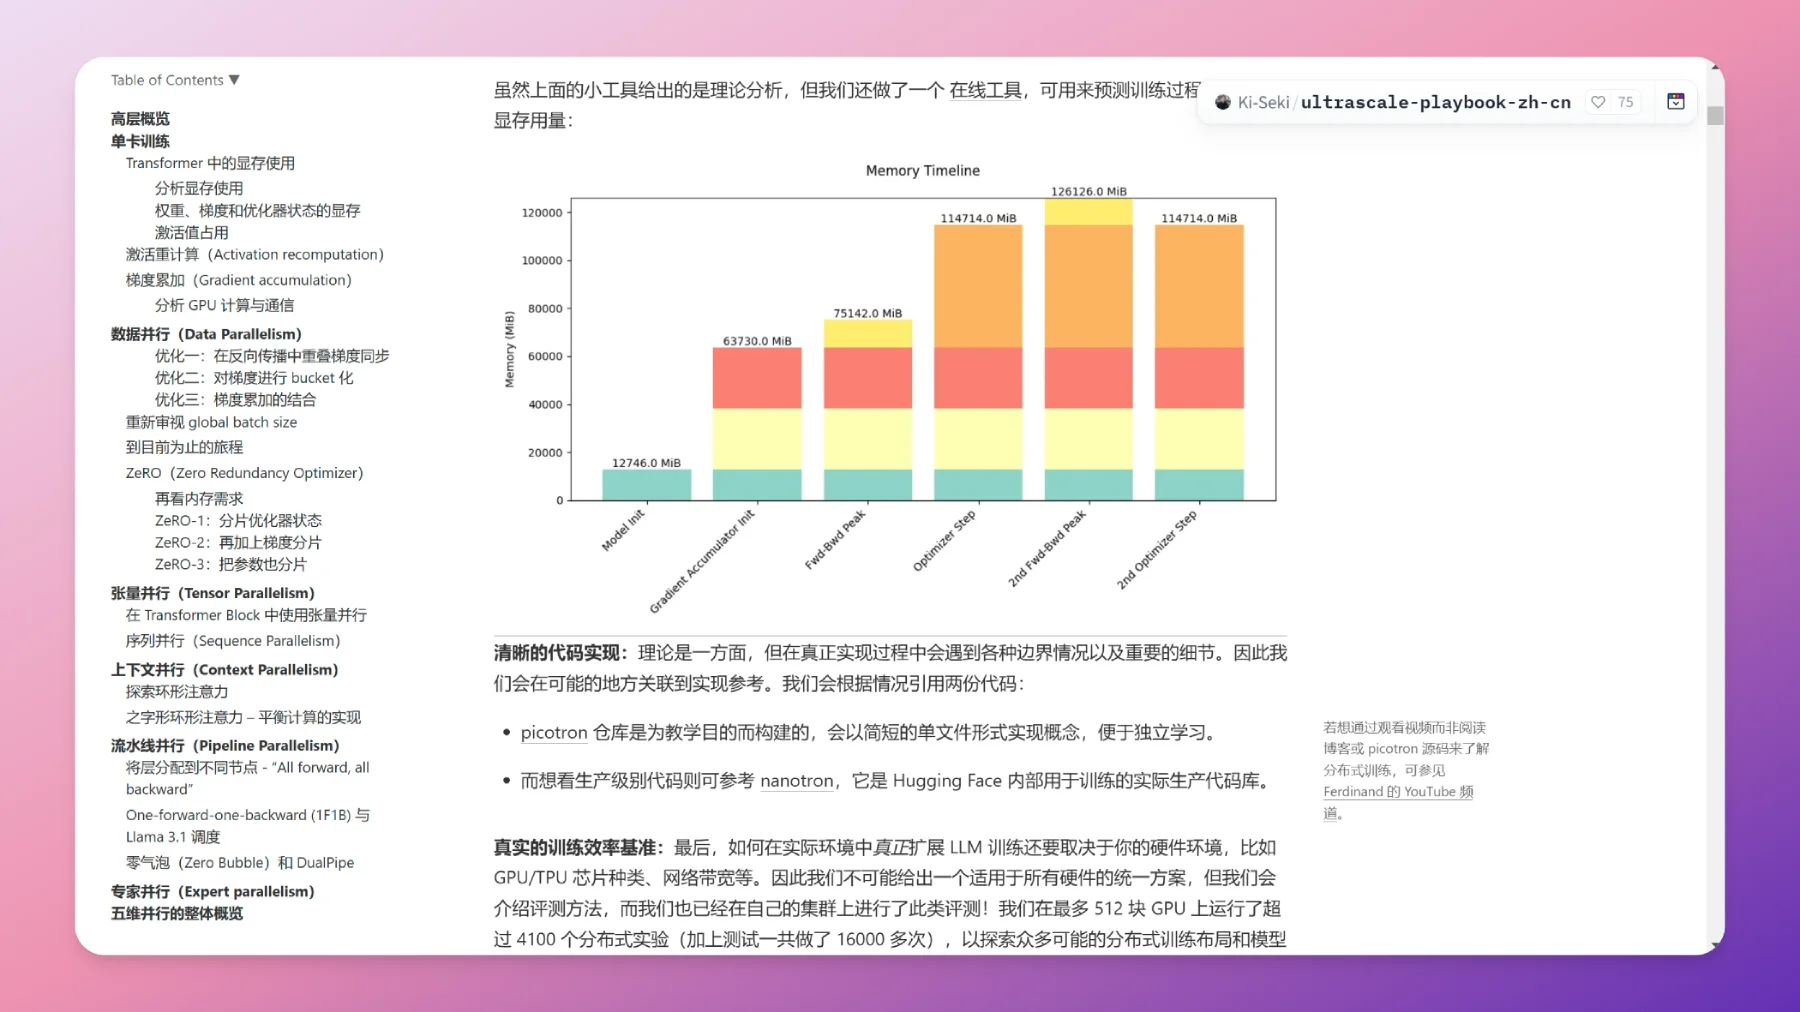
Dirección de la versión en chino de 终极训练指南:https://huggingface.co/spaces/Ki-Seki/ultrascale-playbook-zh-cn
Todavía en revisión...
Origen de la investigación
A medida que los modelos de lenguaje se vuelven cada vez más grandes, la demanda de recursos computacionales durante el entrenamiento aumenta y las estrategias se vuelven más complejas. Por ello, este documento se centra principalmente en cómo llevar a cabo el entrenamiento de grandes modelos de lenguaje (LLM) en clústeres de hasta 512 GPUs.
Contenido destacado
Registros experimentales masivos
El documento registra en detalle 4000 experimentos de escalado. En estos experimentos, las métricas clave son el rendimiento (tamaño de los tokens) y la utilización de la GPU (color de los tokens). Estos datos proporcionan un soporte fiable para la optimización del proceso de entrenamiento.
Principales contenidos experimentales
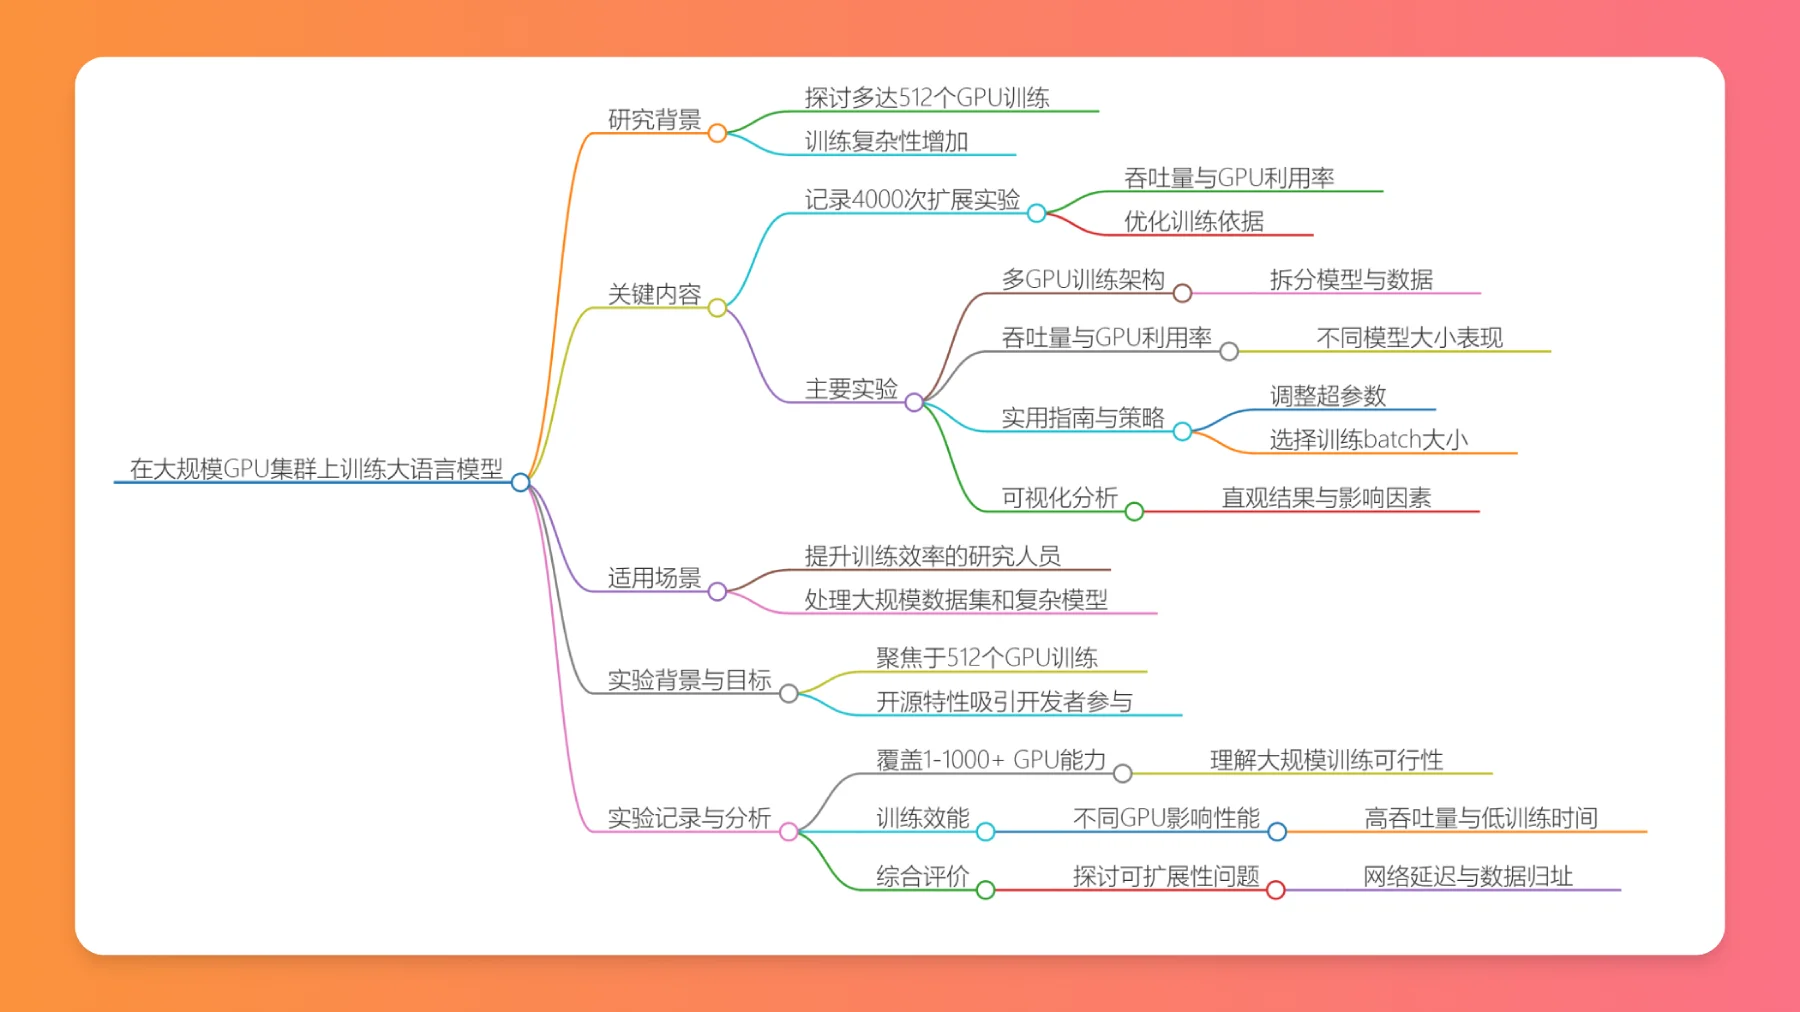
Arquitectura de entrenamiento multi-GPU: la arquitectura adoptada puede dividir eficazmente el modelo y los datos, permitiendo que múltiples GPUs procesen tareas relacionadas en paralelo, lo que sienta las bases arquitectónicas para un entrenamiento eficiente.
Rendimiento y utilización de la GPU: a través del análisis de datos de experimentos reales, el rendimiento varía según los distintos tamaños de modelo. Este tipo de análisis ayuda a los desarrolladores a comprender cómo aprovechar al máximo los recursos y, de este modo, encontrar el método de entrenamiento que mejor se adapte a sus necesidades.
Guías prácticas y estrategias: se resumen estrategias de entrenamiento prácticas, por ejemplo, cómo ajustar los hiperparámetros y elegir el tamaño de batch de entrenamiento adecuado. Todo ello es fundamental para lograr el mejor rendimiento.
Análisis visualizado: el documento incluye numerosos resultados visualizados. Estos resultados permiten a los usuarios comprender de forma intuitiva los resultados de los experimentos de escalado y los factores subyacentes, facilitando la interpretación de resultados experimentales complejos.
A quién va dirigido
Esta guía es especialmente adecuada para investigadores e ingenieros que deseen mejorar la eficiencia del entrenamiento de grandes modelos de lenguaje, en particular cuando trabajan con conjuntos de datos a gran escala y modelos complejos.
Consideraciones relacionadas con los experimentos
Características y objetivos del documento
Este documento no sólo explica cómo entrenar en 512 GPUs, sino que también hace énfasis en su naturaleza de código abierto. Esto permite que más desarrolladores puedan participar y aplicar estos métodos de entrenamiento.
Alcance de los registros experimentales
El alcance de los registros experimentales se extiende desde 1 GPU hasta la capacidad de escalado de más de 1000 GPUs. Esto conforma un marco integral que ayuda a comprender si es viable y eficiente entrenar LLMs en clústeres a gran escala.
Análisis del rendimiento del entrenamiento
Al observar el impacto que tiene el número de GPUs en el rendimiento del entrenamiento, los autores descubrieron que algunos modelos pueden alcanzar un mayor rendimiento y un menor tiempo de entrenamiento durante el proceso de escalado. Este hallazgo puede proporcionar recomendaciones más específicas a los desarrolladores a la hora de elegir el número y la configuración de GPUs.
Factores de consideración integral
Además de centrarse en los indicadores de rendimiento, este experimento también profundiza en cuestiones de escalabilidad en aplicaciones reales. Asimismo, estudia algunos desafíos que pueden surgir en entornos reales, como la latencia de red y el direccionamiento de datos, que son factores complejos que no pueden pasarse por alto al llevar a cabo entrenamientos a gran escala.









