
 Asistente de guiones▸
 Apps AI
 Noticias AI
OSUM: modelo de voz de código abierto de la Universidad Politécnica Northwestern compatible con múltiples tareas de procesamiento de voz
小编 ·

OSUM: modelo de voz de código abierto de la Universidad Politécnica Northwestern compatible con múltiples tareas de procesamiento de voz
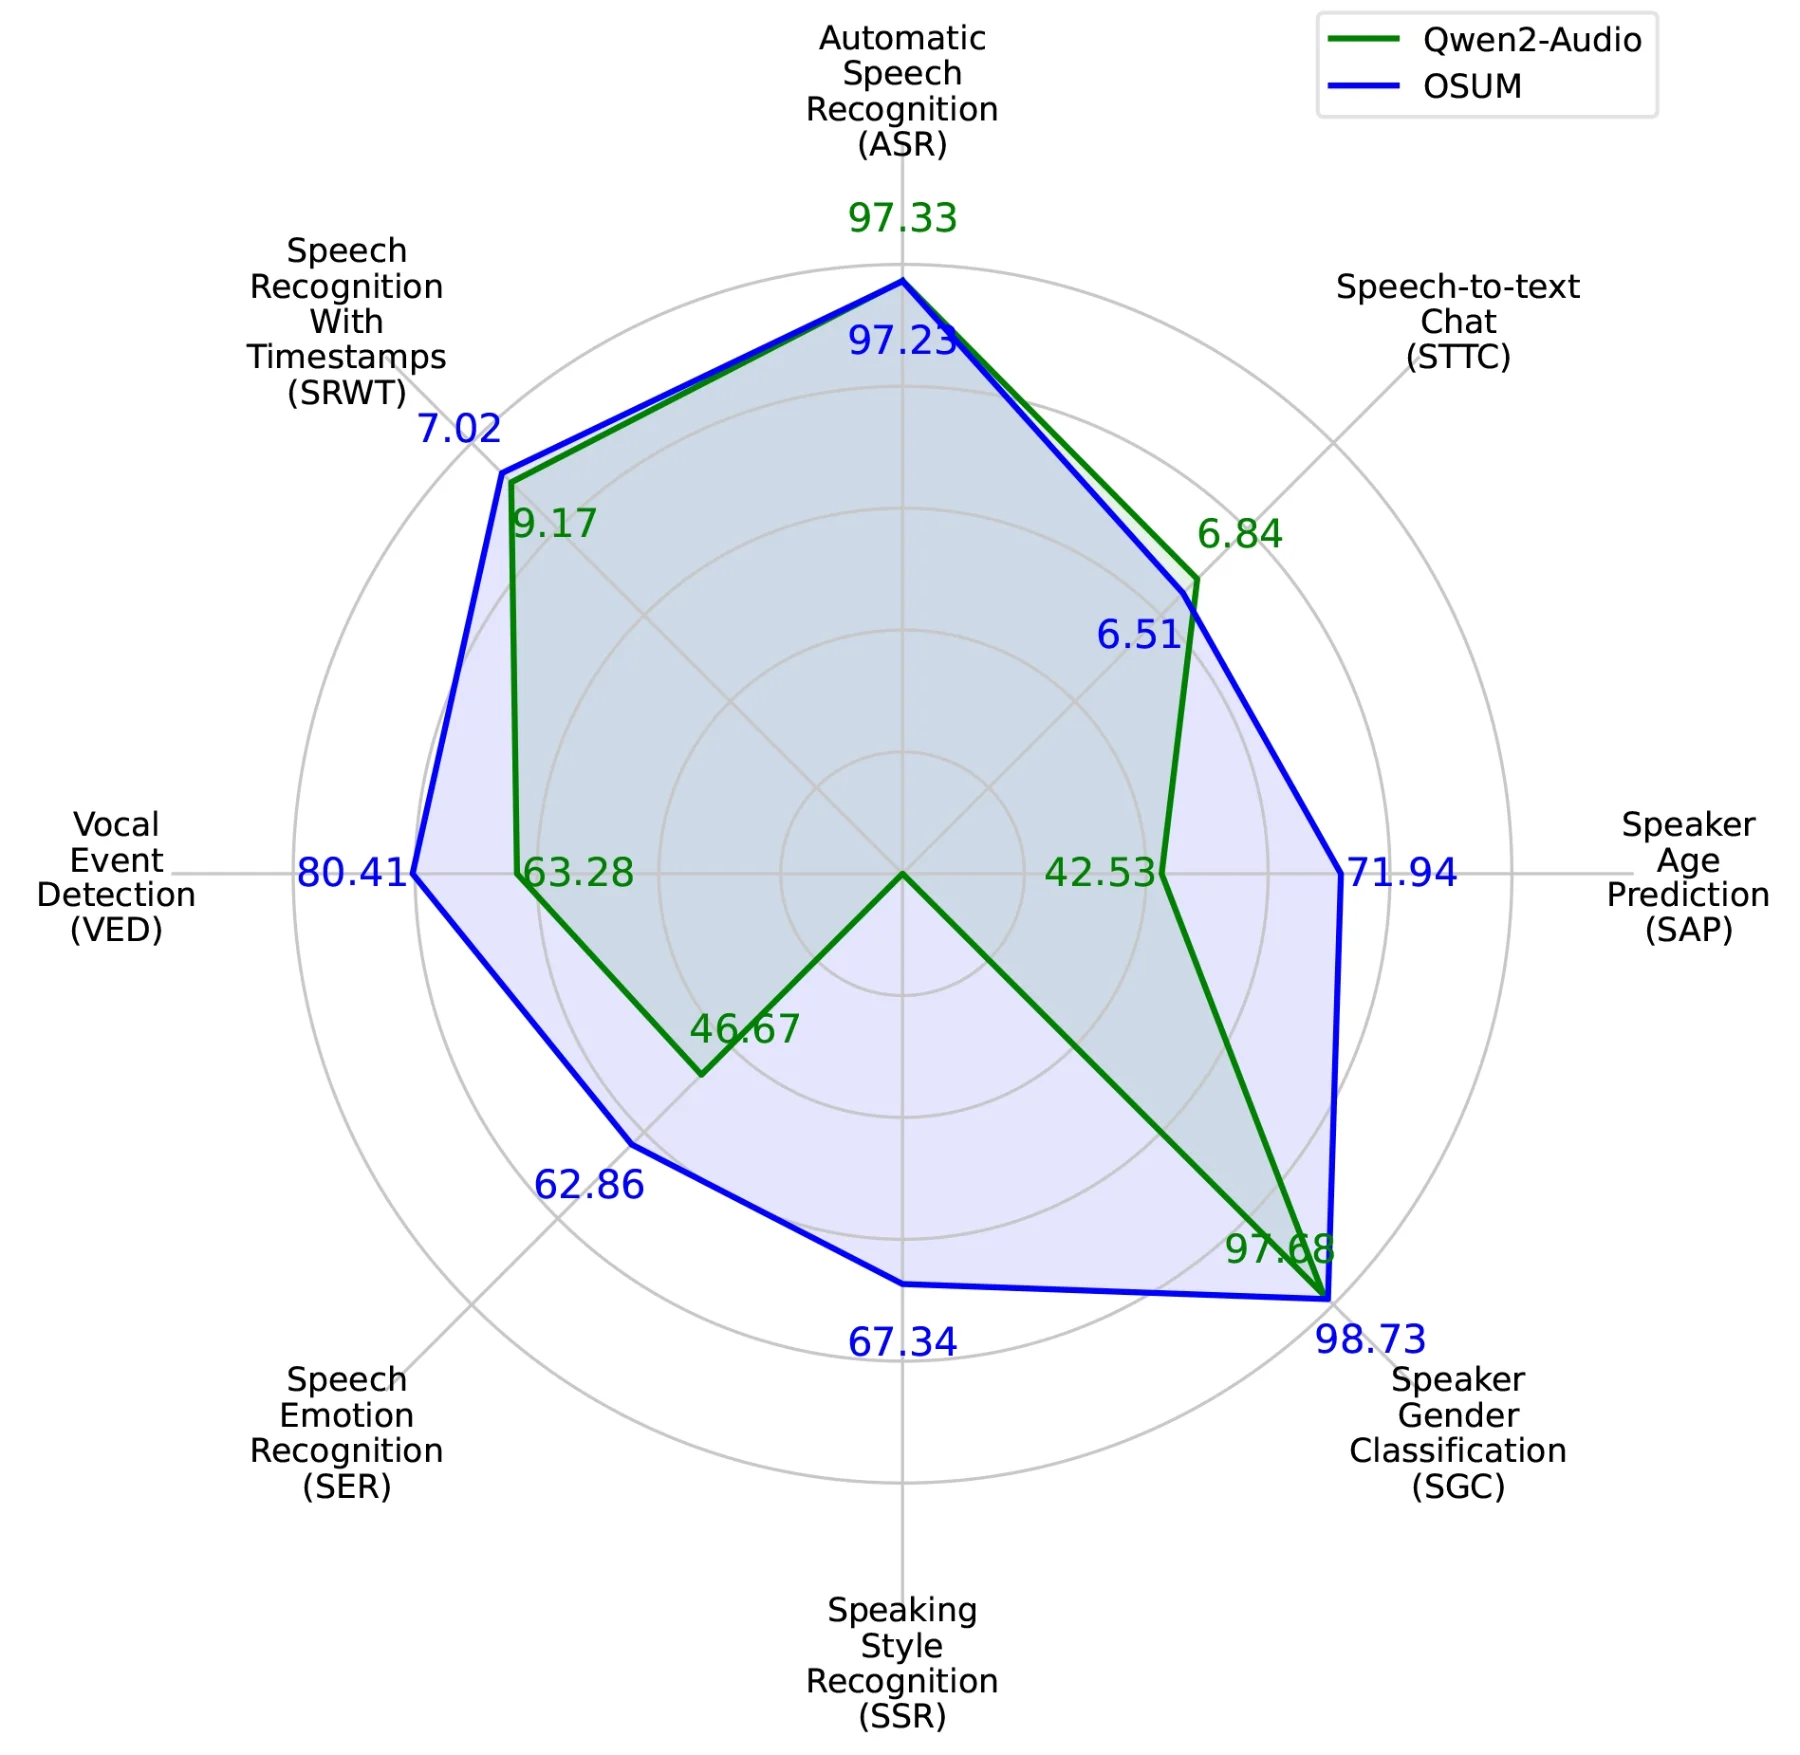
OSUM (Open Speech Understanding Model) es un modelo de voz propuesto y de código abierto por el Grupo de Procesamiento de Audio, Voz y Lenguaje (ASLP@NPU) de la Escuela de Ciencias y Tecnologías de la Computación de la Universidad Politécnica del Noroeste, diseñado para soportar múltiples tareas de procesamiento de voz.
Características de OSUM:
Soporte multitarea:
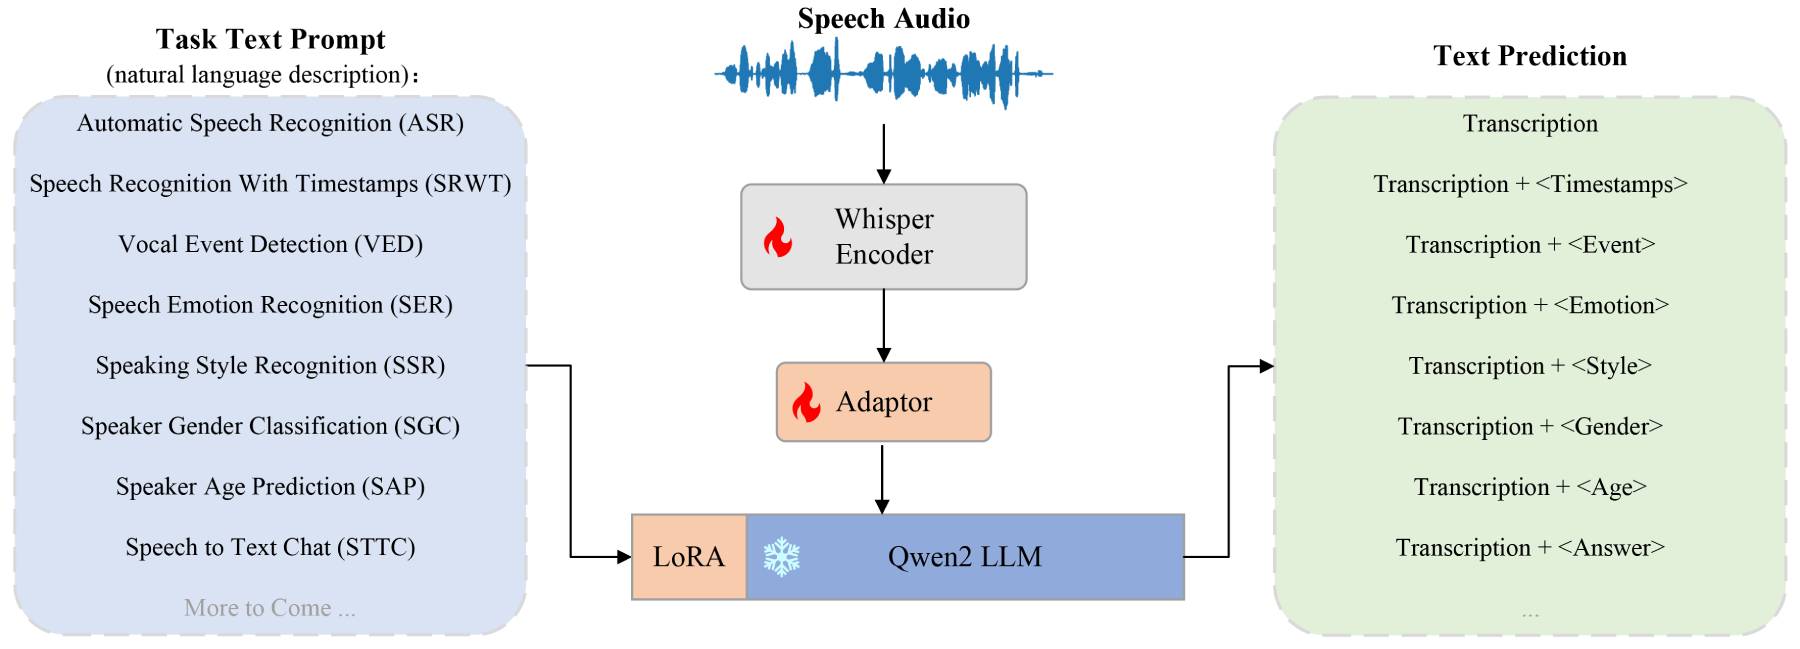
Reconocimiento de voz (ASR): convierte la voz en texto.
Reconocimiento de voz con marcas de tiempo (SRWT): reconoce el contenido de voz y anota la información temporal.
Detección de eventos de voz (VED): identifica eventos o acciones específicos en la voz.
Reconocimiento de emociones en el habla (SER): analiza el estado emocional en la voz.
Reconocimiento del estilo del habla (SSR): identifica la forma o el tono del hablante.
Clasificación de género del hablante (SGC): determina el género del hablante a partir de la voz.
Predicción de la edad del hablante (SAP): estima la edad del hablante.
Conversación de voz a texto (STTC): convierte diálogos de voz en texto legible.
Arquitectura del modelo: OSUM combina el codificador Whisper y el modelo de lenguaje grande Qwen2 (LLM), utilizando la técnica LORA para ajustar el LLM, logrando así un entrenamiento multitarea eficiente.
Estrategia de entrenamiento: adopta la estrategia de entrenamiento ASR+X, que optimiza simultáneamente el reconocimiento automático de voz (ASR) y tareas secundarias (X), logrando un entrenamiento multitarea eficiente y estable, y reduciendo el consumo de recursos.
Función de comprensión profunda: el modelo OSUM tiene la capacidad de convertir información de voz en texto y, al mismo tiempo, soporta el reconocimiento de emociones en la voz, ofreciendo a los usuarios una experiencia de interacción más inteligente.
Soporte de marcas de tiempo: en el reconocimiento de voz, OSUM proporciona resultados con marcas de tiempo, lo que facilita el procesamiento y análisis posterior.
Compatibilidad multiplataforma: soporta su ejecución en diferentes plataformas de cómputo, incluyendo Huawei Ascend 910B y plataformas NVIDIA, lo que aumenta la flexibilidad de sus aplicaciones.
Aplicaciones de OSUM:
Asistentes inteligentes: en hogares inteligentes y asistentes virtuales, para comprender y responder a los comandos de voz de los usuarios.
Servicios multilingües: al igual que el complemento YouTube Dubbing, se puede utilizar para traducción y doblaje en tiempo real, eliminando las barreras lingüísticas.
Análisis de emociones: en atención al cliente y aplicaciones de salud mental, para analizar el estado emocional del usuario y ofrecer servicios personalizados.
Ámbito educativo: evalúa automáticamente las tareas orales de los estudiantes y proporciona retroalimentación.
Tecnología de accesibilidad: ayuda a las personas con discapacidad auditiva a comprender la información de voz.
Investigación de mercado: analiza emociones y opiniones en los comentarios de los consumidores.
Transcripción de voz: en situaciones como actas de reuniones o conversión de texto dictado, OSUM permite una transcripción de voz eficiente.
Cómo usar OSUM:
Instalación e importación: los usuarios pueden descargar el código y los pesos del modelo OSUM desde la página de Hugging Face o la página del proyecto en GitHub, y seguir la guía de instalación proporcionada. Un ejemplo de código para importar el modelo OSUM en un entorno Python es el siguiente:
from osum import OSUM
model = OSUM.from_pretrained("ASLP-lab/OSUM")
Ejecución de tareas: los usuarios pueden utilizar el modelo OSUM para realizar diversas tareas de voz, como el reconocimiento de voz. A continuación, un ejemplo de código para una tarea de reconocimiento de voz:
result = model.transcribe("audio.wav")
print(f"识别结果:{result}")
En cuanto al método de uso, los usuarios también pueden aprovechar los checkpoints del modelo preentrenado para realizar ajustes finos, mejorando aún más el rendimiento del modelo en tareas específicas.
GitHub: https://github.com/ASLP-lab/OSUM
项止:https://aslp-lab.github.io/OSUM.github.io/









