
 Asistente de guiones▸
 Apps AI
 Noticias AI
SWE-Lancer: el benchmark de código abierto de OpenAI para evaluar capacidades de ingeniería de software
小编 ·

SWE-Lancer: el benchmark de código abierto de OpenAI para evaluar capacidades de ingeniería de software
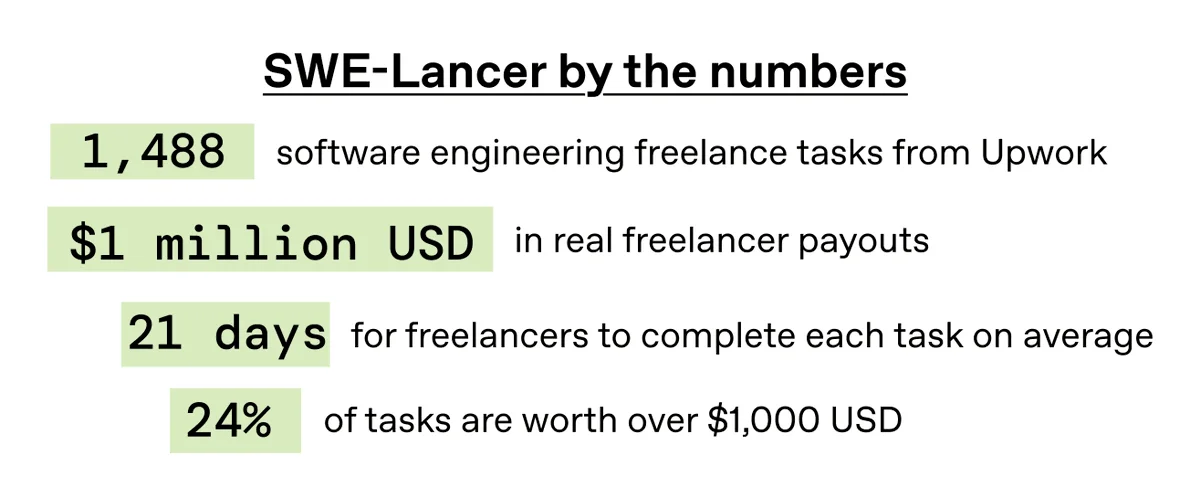
SWE-Lancer es un benchmark lanzado por OpenAI, cuyo objetivo principal es evaluar el rendimiento de los modelos en tareas de ingeniería de software de código abierto. Esta prueba recopila más de 1400 tareas de Upwork, con un valor total aproximado de un millón de dólares. SWE-Lancer se centra en evaluar los parches de código y las decisiones de gestión, pidiendo a los modelos que elijan la mejor propuesta entre varias opciones, simulando de la forma más realista posible el trabajo cotidiano de un equipo de ingeniería.
Dimensiones principales de evaluación:
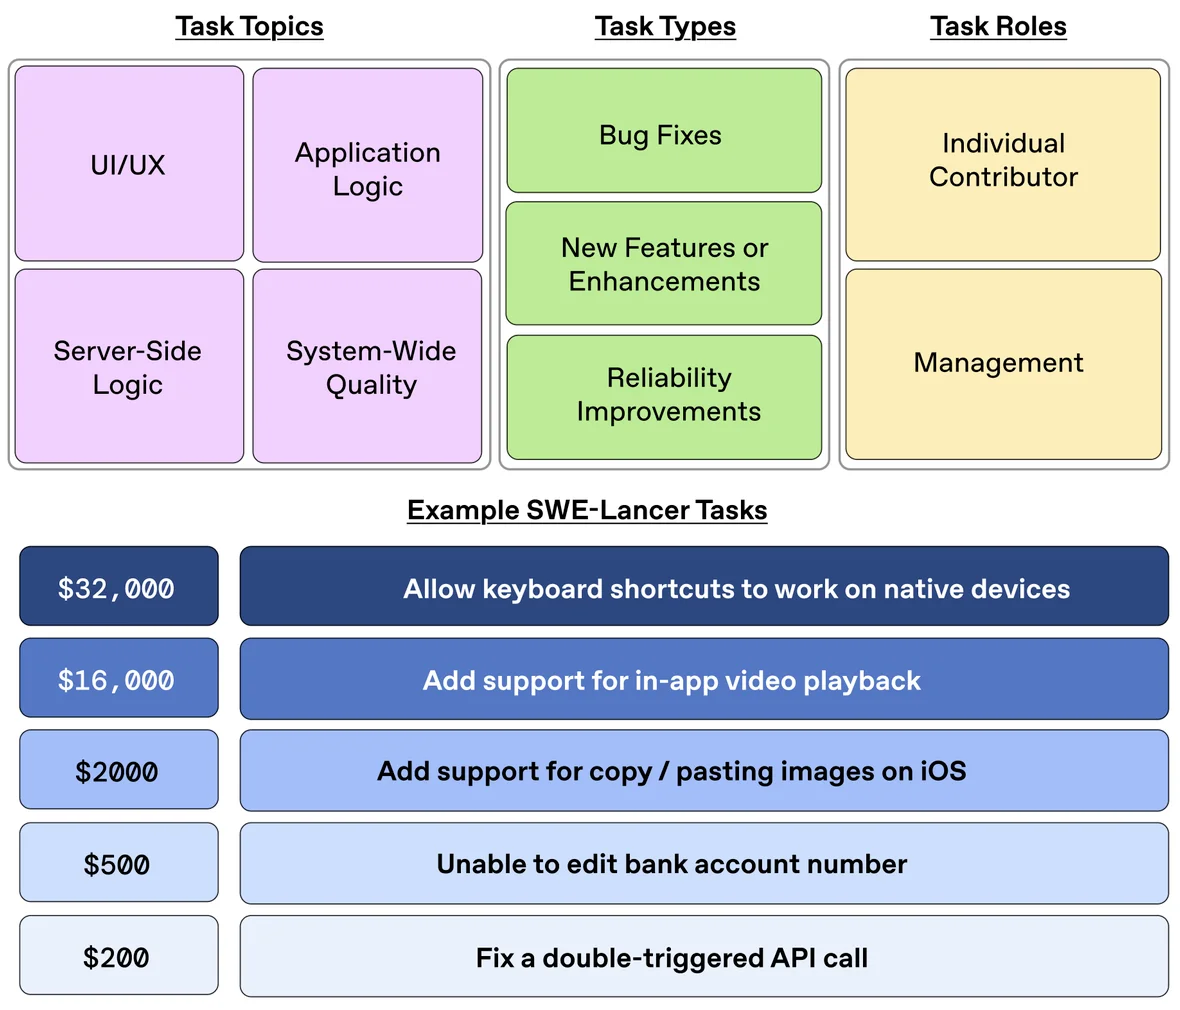
Diversidad de las tareas evaluadas
SWE-Lancer abarca una amplia variedad de tipos de tareas de desarrollo de software, lo que lo convierte en una herramienta muy eficaz para analizar las capacidades de los modelos. Exige que el modelo elija la mejor solución entre varias opciones propuestas, lo que permite que el benchmark refleje de forma más fiel el flujo de trabajo real de un equipo de ingeniería.
Evaluación del valor económico
Este benchmark no solo evalúa la capacidad técnica, sino que también tiene en cuenta el valor económico de las tareas. Este enfoque de evaluación abre una nueva perspectiva para medir la eficacia de los modelos en aplicaciones del mundo real, permitiendo a los desarrolladores comprender mejor el potencial impacto económico que los modelos de IA pueden aportar.
Características funcionales de SWE-Lancer:
Tareas del mundo real: SWE-Lancer incluye una serie de tareas reales de desarrollo de software, que abarcan desde pequeñas correcciones de errores hasta implementaciones de funcionalidades de gran envergadura, garantizando así una evaluación eficaz del modelo en escenarios reales de desarrollo.
Pruebas de extremo a extremo: a diferencia de las pruebas unitarias tradicionales, SWE-Lancer emplea pruebas de extremo a extremo, lo que exige al modelo la capacidad de abordar problemas completos, asemejándose más al proceso de toma de decisiones que sigue un ingeniero de software en su trabajo cotidiano.
Evaluación con múltiples opciones: el modelo debe elegir la mejor propuesta entre varias soluciones posibles, lo que simula el proceso de toma de decisiones de un equipo de ingeniería cuando se enfrenta a un problema.
Mapeo del valor económico: el valor total de las tareas asciende a un millón de dólares, lo que, por un lado, refleja la complejidad e importancia de las tareas y, por otro, muestra el potencial impacto económico derivado del rendimiento del modelo.
Aplicaciones de SWE-Lancer:
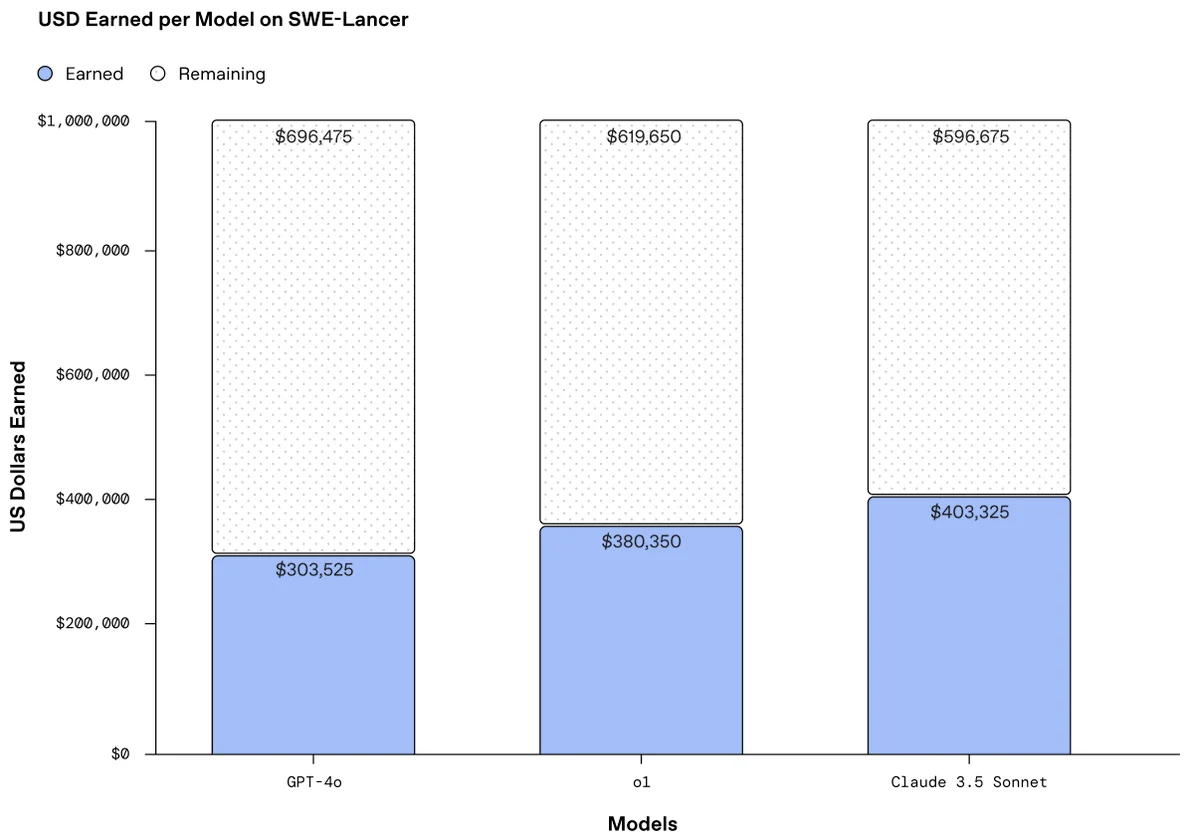
Evaluación del rendimiento de modelos: ofrece a investigadores y desarrolladores una plataforma de pruebas para evaluar y comparar el desempeño de modelos de lenguaje de gran tamaño en tareas de ingeniería de software.
Asistencia en el desarrollo de software: a largo plazo, SWE-Lancer podría ayudar a optimizar la aplicación de la inteligencia artificial en el desarrollo de software, por ejemplo, en la revisión automática de código y en la sugerencia de soluciones a errores.
Educación y formación: puede servir como herramienta didáctica para ayudar a estudiantes y desarrolladores a comprender las buenas prácticas y los desafíos de la ingeniería de software.
Estándar del sector: tiene potencial para convertirse en un estándar de la industria para evaluar la utilidad de la inteligencia artificial en el ámbito de la ingeniería de software.
Cómo utilizar SWE-Lancer:
Seleccionar tareas: elige una o varias tareas de la lista proporcionada por SWE-Lancer para evaluar.
Procesamiento por el modelo: introduce las tareas seleccionadas en el modelo de inteligencia artificial; el modelo las ejecutará en función de su entrenamiento y sus capacidades.
Evaluación de resultados: evalúa los resultados generados por el modelo para comprobar si cumplen los estándares de calidad preestablecidos y analízalos también en función del valor económico de la tarea.
Artículo:https://arxiv.org/abs/2502.12115
Más información:https://openai.com/index/swe-lancer/









