
 Asistente de guiones▸
 Apps AI
 Noticias AI
NSA: la técnica de DeepSeek para acelerar el entrenamiento y la inferencia con contextos ultralargos
小编 ·

NSA: la técnica de DeepSeek para acelerar el entrenamiento y la inferencia con contextos ultralargos
El equipo de DeepSeek presentó el 18 de febrero de 2025 un mecanismo de atención innovador llamado NSA (Native Sparse Attention). NSA está diseñado para abordar los obstáculos de eficiencia computacional y rendimiento que se encuentran en el procesamiento de textos largos. Gracias a un diseño coherente con el hardware y al soporte de entrenamiento nativo, esta tecnología puede aumentar significativamente la velocidad de inferencia y reducir los costes de preentrenamiento.
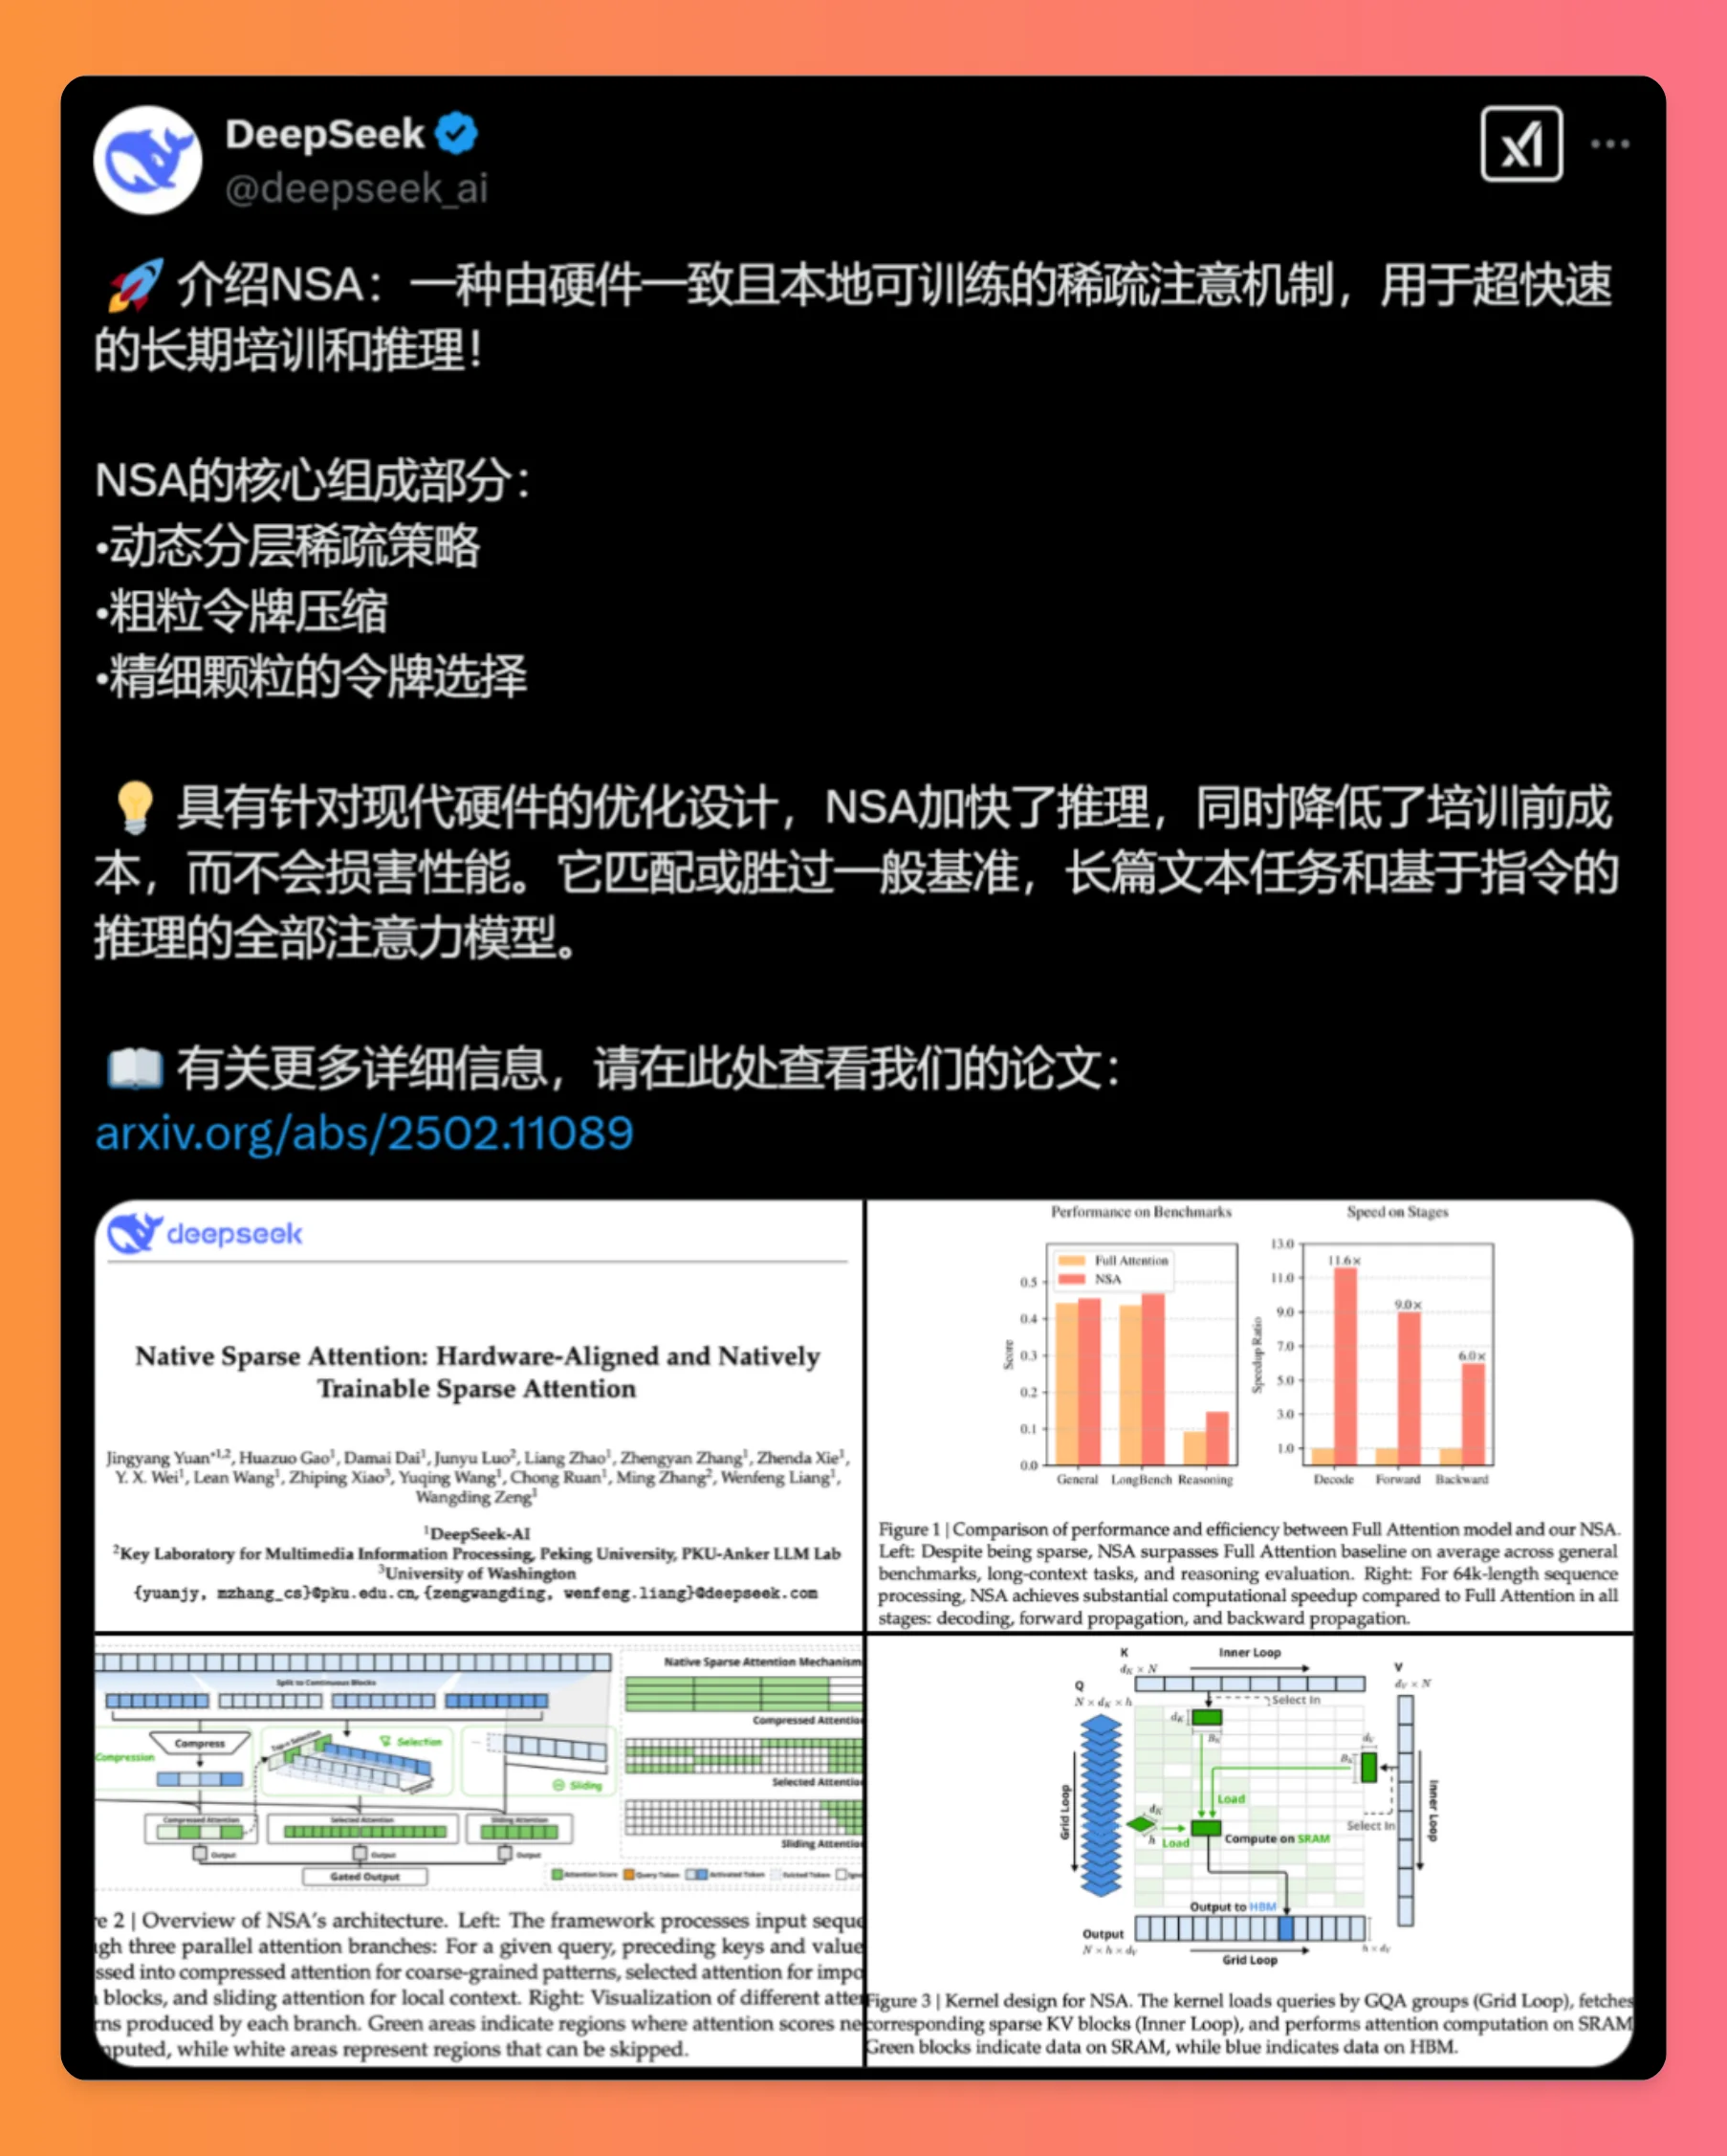
Características principales de NSA:
Amigable con el hardware: se ha diseñado teniendo en cuenta la compatibilidad con diversas arquitecturas de hardware, con el objetivo de mejorar la eficiencia del entrenamiento.
Capacidad de entrenamiento local: admite el entrenamiento directamente sobre los datos, lo que aumenta la adaptabilidad y flexibilidad del modelo.
Inferencia y entrenamiento eficientes: acelera el procesamiento de contextos largos, facilita la aplicación de modelos complejos y permite abordar con eficacia datos de secuencias más largas, como textos y vídeos.
Estrategia de dispersión jerárquica dinámica: utiliza técnicas de selección de tokens de grano fino y compresión de tokens de grano grueso para reducir la complejidad computacional a la vez que se conserva la información.
Reducción de costes: gracias a un diseño optimizado, reduce significativamente el consumo de recursos al entrenar modelos de aprendizaje profundo, incluyendo el tiempo y los costes computacionales, lo que resulta de gran valor para investigadores y desarrolladores.
Componentes principales de NSA:
Estrategia de dispersión jerárquica dinámica: combina la compresión de tokens de grano grueso y la selección de tokens de grano fino, mejorando la eficiencia y garantizando al mismo tiempo la percepción del modelo sobre el contexto global y los detalles locales.
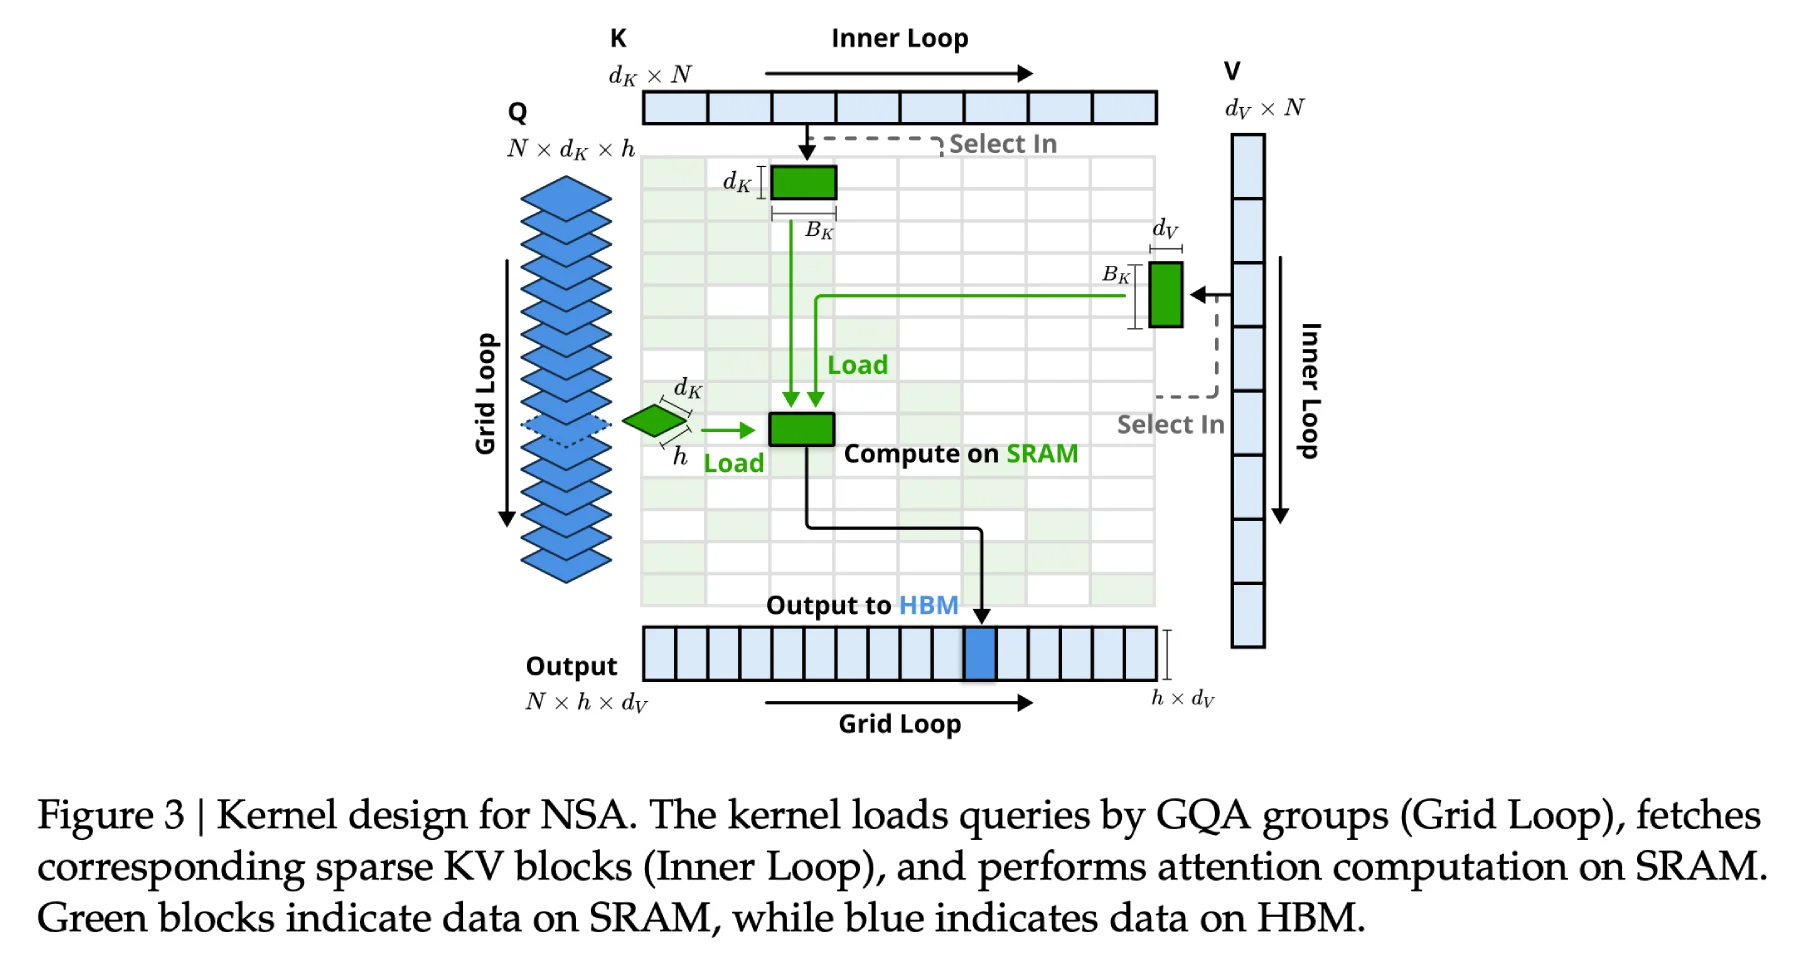
Diseño alineado con el hardware: optimiza el acceso a memoria, se adapta a los núcleos tensoriales de las GPU, carga datos por bloques, reduce las transferencias redundantes y mejora la eficiencia del paralelismo.
Entrenable de extremo a extremo: admite todo el flujo de cálculo disperso, desde el preentrenamiento hasta la inferencia, manteniendo la estabilidad de la retropropagación y evitando el problema de "rezago en el entrenamiento" propio de los métodos dispersos tradicionales.
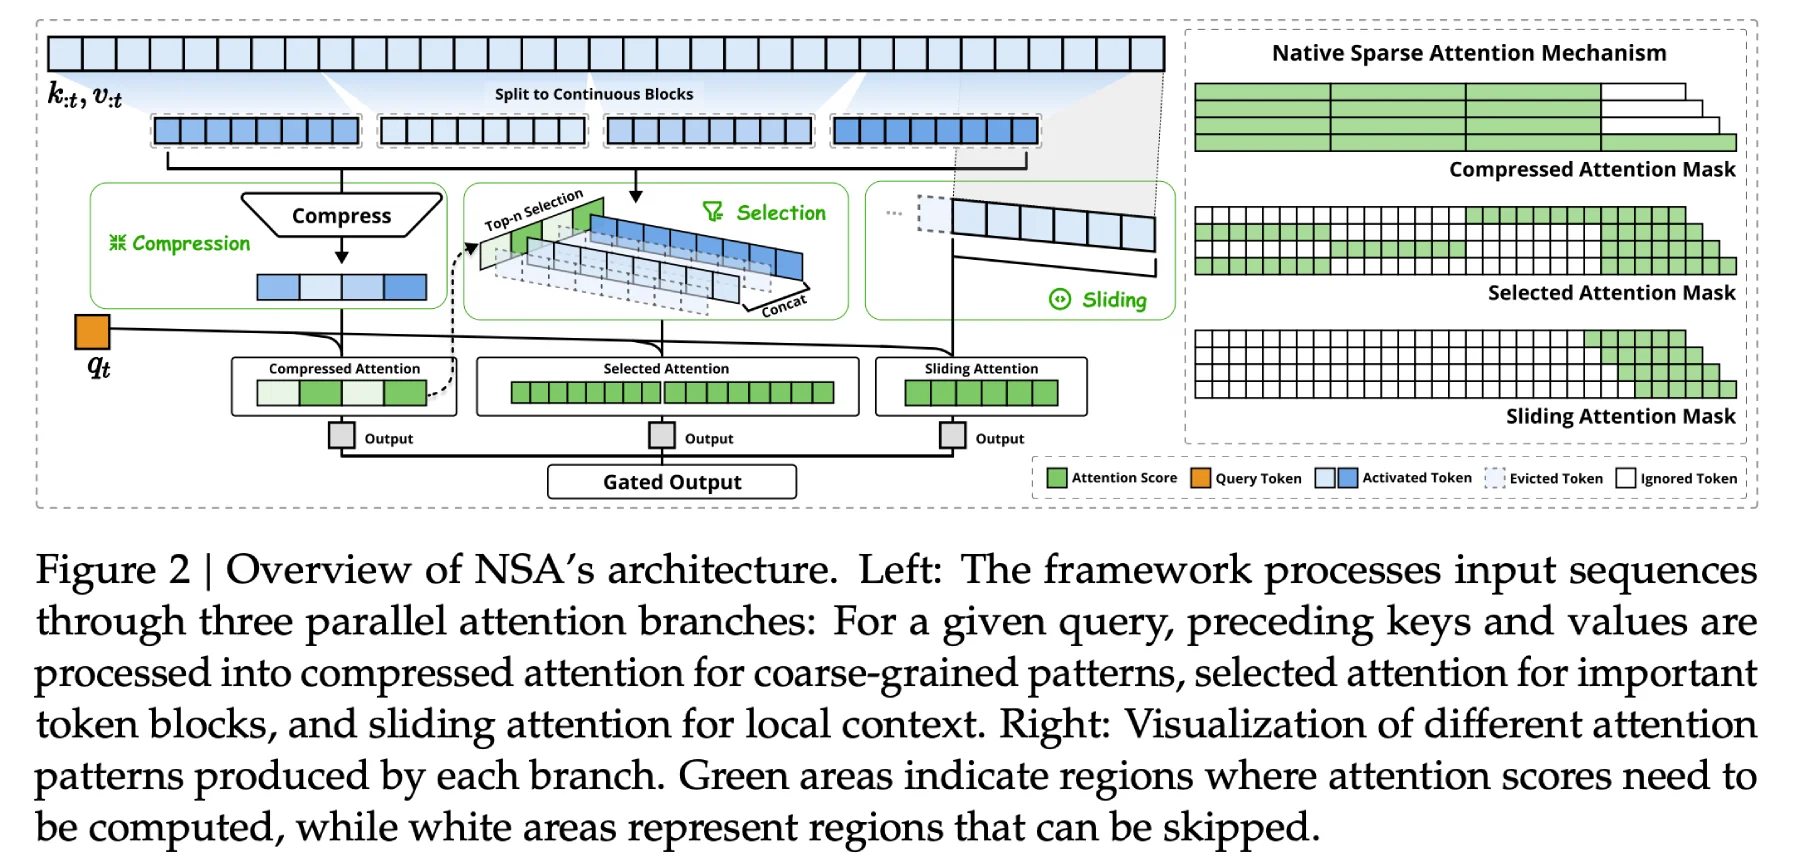
Detalles técnicos de NSA:
Estrategia de dispersión jerárquica dinámica: determina de forma flexible la información clave y la información prescindible, optimizando el procesamiento de la información, garantizando que el modelo capte la semántica global esencial al manejar contextos largos y reduciendo al mismo tiempo la carga computacional.
Compresión de tokens de grano grueso: integra tokens similares o poco importantes para reducir el volumen de datos procesados y acelerar el cálculo, manteniendo al mismo tiempo la comprensión semántica de grano grueso del texto.
Selección de tokens de grano fino: filtra aún más los tokens importantes dentro de los datos comprimidos, asegurando que el modelo preste atención a los detalles, mantenga la precisión local y evite la pérdida de información relevante.
Ventana deslizante: utiliza un mecanismo de ventana deslizante para capturar información de contexto local y evitar que se pasen por alto las relaciones entre elementos cercanos.
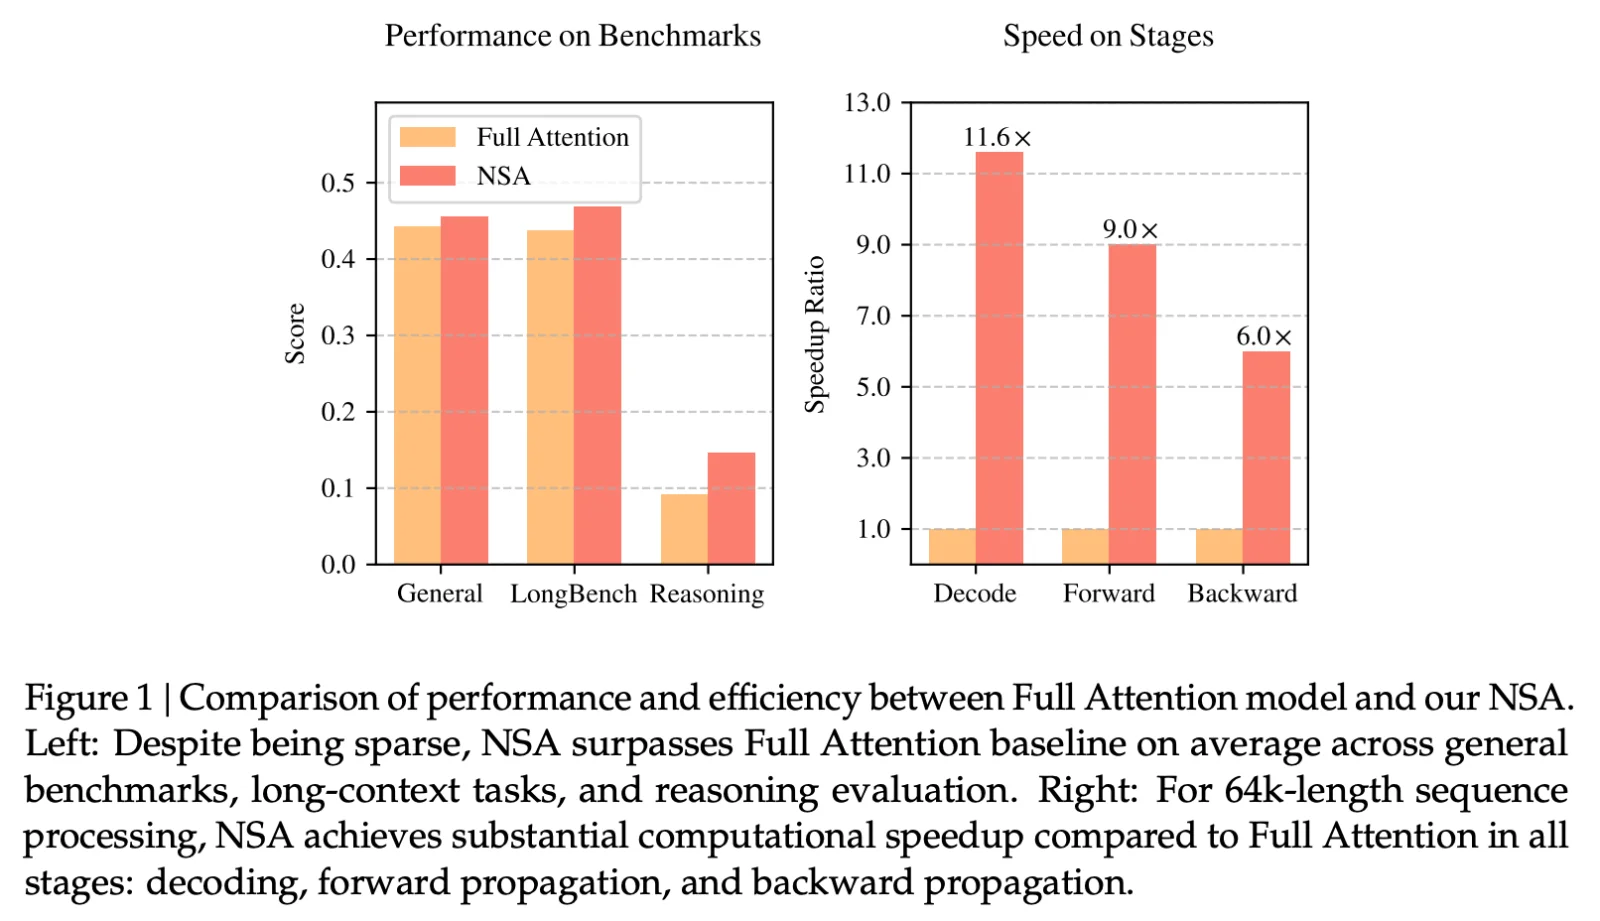
Resultados de rendimiento de NSA:
Mejora de velocidad: al procesar secuencias de longitud 64k, NSA logra mejoras de velocidad significativas en las fases de decodificación, propagación hacia adelante y propagación hacia atrás, llegando hasta 11,6 veces más rápido.
Rendimiento superior: en múltiples pruebas de referencia, NSA rinde de forma comparable o incluso superior a los modelos de atención completa, especialmente en tareas de contexto largo y razonamiento siguiendo instrucciones.
Áreas de aplicación de NSA:
Asistentes inteligentes: permite conversaciones multi-turno más complejas y servicios personalizados.
Computación científica: por ejemplo, el procesamiento de secuencias de datos largas en simulaciones físicas y modelado de ingeniería.
Generación y depuración de código: comprensión de grandes bases de código y generación de soluciones de alta calidad.
Artículo de NSA:https://arxiv.org/abs/2502.11089
DeepSeek es una empresa china centrada en la inteligencia artificial general, dedicada a descubrir las tecnologías clave de la AGI y llevarlas a productos. DeepSeek ha lanzado varios modelos de gran tamaño de IA de código abierto y alto rendimiento, como DeepSeek-V2, que admite la comprensión de textos largos con un contexto de 128k, y DeepSeek-R1-Lite-Preview, que ofrece un rendimiento destacado en la evaluación MT-Bench en chino.









